什么是 AI 口型同步?
AI 口型同步,是让 AI 自动把图片或视频里人物的嘴型,对准一段音频的技术。AI 会分析音频波形,识别音素和语速节奏,再逐帧把对应的嘴型画到人脸上。
影视创作者、营销人员、内容创作者和教育工作者,常用它来给视频配音、制作口播广告、让角色开口说台词,或者把内容本地化成其他语言,而不必重新拍摄。
过去做口型同步,要么逐帧手绘动画,要么靠昂贵的动作捕捉。现在几步点击就够了。你只需提供人脸(照片或视频片段)和音频,AI 就会生成一段人物自然开口说话的视频。
开始之前需要准备什么
制作 AI 口型同步视频,需要三样东西:一张要驱动的人脸、一段要对齐的音频,以及一个 Morphic 账号。人脸可以是视频片段,也可以是静态图片,取决于你选的模型。音频最好是干净的人声,背景噪音越少越好。
| 输入 | 什么效果最好 | 尽量避免 |
|---|---|---|
| 视频(Sync V3、Seedance 2.0) | 人脸构图清晰,全程能看到嘴部,头部动作不大,动作自然 | 频繁切镜、极端角度,或人脸被遮挡、出画 |
| 图片(LTX 2.3、Veed Fabric) | 高分辨率照片,人脸朝向镜头,面部光线均匀 | 画面模糊、侧脸,或人脸被裁切、处在阴影里 |
| 音频 | 人声干净,单人说话,音量稳定,背景噪音小 | 多人同时说话、人声下垫着很响的音乐,或带杂音的低质量录音 |
有个简单的判断办法:嘴型看得清,字也听得清,同步效果一般就不会差。
用 Morphic 制作 AI 口型同步视频
照着下面六步,就能从头到尾做出一段口型同步视频。
打开 Morphic
打开 Morphic,进入已有文件,或点击“New file”在某个项目下新建文件。从添加参考素材到生成成片,都在这块 Canvas 上完成。
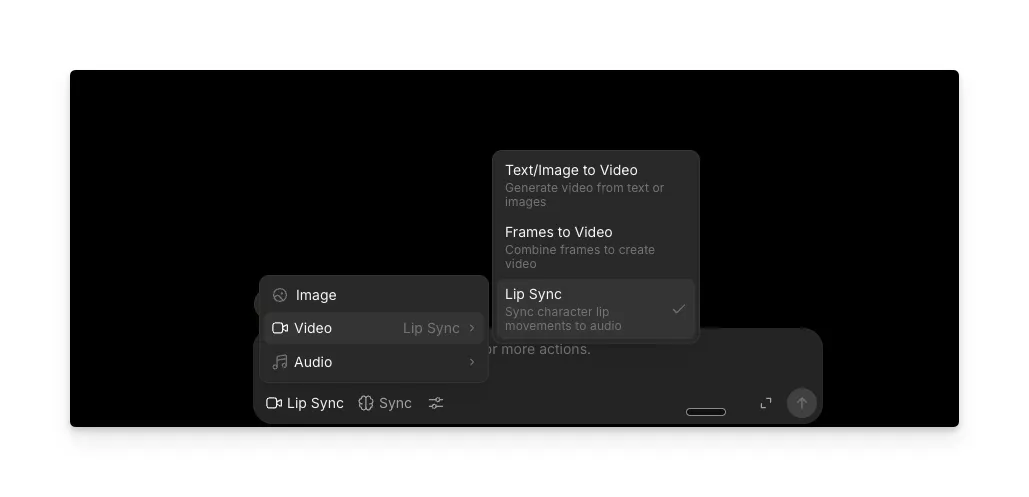
切换到视频模式,选择 Lip Sync
在 Canvas 底部找到全局提示栏,把模式切换成视频,再从选项里选择 Lip Sync。这样 Morphic 就知道,你要的是让嘴型对齐音频,而不是从零生成视频。
选择 AI 模型
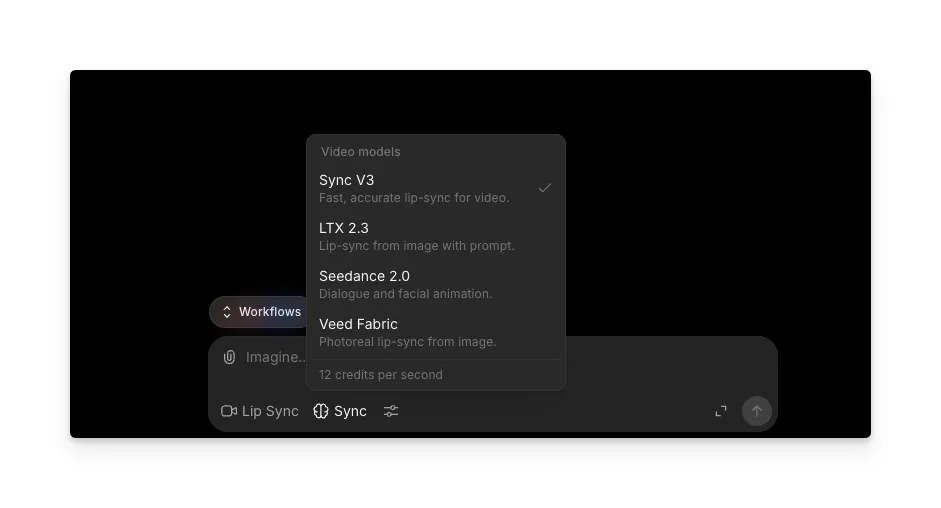
Morphic 提供四个口型同步模型,各自支持的输入不同,成片风格也不一样。
| 模型 | 输入类型 | 最适合 |
|---|---|---|
| Sync V3 | 视频 | 给真实素材和以对白为主的场景快速、精准地对口型 |
| LTX 2.3 | 图片 | 用一张静态照片加文字提示词,生成口型同步视频 |
| Seedance 2.0 | 视频 | 为动画或风格化角色制作对白和面部动画 |
| Veed Fabric | 图片 | 把静态照片变成面部动作自然、风格写实的口型同步视频 |
手上有现成素材,选 Sync V3,出片快、对得准。只有一张照片、想让它开口说话,就用 LTX 2.3 或 Veed Fabric,它们会驱动人脸动起来。动画或风格化内容,Seedance 2.0 最合适。
添加图片或视频,再添加音频
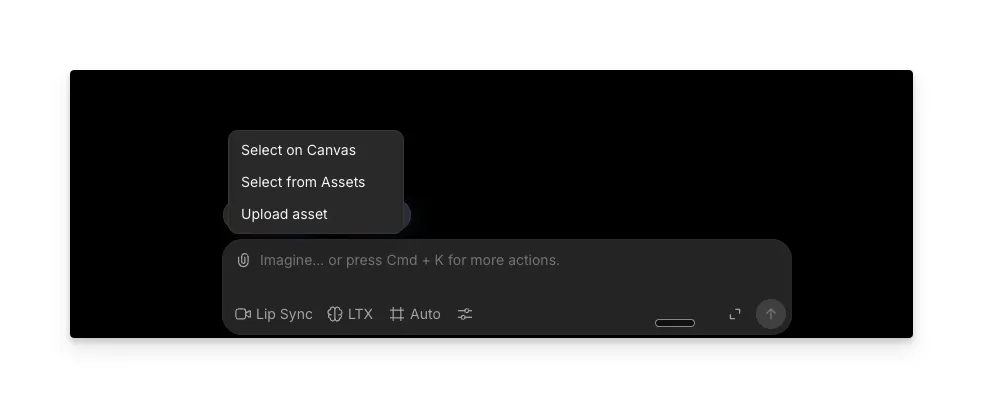
点击提示栏里的回形针图标来添加参考素材,有三种方式:
- Select on Canvas:选取已经放在 Canvas 上的素材
- Select from Assets:从素材库里挑选
- Upload asset:从你的设备上传文件
先添加图片或视频,再添加要对齐的音频文件。
补充提示词(可选)
你可以输入提示词,给生成过程多一些指引,也可以留空,让 AI 只根据输入素材来处理。
有一点要注意:用 Seedance 2.0 时,生成前必须填写至少 3 个字符的提示词。哪怕只写“让人物说出音频内容”也行。LTX 2.3 也建议写得具体一些,因为它会根据文字来决定图片怎么动。
开始生成
点击生成,等待输出。处理时间取决于音频长度和所选模型。完成后,你可以直接在 Canvas 上预览,然后下载,或继续编辑。
成片质量很大程度上取决于输入素材的质量。如果口型看着不对,回头看看下面的小技巧,检查音频或原始素材还有没有改进的余地。
提升 AI 口型同步效果的小技巧
输入文件稍作优化,成片就会有明显提升。下面这些技巧对四个模型都适用。
- 让人脸清晰入镜。 用视频时,保证整段里都能看到嘴部。用图片时,选正面照,让人脸占画面的较大比例。
- 使用干净的音频。 背景噪音、多人同时说话、对白下垫着很响的音乐,都会削弱同步效果。尽量在安静的环境录音,或上传前先降噪。
- 让声音和角色气质相符。 一个平静中性的人像,配上高能量、语速很快的旁白,即便口型本身没问题,看着也会违和。声音和画面要像是同一个人。
- 音频和视频时长尽量接近。 两者差距太大,AI 就得拉伸、循环或裁剪内容,成片会变得不够清晰。
- 源视频里少转头。 动作有限而自然,同步最稳。快速转头和极端角度,会让 AI 更难追踪并驱动嘴型。
- 用 Seedance 2.0 时务必写提示词。 哪怕只有“让人物说出音频内容”这样的短句,这个模型也必须有。写得越具体,效果越好。
- 用图片做口型同步时,分辨率要高。 原图细节越多,生成的面部动作就越自然。
AI 口型同步的应用场景
| 场景 | 你可以做什么 | 适合谁 |
|---|---|---|
| 配音与翻译 | 不用重拍,就能把视频本地化成其他语言:换掉音轨,重新对齐嘴型,发布到新市场。 | YouTube 创作者、做海外投放的品牌、为影视内容配音的制作团队 |
| 营销与广告 | 一次拍摄,产出口播广告、产品演示和 UGC 风格内容。换脚本重新生成多个版本,不必追加拍摄成本。 | 营销团队、电商品牌、做多语言投放的代理公司 |
| 影视与动画对白 | 给动画角色、AI 生成场景或风格化素材配上对白,快速验证对白场景,做出带配音的动态分镜。 | 电影人、动画师、短片和网络剧创作者 |
| 培训与教育 | 脚本变了,不用重拍培训视频:录好新的旁白,几分钟内重新对齐到原有画面。 | 培训团队、课程创作者、有入职或合规内容的企业 |
| 短视频内容 | 一张照片变成口播视频,做跟随热门音频的片段,或给旧素材换上新配音。适合抖音、视频号、小红书、B 站等平台。 | 短视频创作者、新媒体运营、独立内容创作者 |
常见问题
现代 AI 口型同步能做到逐帧的音素映射,成片与自然说话的节奏高度吻合。准确度取决于你的输入:人声干净、单人说话、人脸清晰可见时,效果最自然。音频质量差或人脸被遮挡时,不管用哪种工具,效果都会打折扣。在 Morphic 上,根据输入类型(视频还是图片)选对模型,也能明显提升准确度。
可以。有些 AI 模型能从一张静态照片出发,驱动人脸去匹配音轨。在 Morphic 上,LTX 2.3 和 Veed Fabric 都支持图片输入。上传照片,添加音频,AI 就会生成照片里的人开口说话的视频。手上没有视频素材,又需要一个能说话的角色来做广告、社交帖子或演示时,这很实用。
支持。AI 口型同步与语言无关,因为它是把音频波形对应到嘴型,而不是理解具体的词义。无论是普通话、粤语还是其他方言和口音,上传音频后,AI 都会据此对齐嘴型。做视频翻译、让内容走向不同市场时,这一点很实用。
可以,不过不同模型的效果有差异。针对写实素材设计的模型,遇到高度风格化或卡通角色时可能吃力。在 Morphic 上,Seedance 2.0 专为动画和风格化内容打造,是给非写实角色配对白的首选。
提供 AI 口型同步的平台不少。如果你想要多个模型、同时支持图片和视频输入,还想把口型同步、语音生成和视频编辑放在一处完成,Morphic 是个不错的选择。打开任意文件,切换到视频模式,选择 Lip Sync,就能马上开始生成。付费方案的输出分辨率更高、处理更快,经常做口型同步视频或处理较长片段时,差别很明显。