Seedance 1.5 Pro
por ByteDance
O modelo de áudio e vídeo nativos da ByteDance.
Vídeo e diálogo saem sincronizados em uma única etapa, com lip‑sync multilíngue e controle de câmera cinematográfico.
Principais recursos
O Seedance 1.5 Pro não está mais disponível no Morphic.
Use o Seedance 2.5, o modelo mais novo e com mais recursos.
Especificações técnicas
480p / 720p / 1080p
Três níveis de resolução
4–12s
Duração de cada clipe gerado
T2V + I2V
Ambos com áudio nativo
Nativo
Áudio e vídeo na mesma etapa
Casos de uso
Anúncios com narração sincronizada
Você gera o clipe do anúncio com fala, trilha e ação em cena já no tempo certo. Não precisa de uma mixagem de áudio à parte.
Drama e diálogo em formato curto
Curtas guiados por diálogo pedem que lip-sync, atuação e emoção passem como uma tomada só. É isso que o modelo entrega, inclusive nas versões em vários idiomas.
Campanhas de anúncio localizadas
Gere o mesmo anúncio com a fala em vários idiomas. Como o lip-sync fecha em cada um deles, a versão localizada não parece dublada.
Imagem para vídeo com áudio
Comece por uma imagem feita no Seedream. O Seedance 1.5 Pro anima a cena e cria o áudio correspondente na mesma etapa.
Exemplos de prompts
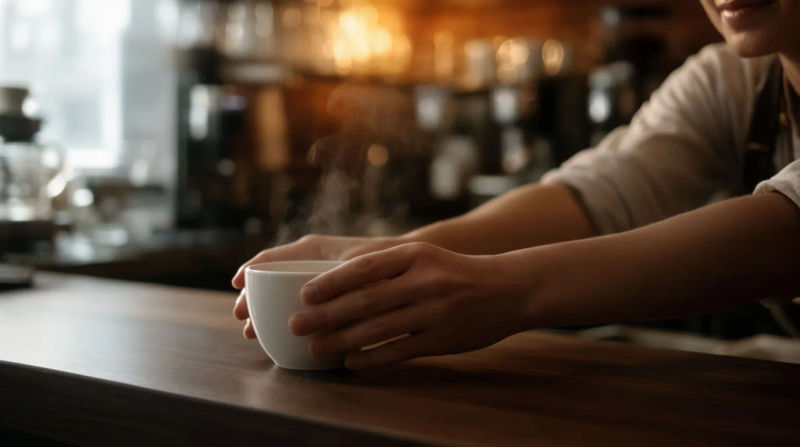
Anúncio com diálogo
Close de uma atendente de padaria entregando um copo de café, sorrindo, ela diz "bom dia, aproveite" em tom acolhedor, som ambiente de padaria movimentada, 8 segundos
Edit prompt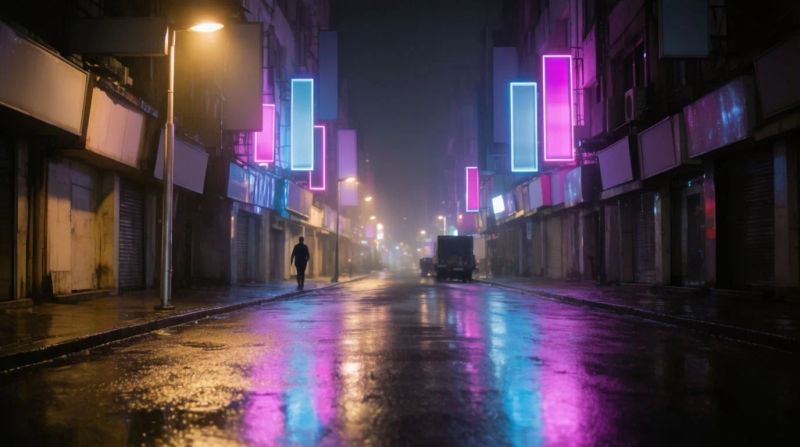
Cena cinematográfica
Dolly lento por uma rua de neon à noite depois da chuva, passos ecoando, trânsito ao longe, 1080p cinematográfico
Edit prompt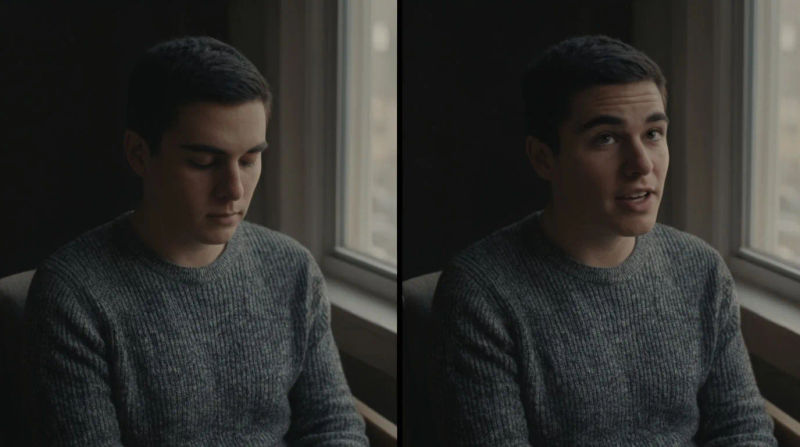
Imagem para vídeo
Anime esta imagem, a personagem levanta o olhar e diz a fala baixinho, com lip-sync preciso, som ambiente suave de quarto
Edit prompt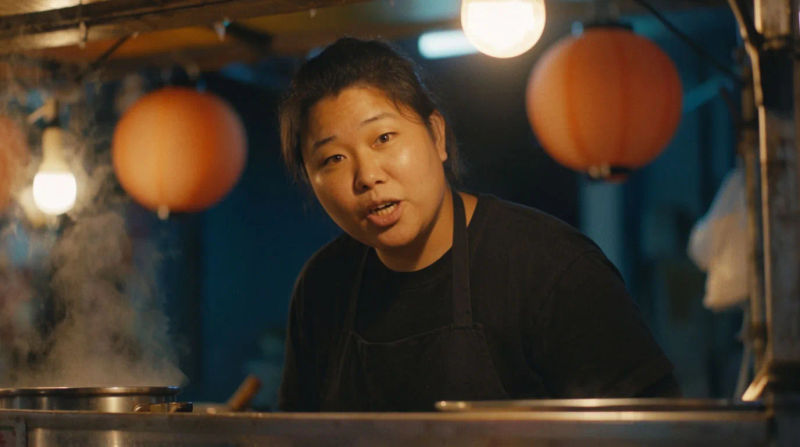
Lip-sync multilíngue
Um vendedor de feira noturna diz uma frase em japonês, lip-sync preciso
Edit prompt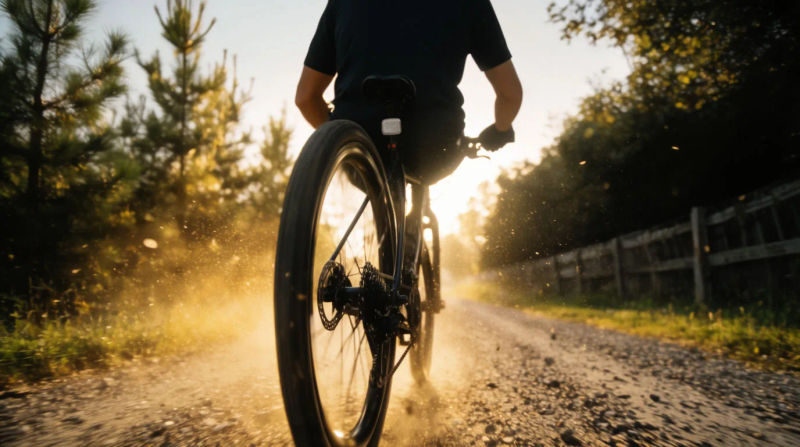
Foley sincronizado
Travelling atrás de um ciclista no cascalho, pneus, respiração, 12 segundos
Edit prompt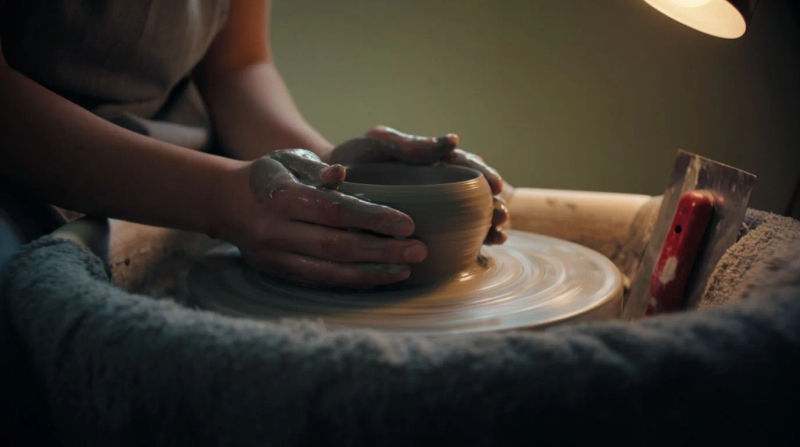
Visão geral
O Seedance 1.5 Pro é o modelo de geração de vídeo com áudio nativo da ByteDance. A maioria dos modelos de vídeo encaixa o som só no final. Aqui, imagem e áudio nascem na mesma etapa. Quem cuida disso é um Diffusion Transformer de dupla ramificação com um módulo conjunto cross-modal, a arquitetura de áudio e vídeo da ByteDance. Ela segura o diálogo no tempo da ação, e mantém passos e som ambiente alinhados do primeiro ao último quadro. Some a isso o lip-sync em seis idiomas, com sotaques regionais, e uma inferência mais de 10x mais rápida. Por isso o modelo cai bem em anúncios, drama curto e qualquer criativo localizado guiado por diálogo.
Preços simples
Comece grátis hoje mesmo, com a opção de fazer upgrade ou cancelar quando quiser.
Basic
2400 mensal créditos
1 apenas usuário
Todos os modelos
Workflows
Standard
3625 mensal créditos
1 apenas usuário
Todos os modelos
Workflows
Pro
6350 compartilhado mensal créditos
1 usuário
Todos os modelos
Workflows
Max
24650 compartilhado mensal créditos
1 usuário
Todos os modelos
Workflows
Enterprise
Para limites maiores
Personalizado
termos de preços e cobrança

Free
Para experimentar
$0
grátis para sempre
Perguntas frequentes
Outros modelos
Explore o restante do catálogo de modelos do Morphic.
Gemini Omni Flash 1.2
Google DeepMind
O modelo de vídeo do Google, agora com quinze segundos. Edite a tomada inteira pagando 30% menos por segundo.
ChatGPT Images 2.6
OpenAI
Modelo de imagem da OpenAI, lançado em novembro de 2026. GIFs animados, exportação em SVG, rascunhos mais rápidos.
SAM 3.1
Meta
O Segment Anything da Meta. Rastreie qualquer sujeito com uma máscara que o acompanha.
Seed Audio 1.5
ByteDance
Áudio de cena completa da ByteDance. Diálogo, música e efeitos, em faixas separadas.