Seed Audio 1.5
por ByteDance
Áudio de cena completa da ByteDance.
Diálogo, música e efeitos, em faixas separadas.
Principais recursos
Ouça a variedade
Duas vozes, zumbido e uma base tensa.
Um aviso, pingos d'água, o portão se abre.
Vinheta curta que cede espaço à voz.
Japonês sobre um mercado de manhã.
Especificações técnicas
6 min
Por geração, contra 2 minutos no Seed Audio 1.0
6
Clipes de referência por geração, antes 3
30
Inclui variantes regionais do espanhol e do português
5
Texto para áudio, voz de referência, vídeo para áudio, dublagem de vídeo e separação de stems
Casos de uso
Dublagem e localização
Envie um corte pronto e receba uma dublagem que segue a imagem, mantendo efeitos e música originais.
Séries e dramas curtos
Seis minutos cobrem uma cena inteira, e as faixas separadas permitem refazer uma fala sem novas renderizações.
Audiolivros e radioteatro
Narração, vozes de personagens e ambiência juntas, com o mesmo elenco mantido num capítulo longo.
Anúncios
Locução, crescendo musical e efeitos de uma vez. Se o cliente pedir ajuste, regere só aquela camada.
Games
Falas, ambiências e efeitos cronometrados para cutscenes e trailers, cravados no segundo.
Podcasts
Vinheta de abertura, dois apresentadores e um estúdio com som real, cada voz em sua faixa.
Exemplos de prompts
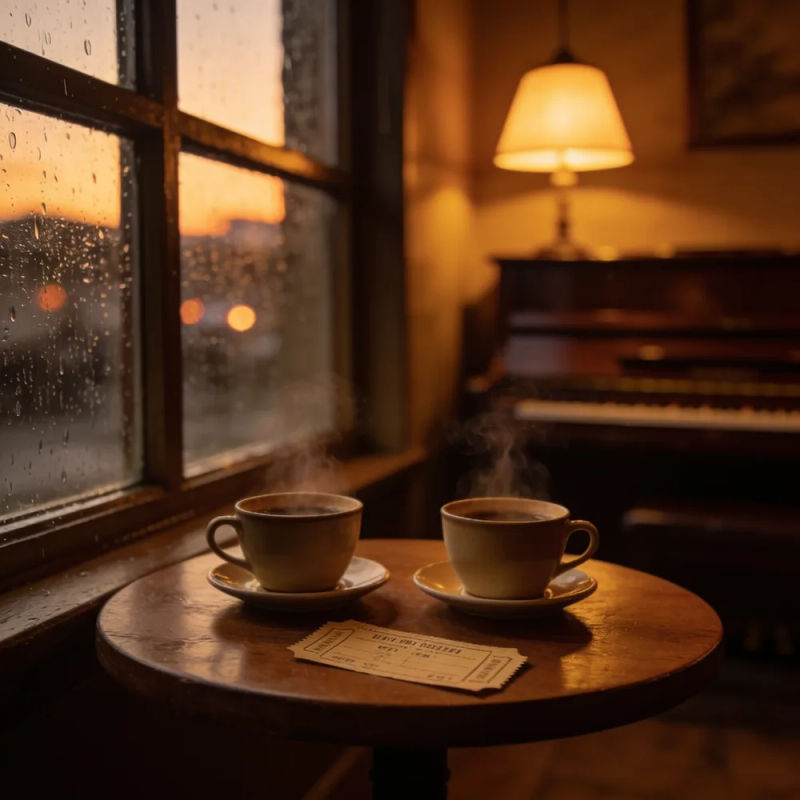
Reencontro no café
Café com chuva, piano suave. Bia, nervosa: “Guardou o ingresso?” Caio ri.
Trailer narrado
Cordas graves, vento frio. Narrador: “Certas portas ficam fechadas.” Trovão.
Anúncio
Batida pop, café servido. Voz animada: “Café fresquinho na porta até as 8.”
Abertura de livro
Lareira crepitando, vento. Narradora, sem pressa: “Um navio não voltou.”
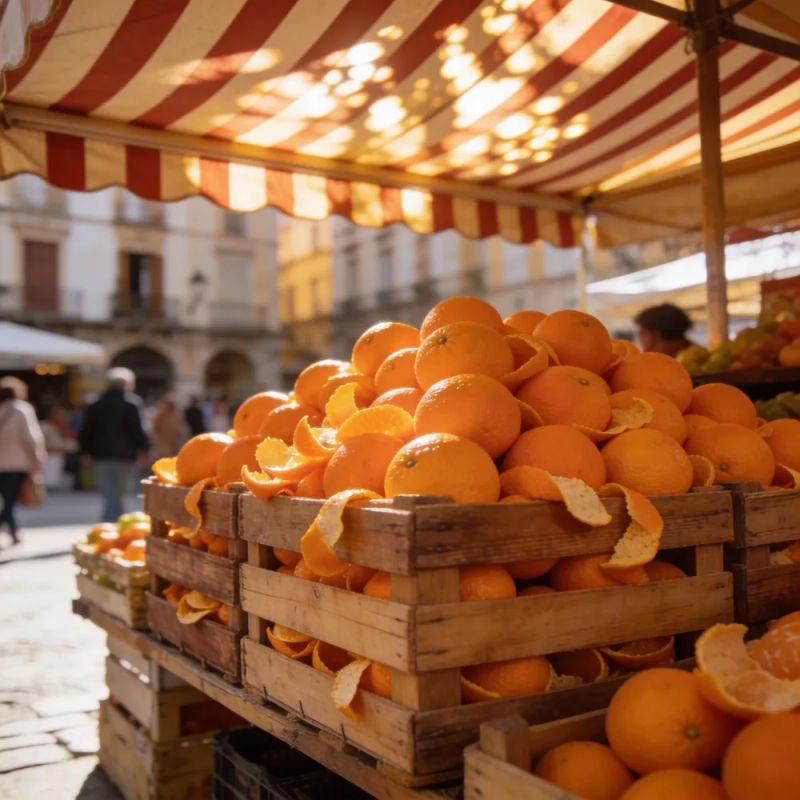
Feira espanhola
Feira cheia. Vendedor, em espanhol: “¡Naranjas frescas, a un euro el kilo!”
Visão geral
O Seed Audio 1.5 é o modelo de áudio de cena completa da ByteDance, sucessor do Seed Audio 1.0, lançado em 28 de outubro de 2026. A API oficial está disponível pelo BytePlus ModelArk. Ele gera diálogo, música, ambiência e efeitos de um só prompt, chega a seis minutos e aceita vídeo, vozes de referência e timestamps como direção.
O que o Seed Audio 1.5 faz de diferente
A cena volta em camadas. Diálogo, ambiência, efeitos e música chegam em faixas separadas, então uma fala errada ou um efeito alto demais se corrige sem mexer no resto. Com o vídeo como entrada, o som acompanha um corte já finalizado, que é o que dublagem e tradução pedem.
Seed Audio 1.5 no Morphic
O Seed Audio 1.5 chega ao Morphic em breve. O Seed Audio 1.0 já está no ar para cenas completas, ao lado do ElevenLabs, do Lyria e dos demais modelos de áudio, então dá para montar a cena no Canvas hoje mesmo. Para a estrutura do prompt, veja o guia de prompts do Seed Audio 1.5, ou comece por uma cena de exemplo no gerador de áudio com IA Seed Audio 1.5.
Preços simples
Comece grátis hoje mesmo, com a opção de fazer upgrade ou cancelar quando quiser.
Basic
2400 mensal créditos
1 apenas usuário
Todos os modelos
Workflows
Standard
3625 mensal créditos
1 apenas usuário
Todos os modelos
Workflows
Pro
6350 compartilhado mensal créditos
1 usuário
Todos os modelos
Workflows
Max
24650 compartilhado mensal créditos
1 usuário
Todos os modelos
Workflows
Enterprise
Para limites maiores
Personalizado
termos de preços e cobrança
Free
Para experimentar
$0
grátis para sempre
Perguntas frequentes
Veed Dubbing
Veed
O modelo de dublagem de vídeo da Veed, em Standard e Pro. Um novo idioma, a voz de cada pessoa, lábios em sincronia.
FLUX Video Upscale
Black Forest Labs
O upscaler de vídeo da Black Forest Labs. Até 4K, com o detalhe fino reconstruído e o som preservado.
FLUX 3 Max
fal.ai
O FLUX 3 pós-treinado pela fal. Fiel ao roteiro e feito para a velocidade.
Krea 3
Krea AI
O modelo de edição de imagem rápido da Krea. Junte até 4 imagens numa só edição.