O Seed Audio 1.5 é o modelo de áudio de cena completa da ByteDance e chega ao Morphic em breve. Um único prompt devolve diálogo, música, ambiência e efeitos sonoros em faixas separadas, com até seis minutos. O acesso antecipado está pausado pelo lado do provedor enquanto o modelo é atualizado, então ainda não há data; a expectativa é que ele aceite os mesmos prompts de cena quando abrir. Este guia mostra como escrever para ele, e o Seed Audio 1.0 roda o mesmo tipo de prompt de cena no Morphic hoje.
Como é montado um prompt do Seed Audio 1.5
Escreva a cena na ordem em que o ouvinte a escuta: onde estamos, quem fala, o que diz e o que acontece em volta. Primeiro a história, depois a lista de sons.
| Parte | O que escrever | Exemplo |
|---|---|---|
| Cena | Lugar, hora, clima, tamanho do ambiente | [Noite. Uma plataforma de trem vazia, chuva no telhado.] |
| Voz | Nome, idade, sotaque, emoção, ritmo | Mara (30 e poucos anos, voz calma, tom cansado) |
| Fala | As palavras exatas, entre aspas | “O último trem já passou.” |
| Efeitos sonoros | A fonte e como ela se move | [Passos no concreto molhado, sumindo.] |
| Música | Gênero, instrumentos, clima, volume | [Um pad grave de sintetizador por baixo de tudo.] |
| Tempo | Um timestamp onde importa | [0:06] Os passos começam. |
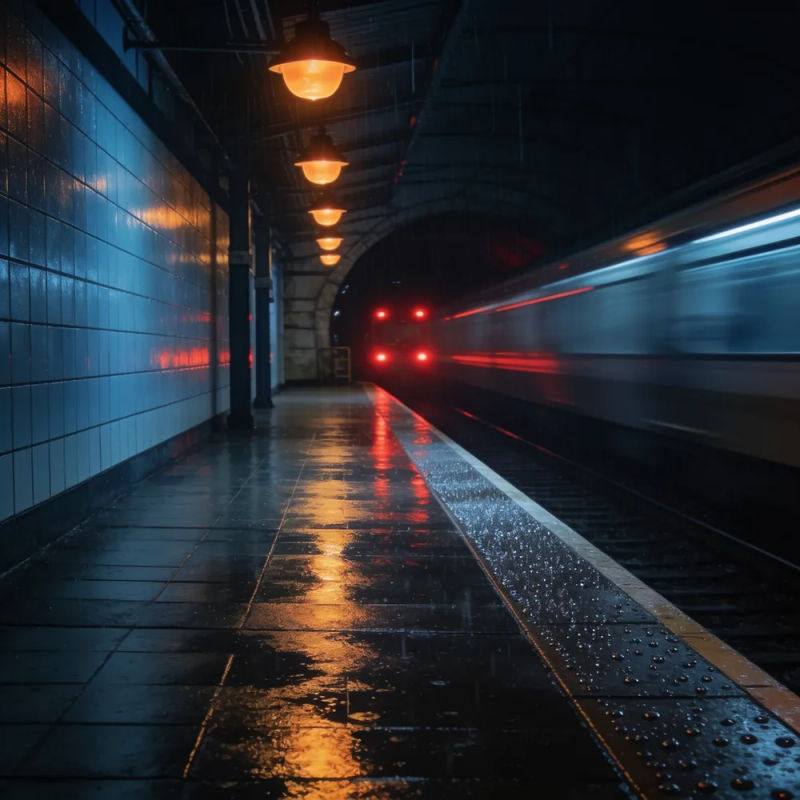
O Seed Audio 1.5 ainda não está no Morphic. Por isso, estas amostras foram feitas no Morphic. As vozes e os efeitos sonoros vêm da ElevenLabs e a música, do Lyria, mixados para combinar com cada prompt.
Os cinco modos de entrada do Seed Audio 1.5
Todos os modos partem de um prompt de texto. O que você soma a ele define quanto o modelo inventa e quanto ele segue.
| Modo | O que você adiciona | Melhor para |
|---|---|---|
| Texto para áudio | Um prompt e uma imagem de referência opcional para o clima | Primeiros rascunhos, anúncios, bases sonoras |
| Voz de referência | Até seis clipes (2 a 30 s cada) para vozes | Um elenco recorrente, um narrador que você já usa |
| Vídeo para áudio | Um clipe de vídeo, com referências de voz opcionais | Trilha para um corte, design de som sobre a imagem |
| Dublagem de vídeo | Um vídeo e um idioma-alvo, glossário opcional | Tradução de diálogos em 30 idiomas |
| Separação de faixas | Um único arquivo de áudio (até 6 min) | Separar um mix em vozes, efeitos e música |
Timestamps no Seed Audio 1.5
O Seed Audio 1.0 aceitava uma janela de tempo nas falas, como [5.5s:8.0s]. O Seed Audio 1.5 estende os timestamps a efeitos sonoros e deixas de música. Assim, uma porta, um acorde seco ou uma subida da trilha caem onde você marcou, e não onde o modelo adivinha.
- Marque o tempo das batidas que precisam bater com a imagem: uma fala no corte, um impacto no golpe, uma subida na revelação.
- Deixe o resto sem marcação. O som ambiente e a música de fundo ficam mais naturais quando o modelo os posiciona.
- Mantenha os timestamps em ordem e deixe um respiro entre as falas, para que a fala não se sobreponha por acidente.
[0:00] Murmúrio de plateia em um teatro pequeno. [0:04] As luzes se apagam com um clique. [0:05] Voz da apresentação (calorosa, num sussurro): “Boa noite a todos.” [0:09] Um único acorde de piano.
Referências de voz no Seed Audio 1.5
Adicione até seis clipes de referência, um por personagem, e marque cada um no prompt. Assim o modelo sabe qual voz diz qual fala. A referência define o som da voz, e o prompt define a interpretação.
| Para dirigir isto | Escreva assim |
|---|---|
| Emoção | (referência 2; com mágoa, segurando o choro) |
| Estilo | (referência 1; tom seco e contido, com um toque de humor) |
| Ritmo | (referência 3; ritmo lento, pausas longas entre as frases) |
| Sons que não são fala | (referência 1; um suspiro antes da fala, uma risada curta depois) |
Use gravações limpas de uma voz que você tem direito de usar. A voz de uma pessoa real exige a permissão dela.
Dublagem e tradução de vídeo com o Seed Audio 1.5
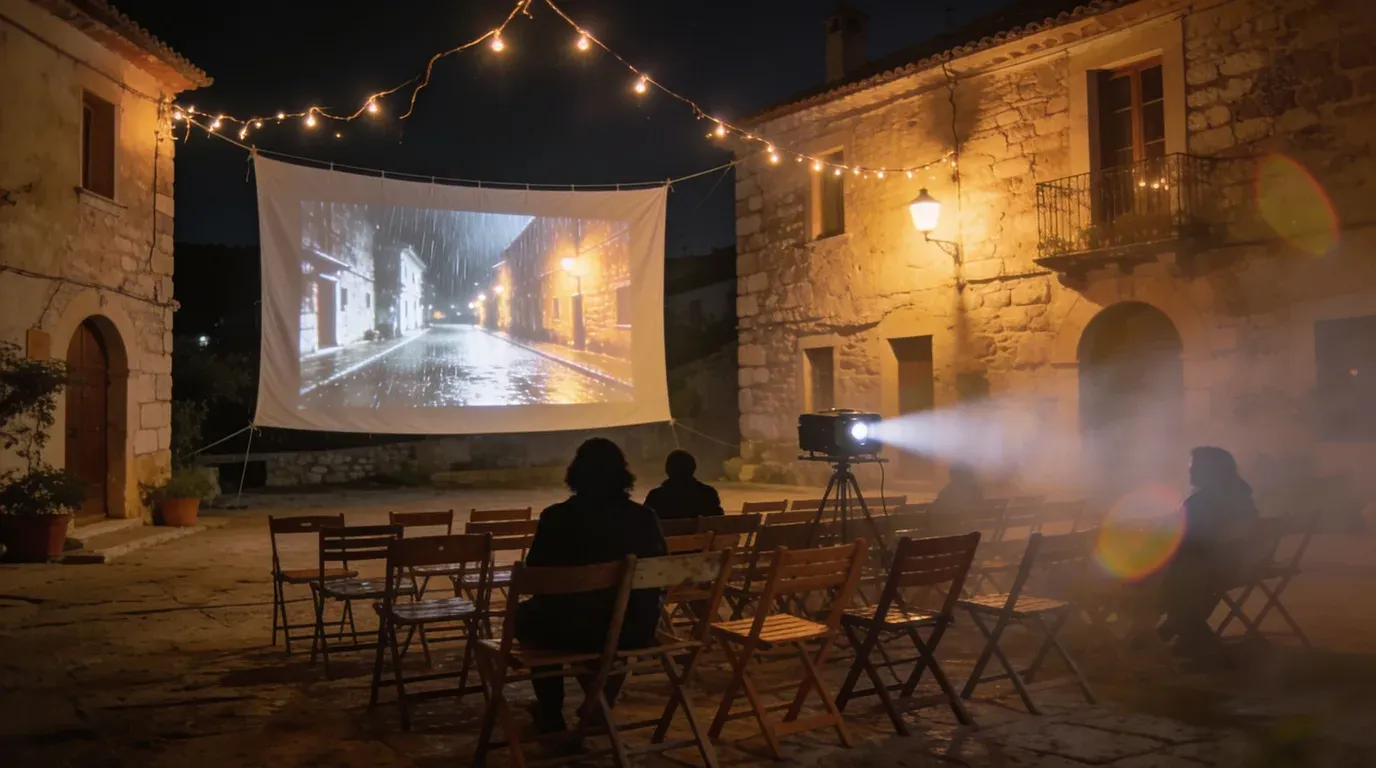
Entregue um vídeo ao Seed Audio 1.5 e ele cria locução, música, efeitos e ambiência que acompanham a ação. O contexto fica mantido no clipe inteiro. Na tradução, ele troca o idioma falado e preserva os efeitos sonoros e a música originais.
- Descreva a voz de cada pessoa que fala, ou adicione uma referência, para a dublagem manter o mesmo elenco em todos os idiomas.
- Diga o que manter: “mantenha a música e os efeitos originais, troque só o diálogo”.
- Peça a alguém fluente que confira pronúncia, sentido e fraseado antes de publicar.
Hoje, no Morphic, a dublagem de vídeo com IA traduz e refaz a voz de um clipe. O passo a passo de dublagem e localização cobre legendas, lip sync e a edição final.
Traduza o diálogo para o português do Brasil. Mantenha a música e os efeitos sonoros originais. Narração: voz calorosa e tranquila, no mesmo ritmo do original.
Faixas separadas no Seed Audio 1.5
O Seed Audio 1.0 devolvia um único arquivo mixado. O Seed Audio 1.5 entrega diálogo, ambiência, efeitos e música em faixas separadas, e ainda separa o diálogo por voz. Aperte o play para ouvir uma cena de tempestade e silencie ou isole qualquer faixa durante a reprodução. Cada voz tem a sua pista.
| Na edição | O que as faixas separadas permitem |
|---|---|
| Volume | Abaixe a música sob uma fala sem mexer nas vozes |
| Silenciar | Tire os efeitos para um corte mais quieto, ou o diálogo para uma base de trailer |
| Substituir | Troque a fala de um personagem ou uma deixa e mantenha o resto da cena |
| Reaproveitar | Use a mesma ambiência na cena seguinte para o lugar soar contínuo |
Seed Audio 1.5 vs Seed Audio 1.0: o que mudou
O Seed Audio 1.0 deixou entrada de vídeo, áudio mais longo e saída multitrilha como próximos passos, e o Seed Audio 1.5 traz os três.
| Seed Audio 1.0 | Seed Audio 1.5 | |
|---|---|---|
| Duração por geração | 2 minutos | 6 minutos |
| Referências de voz | 3 | 6 |
| Idiomas | 20 | 30 |
| Entradas | Texto, referências de áudio, uma imagem | Adiciona vídeo |
| Saída | Uma faixa mixada | Diálogo, ambiência, efeitos e música separados |
| Timestamps | Falas | Falas, efeitos e deixas de música |
| Músicas com letra | Não | Sim |
A maioria dos prompts do Seed Audio 1.0 continua valendo sem mudança. Para o detalhe completo do 1.0, veja o guia do Seed Audio 1.0.
Perguntas frequentes
O Seed Audio 1.5 chega em breve, e ainda não há data. O acesso antecipado está pausado pelo lado do provedor enquanto o modelo é atualizado. O Seed Audio 1.0 roda no Morphic hoje, em todos os planos, inclusive no Grátis.
Ainda não. Hoje você já monta cenas completas com o Seed Audio 1.0, as vozes do ElevenLabs v4, a música do Lyria e o Mirelo SFX 2.0 para criar a trilha de um vídeo pronto, tudo no mesmo Canvas.
Escreva cada fala no idioma em que quer ouvi-la, ou seja, em português se a fala for em português. As direções de cena e de voz podem ficar em inglês, se for mais fácil, mas a fala fica no idioma de destino. Peça a alguém fluente que confira pronúncia e sotaque antes de publicar.
Sim. A estrutura de cena, voz, fala e efeito é a mesma. Para usar as novidades, adicione um vídeo, mais referências de voz, timestamps em efeitos e música, ou peça faixas separadas.
Só com a permissão dela. Os limites da ByteDance bloqueiam imitações reconhecíveis da voz de uma pessoa real sem consentimento. Também bloqueiam material protegido por direitos autorais e letras de músicas existentes. As referências devem ser gravações que você tem direito de usar.