Bernini
de ByteDance
El modelo de código abierto de ByteDance para ediciones de video con instrucciones, con la identidad intacta.
Funciones clave
Especificaciones técnicas
Planner + DiT
Planificador Qwen2.5-VL, renderizador Wan2.2 de 14B
Edit, Generate, R2V
Edición, generación, subject-to-video
480p / 16fps
Configuración de renderizado predeterminada
Apache 2.0
Pesos abiertos, alojable en tu propio hardware
Casos de uso
Mejora material real
Agrega o quita objetos, corrige un detalle o cambia el estilo de un elemento en un clip sin volver a filmar. El bloqueo de consistencia mantiene el resto de la toma idéntico, así que las ediciones se ven naturales.
Personajes recurrentes y avatares
Conserva el mismo rostro en episodios, anuncios o una serie de avatares. Subject-to-video mantiene la identidad de una persona a partir de pocas imágenes de referencia mientras se mueve por escenas nuevas.
Prueba virtual y colocación de producto
Cambia la ropa de un modelo en movimiento a partir de una referencia, o coloca un producto o un video en pantalla dentro de una toma, para trabajos de moda y publicidad que necesitan conservar intacto el clip original.
Reajusta una acción
Cambia lo que alguien hace en una toma, por ejemplo estar de pie se convierte en agacharse, sin volver a filmar. La edición de movimiento modifica la acción mientras la identidad, el encuadre y la iluminación se mantienen fijos.
Ejemplos de prompts
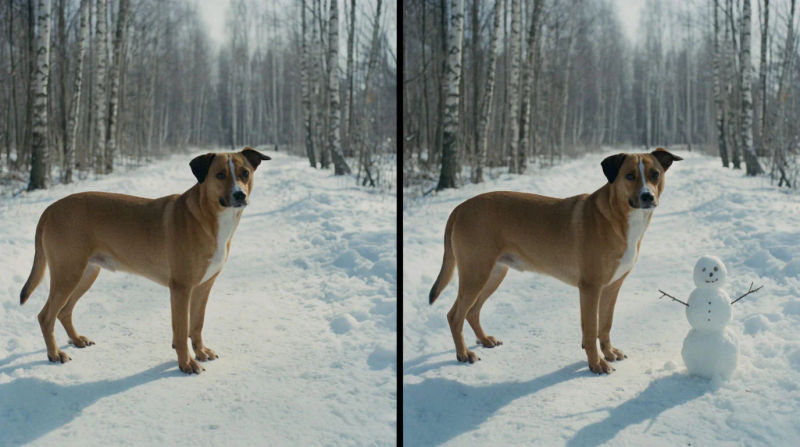
Edición de consistencia
Agrega un muñeco de nieve junto al perro en el camino nevado, y mantén el perro, el camino y los árboles sin cambios
Edit prompt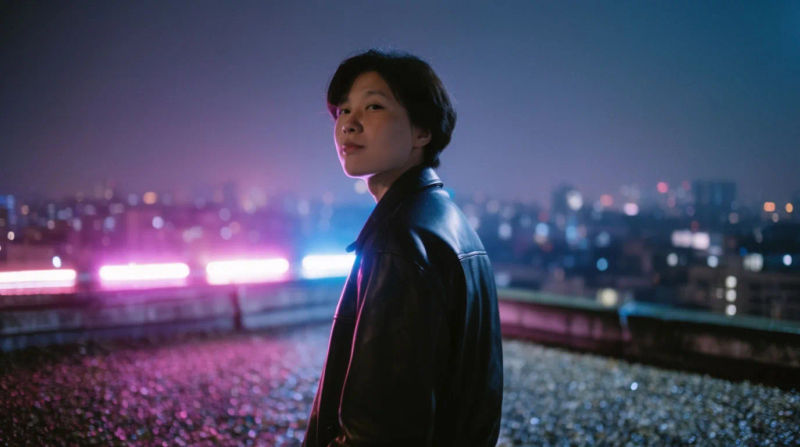
Sujeto con identidad bloqueada
Coloca a esta persona en la azotea de una ciudad de noche, girando suavemente hacia la cámara, conservando su rostro y su chaqueta
Edit prompt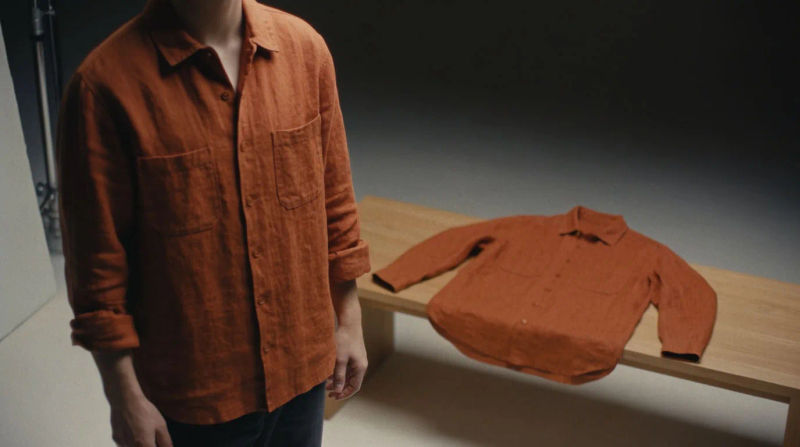
Intercambio por referencia
Reemplaza la camisa exterior por la de la imagen de referencia, y conserva exactamente la pose, la iluminación y el movimiento
Edit prompt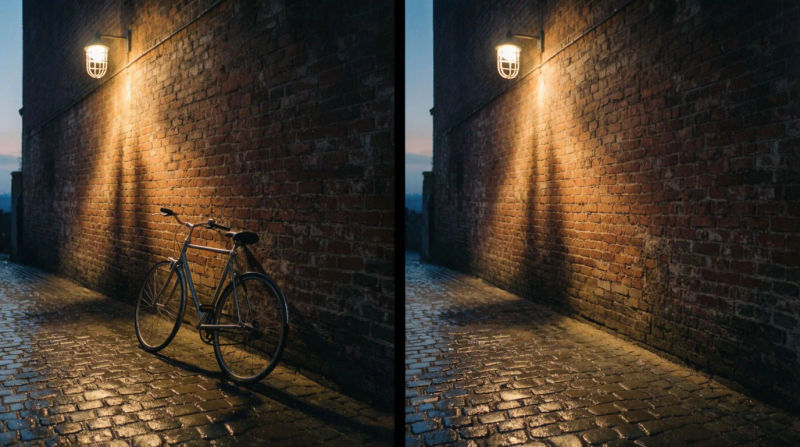
Eliminar un objeto
Quita la bicicleta del callejón y conserva el muro, la luz y las sombras
Edit prompt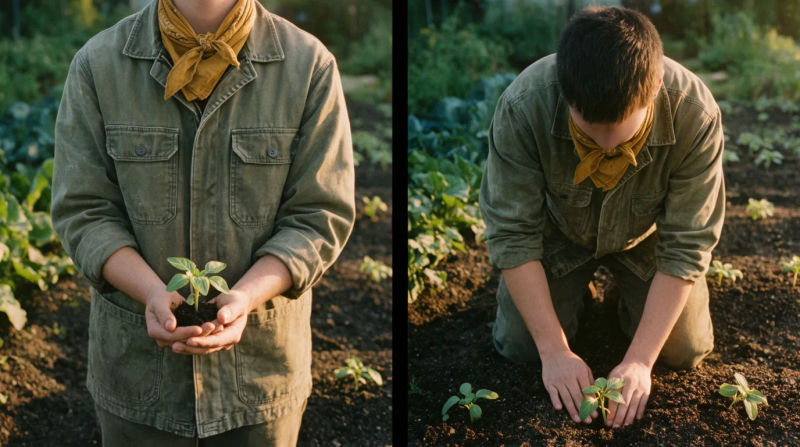
Redirigir el movimiento
Cambia la acción: el jardinero se agacha a plantar en vez de quedarse de pie
Edit prompt
Insertar un video
Inserta el clip de referencia en la pantalla y que siga el movimiento de cámara
Edit promptDescripción general
Bernini es el framework de código abierto de ByteDance para generación y edición de video con IA, lanzado bajo Apache 2.0 en junio de 2026. Su diseño divide el trabajo en dos partes, un planificador basado en MLLM (Qwen2.5-VL) decide la semántica del resultado, y luego un renderizador basado en DiT construido sobre Wan2.2 pinta los píxeles. Como el plan y el renderizado son etapas separadas, Bernini destaca en lo que la mayoría de los modelos de video no logran, editar un clip real dejando intacto todo lo que no pediste cambiar. Cubre texto a imagen, edición de imágenes, texto a video, edición de video basada en instrucciones, ediciones guiadas por referencia como cambios de prenda e inserción de video, y subject-to-video, donde su resultado más destacado es preservar la identidad de una persona mientras se mueve por una escena nueva.
Precios simples
Comienza gratis hoy, con la opción de mejorar tu plan o cancelar cuando quieras.
Basic
2400 mensual créditos
1 usuario
Todos los modelos
Workflows
Standard
3625 mensual créditos
1 usuario
Todos los modelos
Workflows
Pro
6350 compartidos mensual créditos
1 usuario
Todos los modelos
Workflows
Max
24650 compartidos mensual créditos
1 usuario
Todos los modelos
Workflows
Enterprise
Para límites más altos
Personalizado
términos de precios y facturación

Free
Para experimentar
$0
gratis para siempre
Preguntas frecuentes
Más sobre Bernini
Guías, prompts y comparaciones para Bernini.
Otros modelos
Explora el resto del catálogo de modelos de Morphic.
Seedream 5.5
ByteDance
El modelo de imágenes Seedream de ByteDance, lanzado en noviembre de 2026. Edición multirronda limpia, realismo y texto más nítido.
Gemini Omni Flash 1.2
Google DeepMind
El modelo de video de Google, ahora con tomas de quince segundos. Edita la toma completa por 30% menos cada segundo.
ChatGPT Images 2.6
OpenAI
Modelo de imágenes de OpenAI, de noviembre de 2026. GIF animados, SVG y borradores más rápidos.
SAM 3.1
Meta
El modelo Segment Anything de Meta. Rastrea cualquier sujeto con una máscara que lo sigue.