Eleven v4
de ElevenLabs
La voz más expresiva de ElevenLabs.
Etiquetas de audio, 90+ idiomas y nivel Turbo.
Funciones clave
Escucha el rango
Ritmo pausado de documental, con espacio para respirar.
Una lectura grave y rasposa, con una risita a tiempo.
Dos voces que se responden.
Una voz que habla japonés como un nativo.
Especificaciones técnicas
90+
Acento nativo en cada uno, con una voz
3,000 caracteres
Por generación de voz en Morphic
2 a 10
Voces por escena, 2,000 caracteres en total
2
Eleven v4 y Eleven v4 Turbo
Casos de uso
Audiolibros y narración
Un narrador con la misma voz del capítulo uno a la última página y el ritmo para sostener una escena lenta.
Spots y promos
Treinta segundos para vender. Dirige la energía con una etiqueta y regenera solo la línea que no convence.
Personajes y juegos
Susurros, risas, un comentario sarcástico. El rango para villanos, aliados y cada voz del pueblo.
Pódcast y radionovelas
Escribe la escena completa con todas las voces. Las respuestas reaccionan entre sí y suena a gente que conversa.
Tutoriales y cursos
Narración clara y pareja para lecciones y recorridos de producto. Cambia un paso y regenera solo esa línea.
Locución localizada
Genera el mismo mensaje en español, japonés o portugués con una sola voz y el acento que espera cada mercado.
Ejemplos de prompts
Advertencia en susurro
[whispers] Don't turn around. [pause] He's been by the door all night.
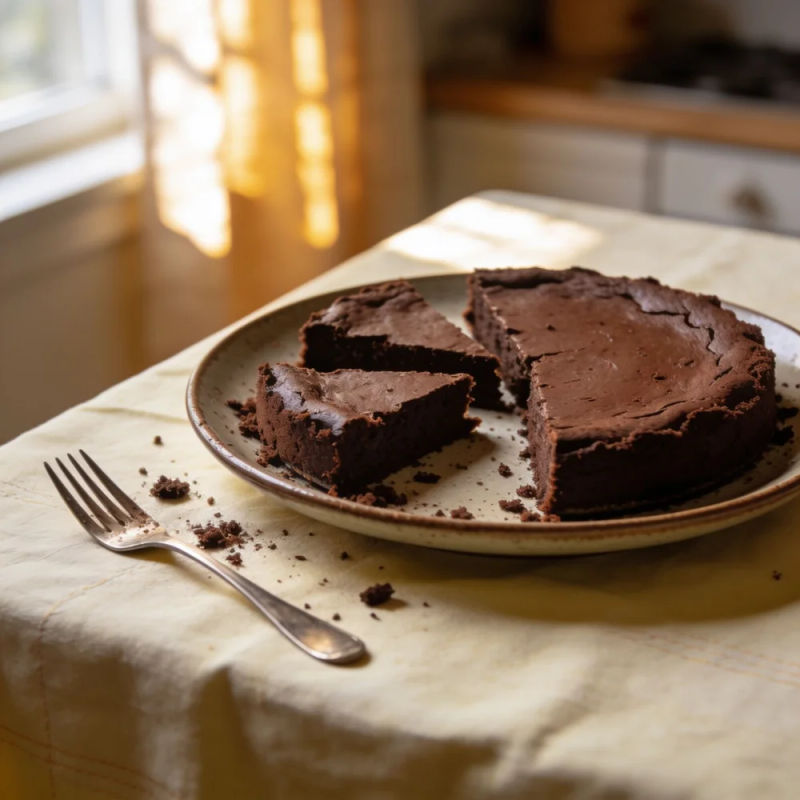
Risa a media frase
I said the cake was sugar-free. [laughs] She'd had three slices by then.
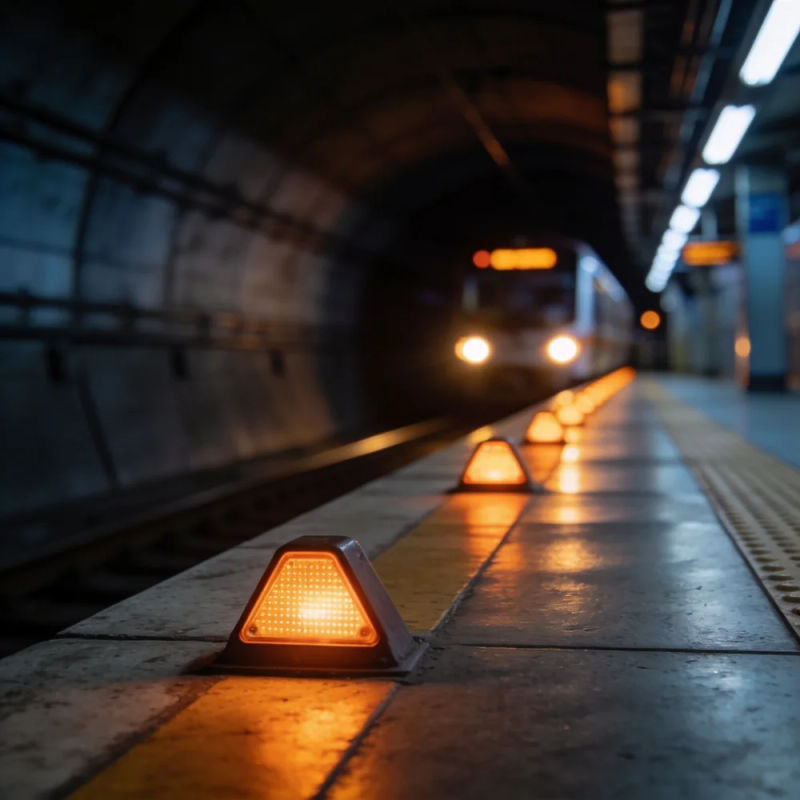
Indicación escrita
[low, steady, urgent] Everyone off the platform. Walk, don't run.
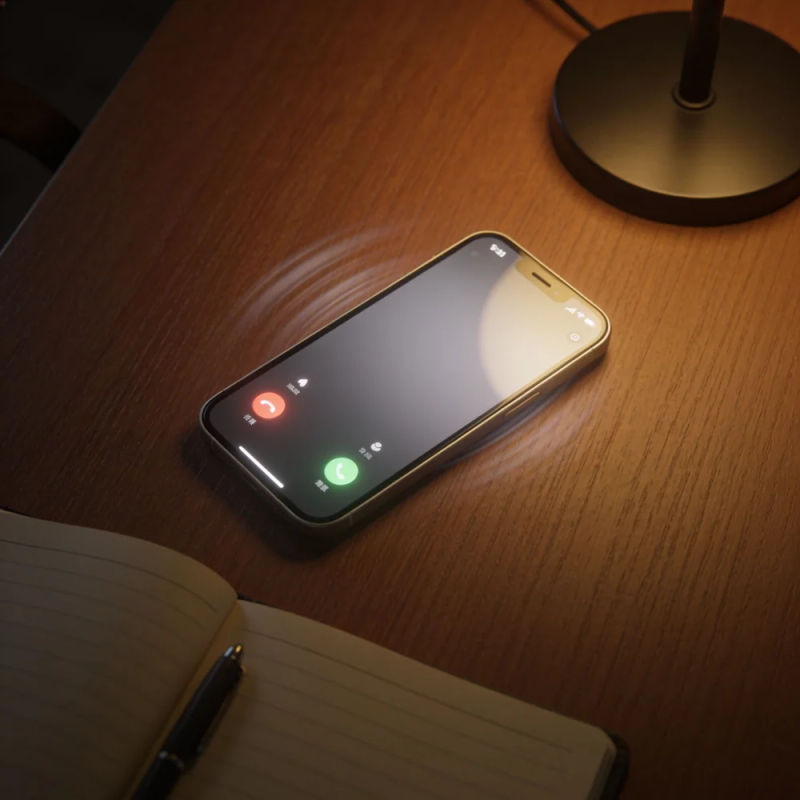
Sonido en la toma
[phone buzzing] That's work again. [sighs] I'll call them back later.
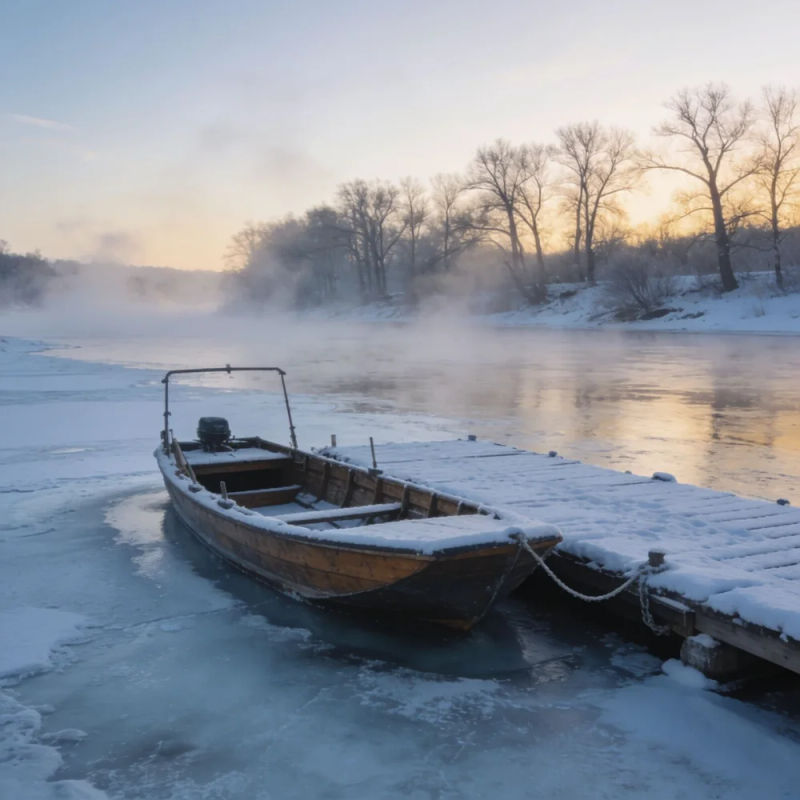
Inicio de audiolibro
Chapter three. The river froze overnight... and the ferry never left.
Español, acento nativo
[warm] Bienvenidos. Hoy preparamos el pan de la abuela, paso a paso.
Descripción general
Eleven v4 es el modelo de texto a voz más nuevo de ElevenLabs. Salió el 28 de septiembre de 2026 y es el predeterminado de Speech en Morphic. Lee el tono y el ritmo del guion y acepta etiquetas de audio para la entonación y los efectos. Interpreta diálogos entre varias voces y habla más de 90 idiomas con acento nativo. Si narras un Reel, un curso en línea o una radionovela, la voz actúa el texto en vez de recitarlo.
Eleven v4 en Morphic
Abre Speech y ElevenLabs ya viene seleccionado con Eleven v4. Para el nivel rápido, elige ElevenLabs Turbo. Pega un guion de hasta 3,000 caracteres con las etiquetas de audio dentro del texto. O pasa a Dialogue para escribir una escena de dos a diez voces. La lista completa de etiquetas y la comparación con Eleven v3 y Turbo están en la guía de prompts de Eleven v4.
Precios simples
Comienza gratis hoy, con la opción de mejorar tu plan o cancelar cuando quieras.
Basic
2400 mensual créditos
1 usuario
Todos los modelos
Workflows
Standard
3625 mensual créditos
1 usuario
Todos los modelos
Workflows
Pro
6350 compartidos mensual créditos
1 usuario
Todos los modelos
Workflows
Max
24650 compartidos mensual créditos
1 usuario
Todos los modelos
Workflows
Enterprise
Para límites más altos
Personalizado
términos de precios y facturación

Free
Para experimentar
$0
gratis para siempre
Preguntas frecuentes
OmniHuman 2.0
ByteDance
El modelo de video con humanos de ByteDance, guiado por audio. Una foto, una pista, cinco minutos en una toma.
Mirelo SFX 2.0
Mirelo AI
El modelo de video a sonido de Mirelo. Sonido nuevo para tu video, con el mismo diálogo.
Fish Audio Drama 3
Fish Audio
La voz más expresiva de Fish Audio. Dirige la interpretación, palabra por palabra.
Vidu Q4
Shengshu Technology
El modelo de video más reciente de Shengshu. Hasta 12 imágenes y 3 voces de referencia, consistentes en un clip, con audio nativo de 540p a 4K.