Vidu Q3
oleh Shengshu Technology
Model video terbaru dari Shengshu.
Kualitas lebih tajam, gerakan lebih baik, dan kepatuhan prompt lebih kuat dengan konsistensi berbasis referensi.
Fitur utama
Versi yang lebih baru sudah hadir: Vidu Q4
Model ini tetap tersedia di Morphic. Vidu Q4 adalah model terbaru dalam keluarganya.
Spesifikasi teknis
1080p
Output Full HD yang disempurnakan
8s
Hingga 8 detik per generasi
Enhanced
Ditingkatkan dari Vidu Q2
24 fps
Frame rate standar
Contoh penggunaan
Konten premium
Hasilkan output Vidu berkualitas tertinggi untuk proyek yang menempatkan keunggulan visual sebagai prioritas utama.
Serial karakter
Buat konten multi-episode dengan karakter konsisten menggunakan generasi berbasis referensi yang ditingkatkan.
Proyek komersial
Produksi konten video kualitas komersial dengan fidelitas lebih baik, cocok untuk kampanye merek.
Adegan detail
Render adegan kompleks multi-elemen dengan akurasi dan koherensi visual yang lebih baik.
Contoh prompt
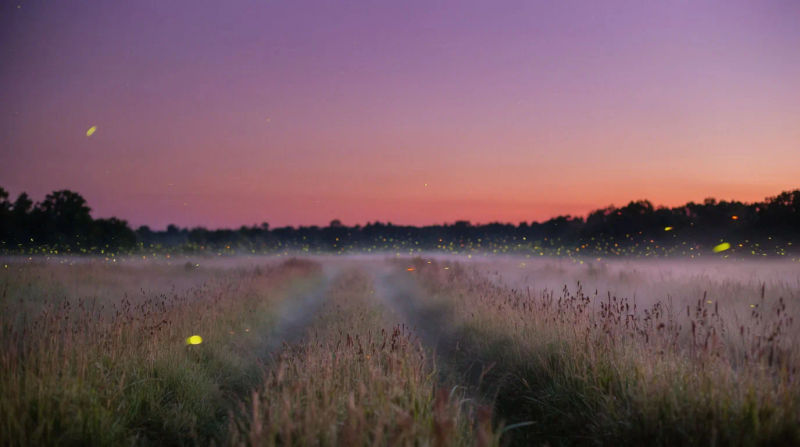
Atmosferik
Kunang-kunang muncul saat senja di padang rumput berkabut, rumput tinggi bergoyang lembut, langit gradasi ungu-oranye, penuh khayalan dan tenang
Edit prompt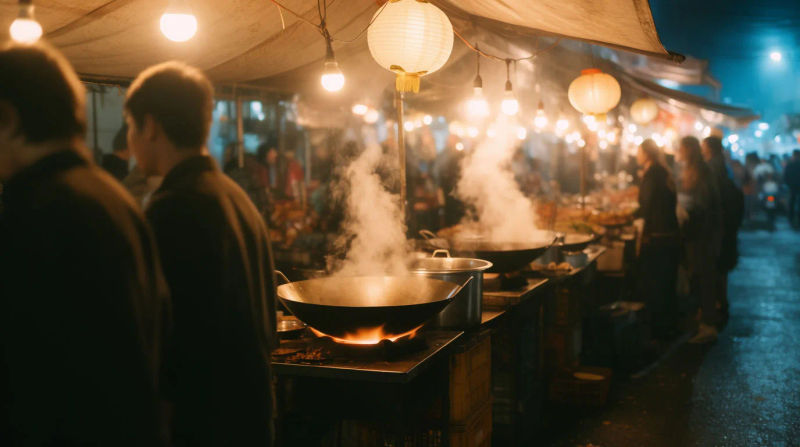
Urban
Pasar street food yang ramai di malam hari, uap mengepul dari wajan, cahaya lentera hangat, suasana hidup, sinematik
Edit prompt
Harga sederhana
Mulai gratis hari ini, dengan opsi untuk upgrade atau membatalkan kapan saja.
Basic
2400 bulanan kredit
1 pengguna saja
Semua model
Workflows
Standard
3625 bulanan kredit
1 pengguna saja
Semua model
Workflows
Pro
6350 bersama bulanan kredit
1 pengguna
Semua model
Workflows
Max
24650 bersama bulanan kredit
1 pengguna
Semua model
Workflows
Enterprise
Untuk batas yang lebih tinggi
Khusus
ketentuan harga dan penagihan

Free
Untuk bereksperimen
$0
gratis selamanya
FAQ
Model lainnya
Jelajahi katalog model Morphic selengkapnya.
Gemini Omni Flash 1.2
Google DeepMind
Model video Google, sekarang sampai 15 detik. Edit seluruh take, 30% lebih hemat per detik.
ChatGPT Images 2.6
OpenAI
Model gambar OpenAI, dirilis November 2026. GIF animasi, ekspor SVG, draf lebih cepat.
SAM 3.1
Meta
Model Segment Anything dari Meta. Lacak subjek apa pun sebagai mask yang mengikutinya.
Seed Audio 1.5
ByteDance
Model audio satu adegan dari ByteDance. Dialog, musik, dan efek di track terpisah.