FLUX 3 Max
oleh fal.ai
FLUX 3 hasil post‑training fal.
Patuh pada naskah, dibuat untuk kecepatan.
Fitur utama
Waktu render mengacu pada tolok ukur yang dipublikasikan fal, ditambah dua uji kami sendiri di Morphic. Setiap klip di halaman ini dibuat dengan FLUX 3 Max di Morphic.
Spesifikasi teknis
~12 dtk
Rata-rata fal untuk klip 720p 10 detik
5–20 dtk
Detik bulat, diatur per klip
720p / 1080p
720p secara default, 1080p kalau perlu
2–10
Frame pertama dan terakhir, atau gambar diam berwaktu
Contoh penggunaan
Adegan iklan dari naskah
Kurir berhenti mendadak, menyerahkan tas, lalu keduanya tertawa, persis berurutan. Tulis beat-nya sekali, dan klip memainkannya sampai habis.
Detail fisik dari dekat
Es retak saat mengendap dan teh memercik ke tepi gelas. Setiap bunyi jatuh tepat pada momen yang terlihat.
Dialog langsung di kamera
Taruh kalimatnya dalam tanda kutip, dan kalimat itu diucapkan kata demi kata dengan lip-sync, di tengah angin dan burung camar dermaga.
Single take yang panjang
Drone mengikuti mobil selama 15 detik: mobil, jalan, lalu mercusuar yang terungkap dalam satu gerakan, tanpa potongan dan tanpa sambungan.
Transformasi dengan keyframe
Tiga gambar diam, yaitu bongkahan tanah liat, silinder, dan mangkuk, menjadi satu proses memutar di atas roda. Tiap tahap mendarat di titik yang dipatok.
Gambar diam jadi hidup
Serahkan satu foto, dan isinya bergerak di dalam bingkai itu: komidi putar berputar, bohlam menyala, sementara suara laut dan camar mengisi audionya.
Contoh prompt
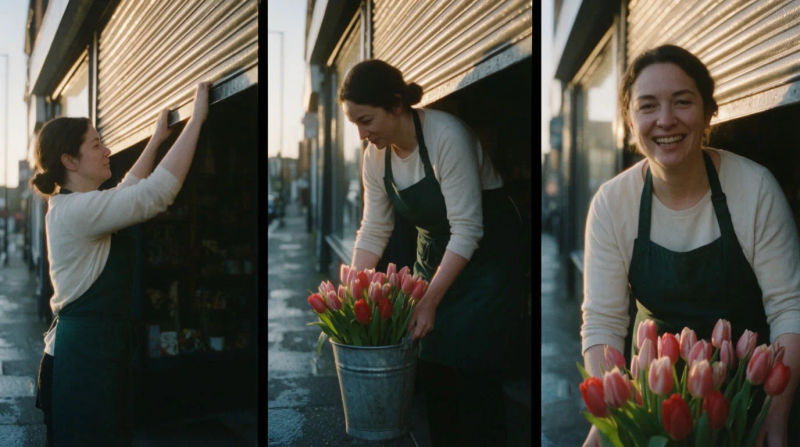
Naskah per beat
Penjual bunga membuka rolling door, menata seember tulip, lalu menyapa kamera
Edit prompt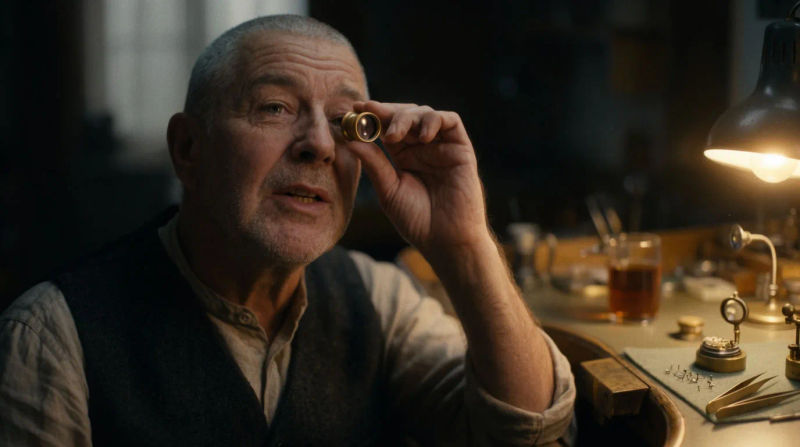
Kalimat dalam kutipan
Seorang tukang jam di toko kecil mengangkat kaca pembesarnya dan berkata: Setiap jam tangan menceritakan bagaimana ia dirawat
Edit prompt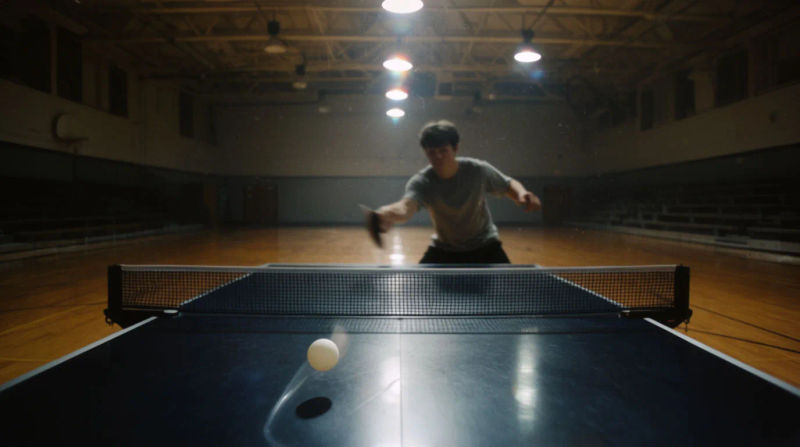
Shot berbasis suara
Reli tenis meja di GOR kosong, tiap pukulan dan pantulan bola terdengar jernih
Edit prompt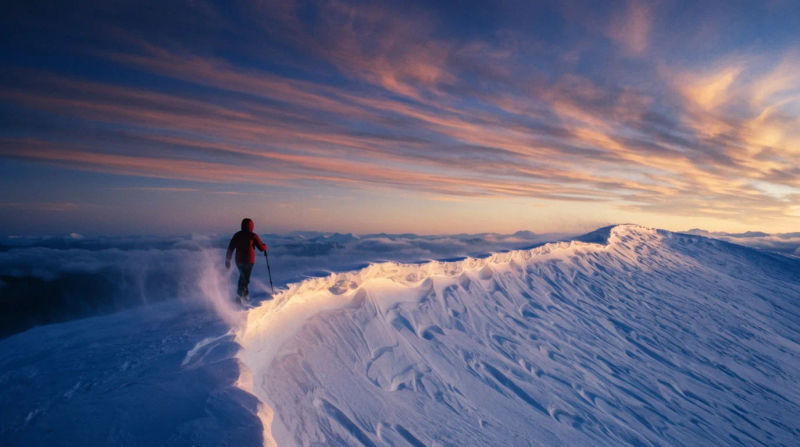
Take ultrawide
21:9, pendaki sendirian di punggungan bersalju, langit senja, angin kencang
Edit prompt
Ikhtisar
FLUX 3 Max adalah model video dari fal Research, dibangun di atas FLUX 3 milik Black Forest Labs. fal bermitra dengan Black Forest Labs untuk melakukan post-training demi prompt yang lebih dipatuhi, hasil yang lebih enak dilihat, dan kecepatan. Model ini rilis pada 19 Oktober 2026. Satu klip berdurasi 5 sampai 20 detik di 720p atau 1080p, dengan suara yang dibuat bersama gambar.
Apa yang berbeda dari FLUX 3 Max
Yang paling menonjol adalah waktu. Halaman model fal menyebut klip 10 detik dirender sekitar 12 detik. Video dengan kualitas setara biasanya butuh beberapa menit. Jadi draf bisa Anda tonton, koreksi, dan jalankan ulang dalam satu sesi.
Hasil post-training-nya juga terasa. Aksi yang ditulis berurutan diputar sesuai urutan. Di peringkat image-to-video Artificial Analysis, posisinya sejajar dengan model teratas. Max adalah edisi FLUX 3 yang disetel fal, bukan tingkatan lebih besar dari Black Forest Labs.
FLUX 3 Max di Morphic
FLUX 3 Max ada di pemilih model video, sebaris dengan Seedance, Kling, Veo, dan MiniMax H3. Ia melayani text-to-video, image-to-video, dan frames to video dengan hingga sepuluh keyframe. Morphic menjalankannya lewat fal, tim yang melakukan post-training, pada pengaturan reasoning tinggi yang paling dekat mengikuti prompt.
Hasil mendarat di Canvas. Prompt yang sama bisa Anda jalankan di model lain lalu dibandingkan berdampingan. Untuk cara menulisnya, baca panduan FLUX 3 Max. Untuk prompt siap pakai, lihat pustaka prompt FLUX 3 Max.
Harga sederhana
Mulai gratis hari ini, dengan opsi untuk upgrade atau membatalkan kapan saja.
Basic
2400 bulanan kredit
1 pengguna saja
Semua model
Workflows
Standard
3625 bulanan kredit
1 pengguna saja
Semua model
Workflows
Pro
6350 bersama bulanan kredit
1 pengguna
Semua model
Workflows
Max
24650 bersama bulanan kredit
1 pengguna
Semua model
Workflows
Enterprise
Untuk batas yang lebih tinggi
Khusus
ketentuan harga dan penagihan

Free
Untuk bereksperimen
$0
gratis selamanya
FAQ
Gemini Omni Flash 1.2
Google DeepMind
Model video Google, sekarang sampai 15 detik. Edit seluruh take, 30% lebih hemat per detik.
ChatGPT Images 2.6
OpenAI
Model gambar OpenAI, dirilis November 2026. GIF animasi, ekspor SVG, draf lebih cepat.
SAM 3.1
Meta
Model Segment Anything dari Meta. Lacak subjek apa pun sebagai mask yang mengikutinya.
Seed Audio 1.5
ByteDance
Model audio satu adegan dari ByteDance. Dialog, musik, dan efek di track terpisah.