OmniHuman 2.0
ByteDance tarafından
ByteDance'in sesle çalışan insan videosu modeli.
Bir fotoğraf, bir ses kaydı, tek çekimde beş dakika.
Öne çıkan özellikler
Teknik değerler BytePlus'ın 15 Ekim 2026 tarihli lansman yazısından alınmıştır. OmniHuman 2.0 henüz Morphic'te değil. Bu sayfadaki klipler Morphic'te Veed Fabric ile hazırlandı. Fabric bugün de tek fotoğraf ve tek ses kaydından 5 dakikaya kadar konuşan video üretiyor.
Teknik özellikler
5 dk
Kesintisiz tek çekim, BytePlus'a göre
60 sn
2.0 öncesindeki tek çekim tavanı
Fotoğraf + ses
Performansçının bir görseli ve bir ses kaydı
Her kayıt
Konuşma, müzik ya da diyalog
Kullanım örnekleri
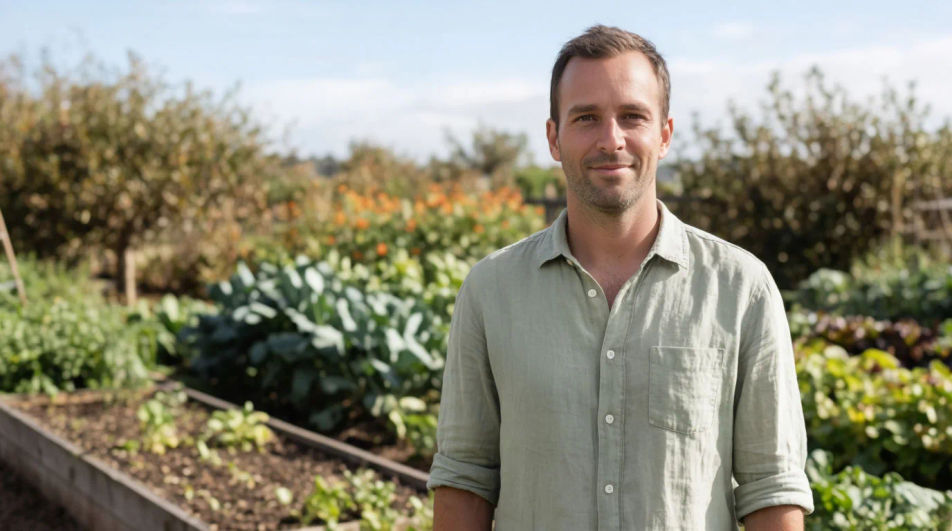
Kurslar ve dersler
Bir dersin tamamı tek çekimde gelir. Eğitmen dördüncü dakikada da ilk dakikadaki gibi görünür, kesip birleştirmeye gerek kalmaz.
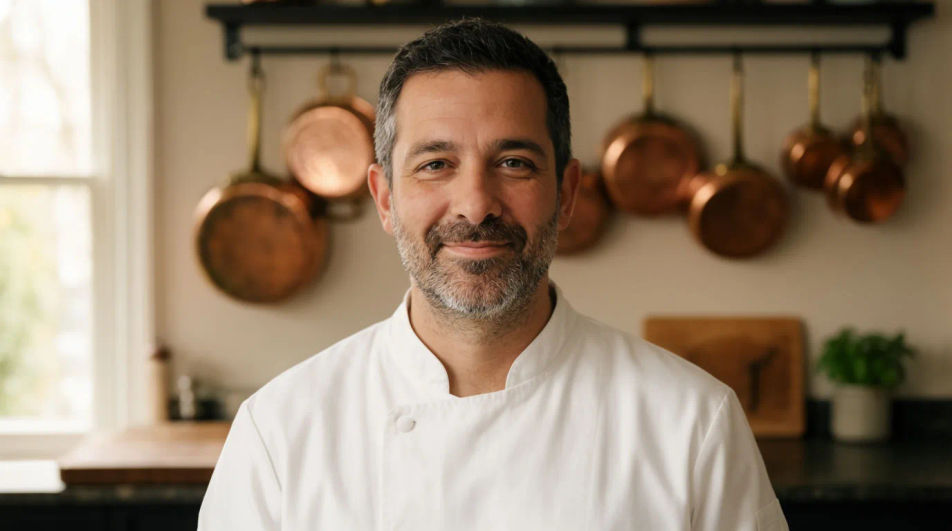
Anlatım ve nasıl yapılır videoları
Önce seslendirmeyi kaydedin ya da üretin. Sonra tek bir fotoğraf onu sunsun; izleyiciyi tutan duraklar ve vurgular yerinde kalır.
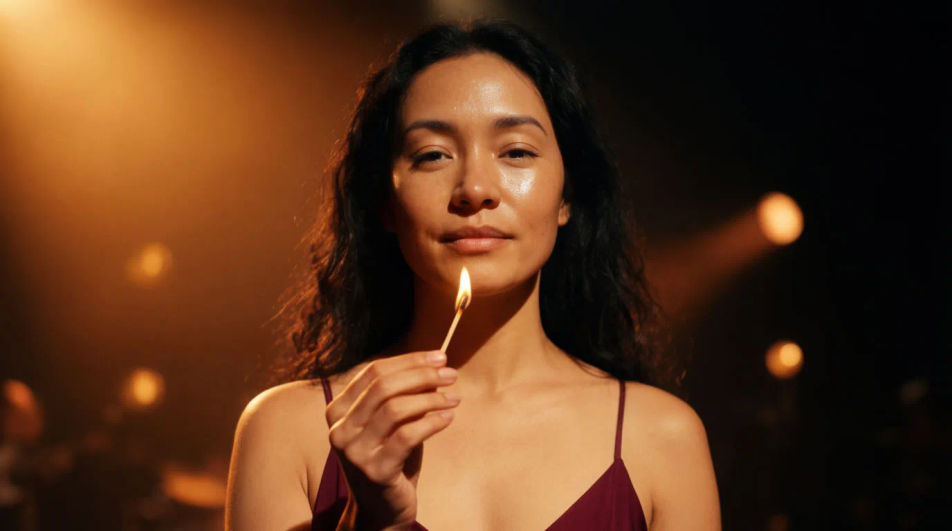
Müzik performans klipleri
Söylenmiş bir şarkı verin. Yüz yalnızca sözleri değil, uzun notaları, nefesleri ve şarkının duygusunu da taşır.
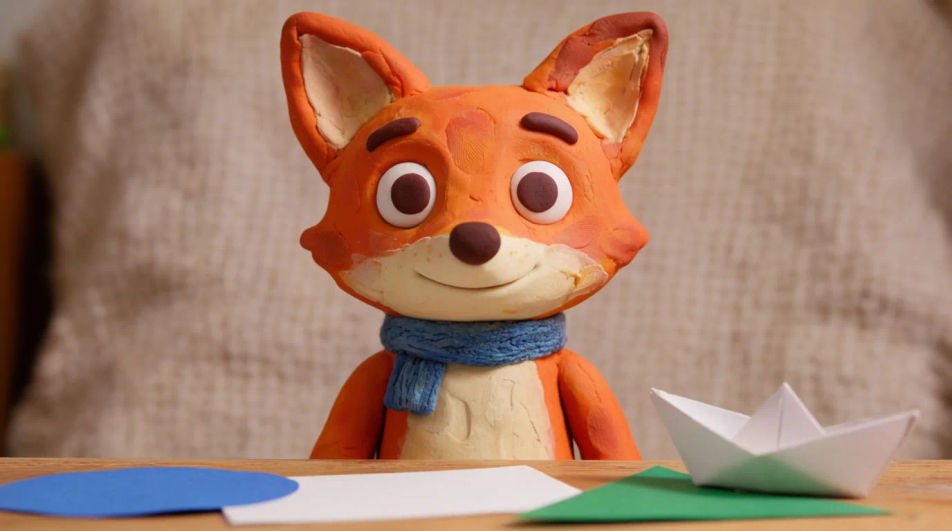
Maskotlar ve karakterler
Marka maskotuna, kil bir karaktere ya da çizilmiş bir kahramana ses verin. Reklamlar, çocuk içerikleri ve kanal tanıtımları için uygundur.
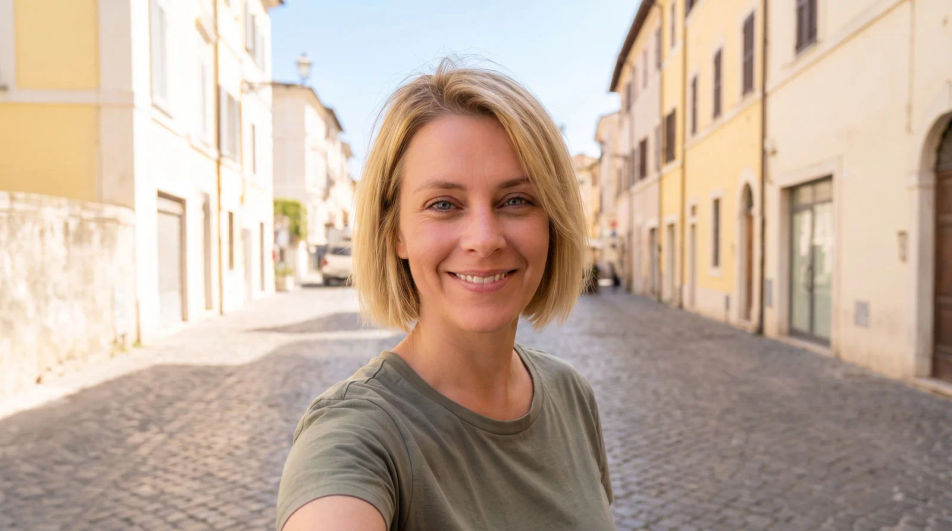
İçerik üreticisi ve sosyal medya videoları
Reels ve Shorts için dikey konuşan klipler: selfie tarzı tek bir fotoğraf ve bir ses kaydı yeter, paylaşıma hazır çıkar.
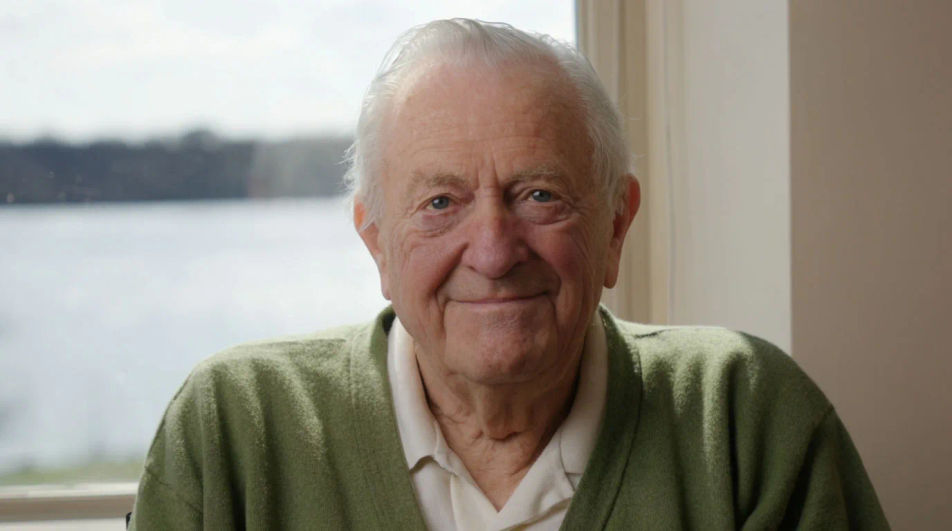
Hikâyeler ve podcast'ler
Uzun anlatılar ritmini korur: sessiz kuruluştan esprili finale kadar, performansçı her dakika sıfırlanmadan.
Genel bakış
OmniHuman 2.0, ByteDance'in sesle çalışan insan videosu modelidir ve 15 Ekim 2026'da BytePlus üzerinden yayımlandı. Tek bir fotoğrafı ve tek bir ses kaydını alır, fotoğraftaki kişinin kaydı canlandırdığı bir video üretir. Yalnızca ağız şekillerini sese uydurmaz, kaydın tonunu, duygusunu ve sözlerini de okur. Tek çekim artık 5 dakikaya kadar sürebiliyor, sınır eskiden 60 saniyeydi (kaynak).
OmniHuman 2.0'ın farkı
Çoğu konuşan fotoğraf modeli ağzı sese uydurur. OmniHuman 2.0 ise bir cümlenin nasıl söylendiğini dinler. Fısıltıyla anlatılan bir uyku masalı, antrenörün bağırdığı bir komut ve şarkıdaki uzun bir nota farklı çıkar. Girdi aynı türden olsa da üç ayrı performans görürsünüz.
Uzun tek çekim de en az bunun kadar önemli. Bir ders, bir hikâye ya da bütün bir şarkı tek planda akar. Yüzün, ışığın veya arka planın değişebileceği bir ek yeri kalmaz.
OmniHuman 2.0 Morphic'te
OmniHuman 2.0 yakında Morphic'e geliyor. O zamana kadar aynı işi Veed Fabric görüyor. Copilot'u açın, bir fotoğraf ile bir ses kaydı ekleyin ve konuşan video isteyin. Bu sayfadaki bütün klipler böyle hazırlandı. YouTube dersleri, kurs videoları ve Reels içerikleri için bu yolu şimdiden deneyebilirsiniz. En iyi sonuç için OmniHuman 2.0 rehberine göz atın.
Basit fiyatlandırma
Bugün ücretsiz başlayın, istediğiniz zaman yükseltme veya iptal etme seçeneğiyle.
Basic
2400 aylık kredi
1 yalnızca kullanıcı
Tüm modeller
Workflows
Standard
3625 aylık kredi
1 yalnızca kullanıcı
Tüm modeller
Workflows
Pro
6350 paylaşılan aylık kredi
1 kullanıcı
Tüm modeller
Workflows
Max
24650 paylaşılan aylık kredi
1 kullanıcı
Tüm modeller
Workflows
Enterprise
Daha yüksek limitler için
Özel
fiyatlandırma ve faturalandırma koşulları

Free
Denemek için
$0
kalıcı olarak ücretsiz
SSS
OmniHuman 2.0 hakkında daha fazlası
OmniHuman 2.0 için rehberler, prompt'lar ve karşılaştırmalar.
Diğer modeller
Morphic model kataloğunun geri kalanını keşfedin.
Mirelo SFX 2.0
Mirelo AI
Mirelo'nun videodan sese modeli. Videonuza yeni ses, diyalog aynı kalıyor.
Fish Audio Drama 3
Fish Audio
Fish Audio'nun en anlatımlı ses modeli. Performansı kelimesine kadar siz yönetin.
Vidu Q4
Shengshu Technology
Shengshu'nun en yeni video modeli. Tek klipte 12 referans görsel ve 3 ses tutarlı kalır; ses yerel, çözünürlük 540p-4K.
Nano Banana 2.1
Google DeepMind
Google DeepMind'ın yeni Flash görsel modeli. Daha iyi tasarım, temiz düzenleme, sabit karakter.