OmniHuman 2.0
بواسطة ByteDance
نموذج ByteDance لفيديو الإنسان المقاد بالصوت.
صورة واحدة ومسار صوتي و5 دقائق في لقطة واحدة.
الميزات الأساسية
المواصفات من BytePlus نفسها، من منشور إطلاقها بتاريخ 15 أكتوبر 2026. صُنعت مقاطع هذه الصفحة على Morphic قبل إطلاق OmniHuman 2.0 هناك، بنموذج Veed Fabric، الذي يحوّل هو أيضًا صورة ومسارًا صوتيًا إلى فيديو ناطق حتى 5 دقائق.
المواصفات التقنية
5 دقائق
لقطة متصلة واحدة، بحسب BytePlus
60 ثانية
سقف اللقطة الواحدة قبل الإصدار 2.0
صورة + صوت
صورة واحدة للمؤدي ومسار صوتي واحد
أي مسار
كلام أو موسيقى أو حوار
حالات الاستخدام
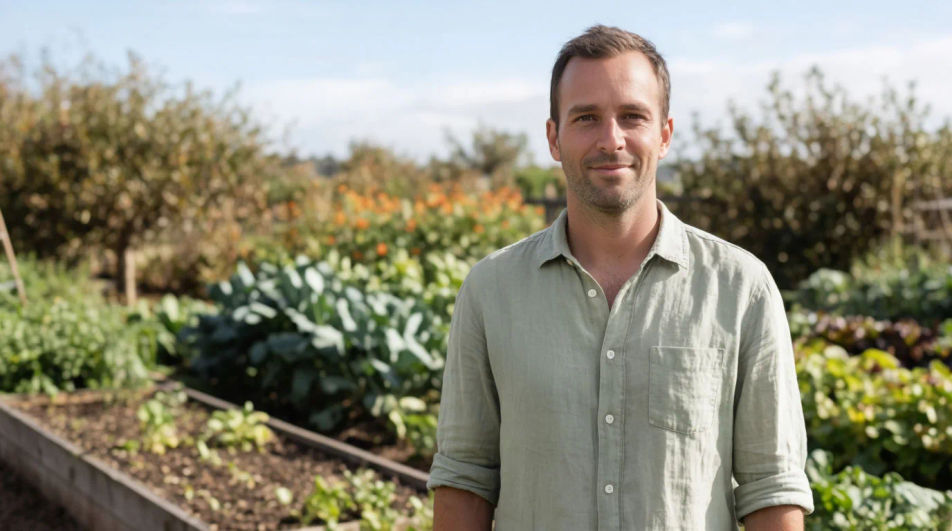
الدورات والدروس
درس كامل في لقطة واحدة. يبدو المدرّب في الدقيقة الرابعة كما في الأولى، ولا شيء يحتاج إلى مونتاج.
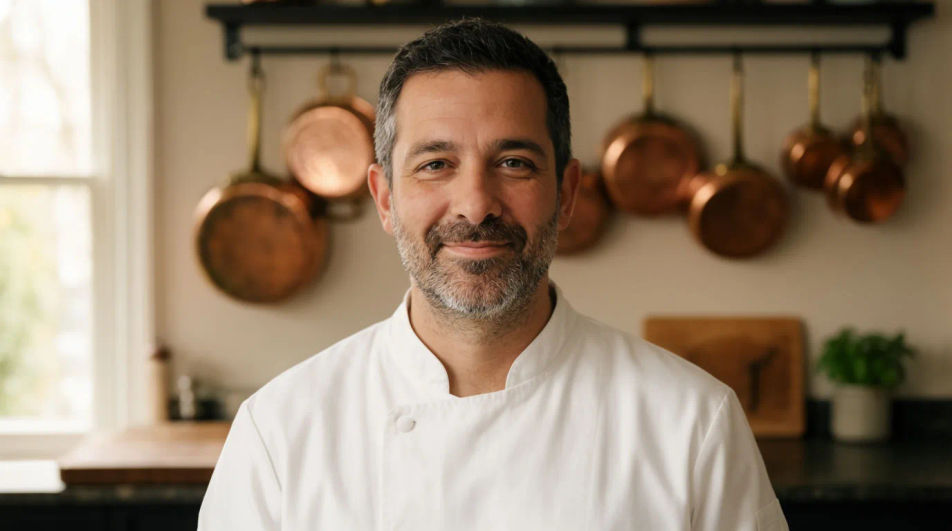
الشروحات وفيديوهات الإرشاد
سجّل التعليق الصوتي أو ولّده أولًا، ثم دع صورة واحدة تقدّمه بالوقفات والتأكيد التي تُبقي المشاهد متابعًا.
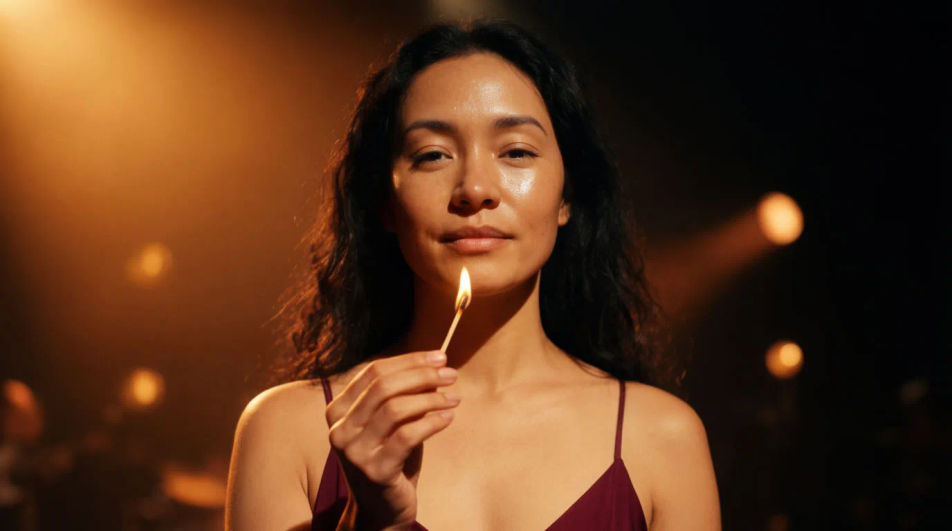
مقاطع الأداء الغنائي
أعطه مسارًا مغنّى، فيحمل الوجه النغمات الممدودة والأنفاس وإحساس الأغنية، وليس الكلمات وحدها.
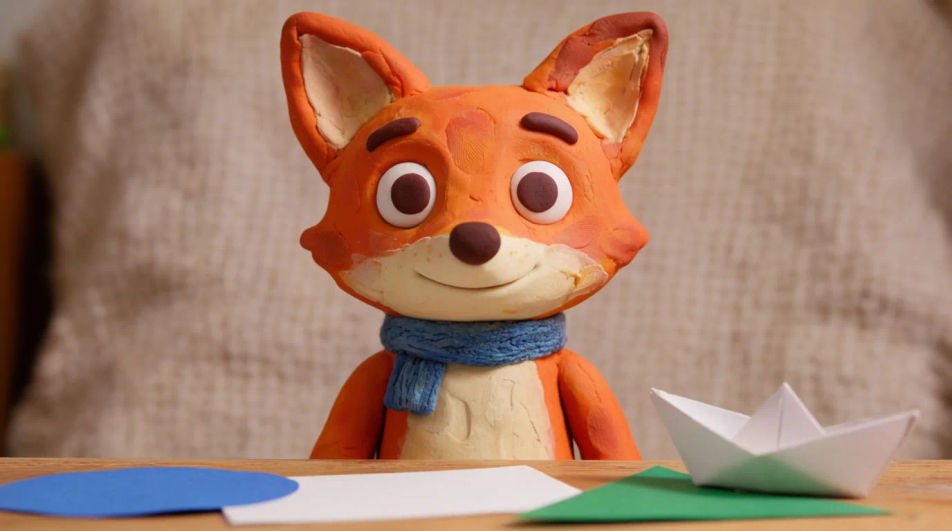
التمائم والشخصيات
امنح تميمة علامتك أو شخصية من الصلصال أو بطلًا مرسومًا صوتًا، للإعلانات ومحتوى الأطفال ومقدمات القنوات.
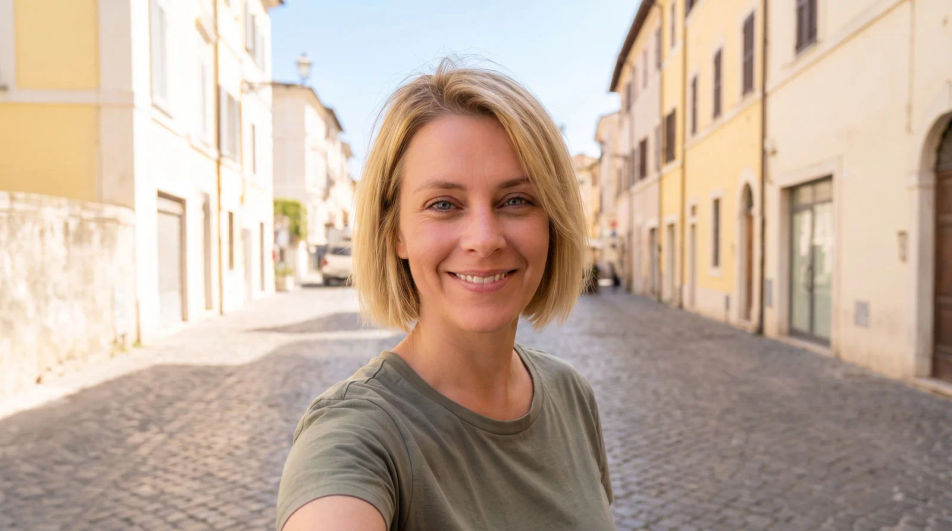
فيديوهات صنّاع المحتوى والتواصل الاجتماعي
مقاطع عمودية ناطقة لريلز وتيك توك وسناب شات، من صورة بأسلوب السيلفي ومسار صوتي. جاهزة للنشر.
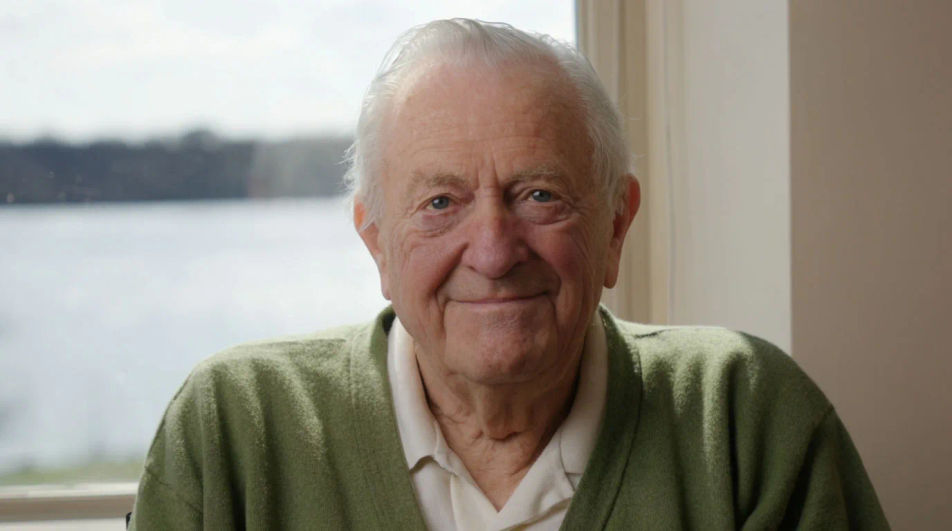
القصص والبودكاست
تحافظ القصص المحكية الطويلة على إيقاعها، من التصاعد الهادئ إلى الخاتمة، دون أن يبدأ المؤدي من جديد كل دقيقة.
نظرة عامة
OmniHuman 2.0 نموذج من ByteDance لتوليد فيديو الإنسان من الصوت، أصدرته BytePlus في 15 أكتوبر 2026. تعطيه صورة واحدة ومسارًا صوتيًا، فيولّد فيديو للشخص وهو يؤدي المسار. لا يكتفي بمطابقة شكل الفم مع الصوت، بل يقرأ النبرة والمشاعر والكلمات. وصارت اللقطة الواحدة تمتد إلى 5 دقائق بعد أن كانت 60 ثانية، دون وصل بين مقاطع (المصدر).
ما الذي يميّز OmniHuman 2.0
يبني كثير من صنّاع المحتوى في الخليج ثقة جمهورهم على وجه يخاطبه مباشرة. معظم نماذج الصورة الناطقة تحرك الفم على إيقاع الصوت فقط. أما OmniHuman 2.0 فيصغي إلى طريقة قول الجملة. فحكاية تُروى همسًا، وتوجيه يصيح به مدرّب، ونغمة ممدودة في أغنية، كلها تخرج بأداء مختلف من نوع المدخلات نفسه. وللقطة الطويلة أثر مماثل. فالدرس أو القصة أو الأغنية الكاملة تجري في لقطة واحدة، فلا يوجد وصل يتغير عنده الوجه أو الضوء أو الخلفية.
OmniHuman 2.0 على Morphic
OmniHuman 2.0 متاح الآن على Morphic. افتح Copilot، وأرفق صورة ومسارًا صوتيًا، واطلب فيديو ناطقًا بـ OmniHuman 2.0. وقد صُنعت مقاطع هذه الصفحة بالطريقة نفسها باستخدام Veed Fabric، قبل إطلاق OmniHuman 2.0. ولأفضل نتيجة اقرأ دليل OmniHuman 2.0.
أسعار بسيطة
ابدأ مجاناً اليوم، مع إمكانية الترقية أو الإلغاء في أي وقت.
Basic
2400 شهرياً أرصدة
1 مستخدم فقط
جميع النماذج
Workflows
Standard
3625 شهرياً أرصدة
1 مستخدم فقط
جميع النماذج
Workflows
Pro
6350 مشترك شهرياً أرصدة
1 مستخدم
جميع النماذج
Workflows
Max
24650 مشترك شهرياً أرصدة
1 مستخدم
جميع النماذج
Workflows
Enterprise
لحدود أعلى
مخصص
شروط الأسعار والفوترة

Free
للتجربة والاستكشاف
$0
مجاني إلى الأبد
الأسئلة الشائعة
المزيد عن OmniHuman 2.0
أدلة وأوامر ومقارنات لـ OmniHuman 2.0.
نماذج أخرى
استكشف بقية كتالوج نماذج Morphic.
Gemini Omni Flash 1.2
Google DeepMind
نموذج الفيديو من Google، وقد بلغ 15 ثانية. عدّل اللقطة كاملة بسعر أقل 30% للثانية.
ChatGPT Images 2.6
OpenAI
نموذج الصور من OpenAI، صدر في نوفمبر 2026. صور GIF متحركة، وتصدير SVG، ومسودات أسرع.
SAM 3.1
Meta
نموذج Segment Anything من Meta. تتبّع أي موضوع بقناع يلاحقه.
Seed Audio 1.5
ByteDance
نموذج ByteDance الصوتي للمشهد الكامل. حوار وموسيقى ومؤثرات، كلٌّ في مسار.