OmniHuman 2.0
por ByteDance
O modelo de vídeo humano guiado por áudio da ByteDance.
Uma foto, uma faixa, cinco minutos em um único plano.
Principais recursos
As especificações são da própria BytePlus, do post de lançamento de 15 de outubro de 2026. O OmniHuman 2.0 ainda não está no Morphic, então os clipes desta página foram feitos no Morphic com o Veed Fabric, que hoje já transforma uma foto e uma faixa de áudio em um vídeo falante de até 5 minutos.
Especificações técnicas
5 min
Um plano contínuo, segundo a BytePlus
60 s
O teto de um plano único antes da versão 2.0
Foto + áudio
Uma imagem de quem atua e uma faixa
Qualquer faixa
Fala, música ou diálogo
Casos de uso
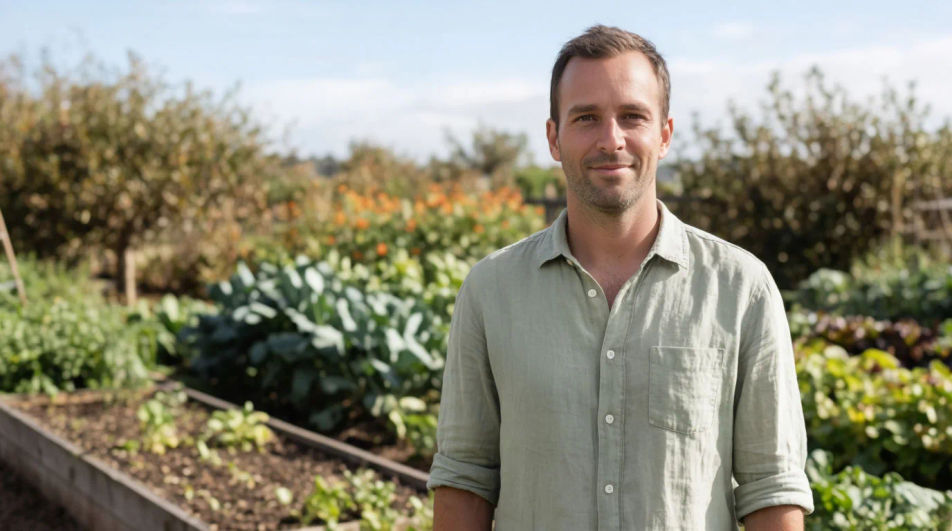
Cursos e videoaulas
Uma aula completa em um único plano. O professor tem o mesmo aspecto no minuto quatro e no minuto um, e não há nada para montar depois.
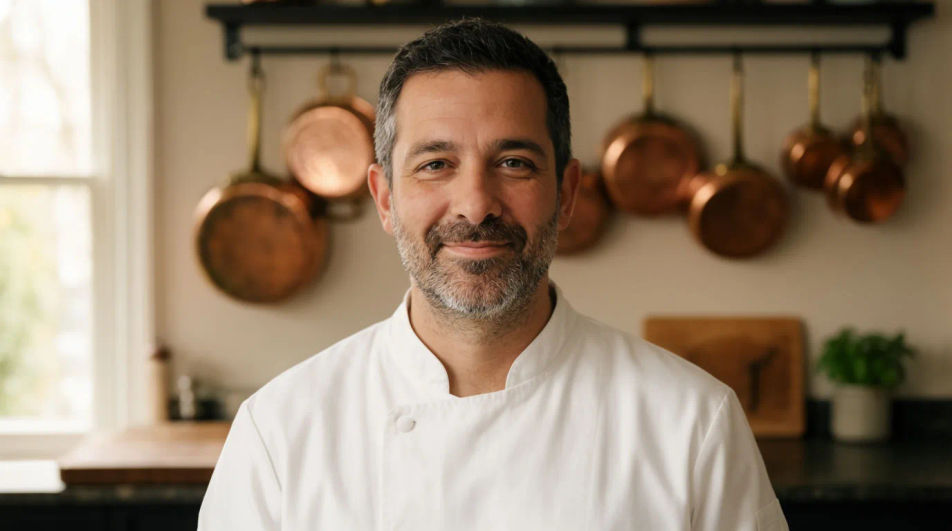
Vídeos explicativos e tutoriais
Grave ou gere a locução primeiro e deixe uma foto entregá-la, com as pausas e a ênfase que mantêm quem assiste até o fim.
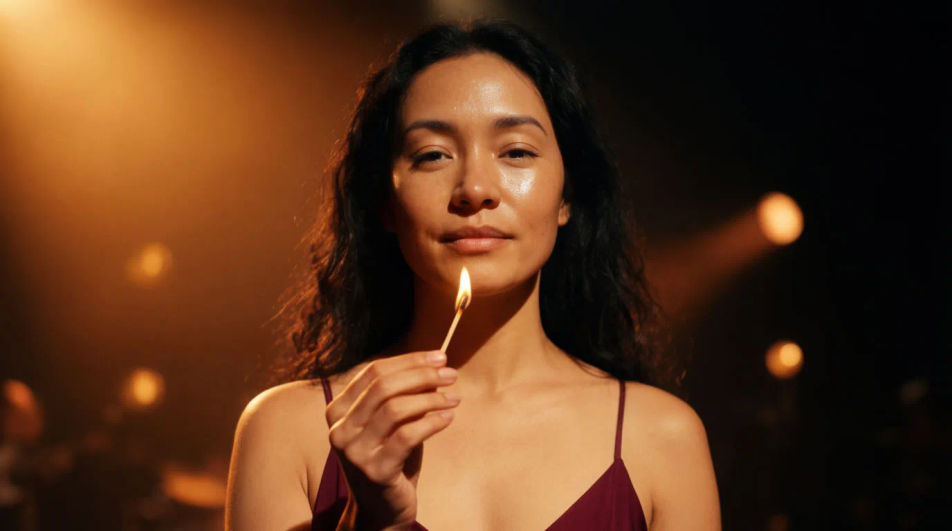
Clipes musicais
Entregue uma faixa cantada e o rosto carrega as notas longas, as respirações e o sentimento da música, não só a letra.
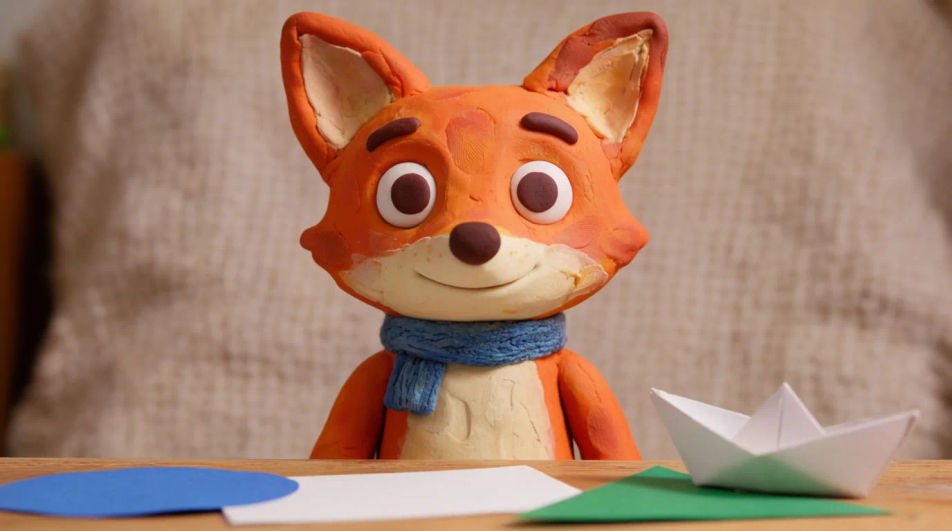
Mascotes e personagens
Dê voz a um mascote de marca, a um personagem de massinha ou a um herói ilustrado, para anúncios, conteúdo infantil e vinhetas de canal.
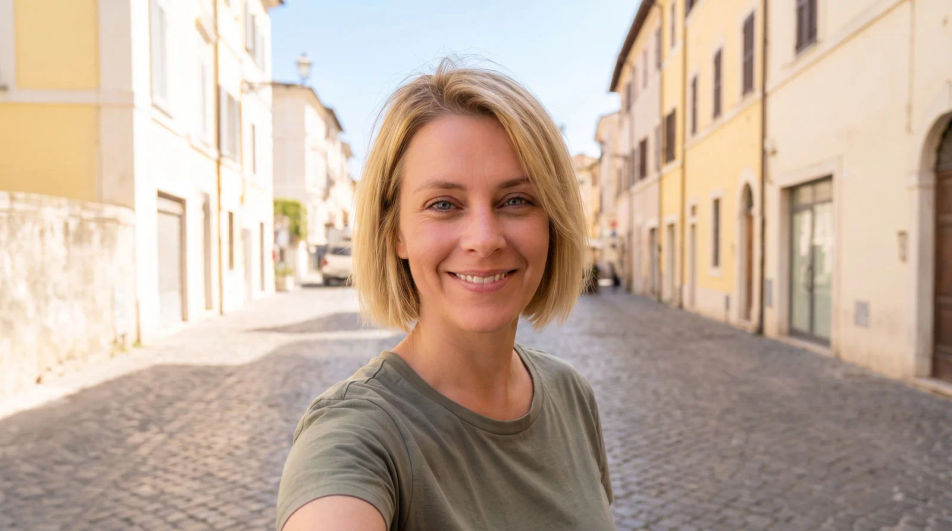
Vídeos para criadores e redes sociais
Clipes verticais falados para Reels, TikTok e Shorts, feitos a partir de uma foto estilo selfie e uma faixa de voz, prontos para postar.
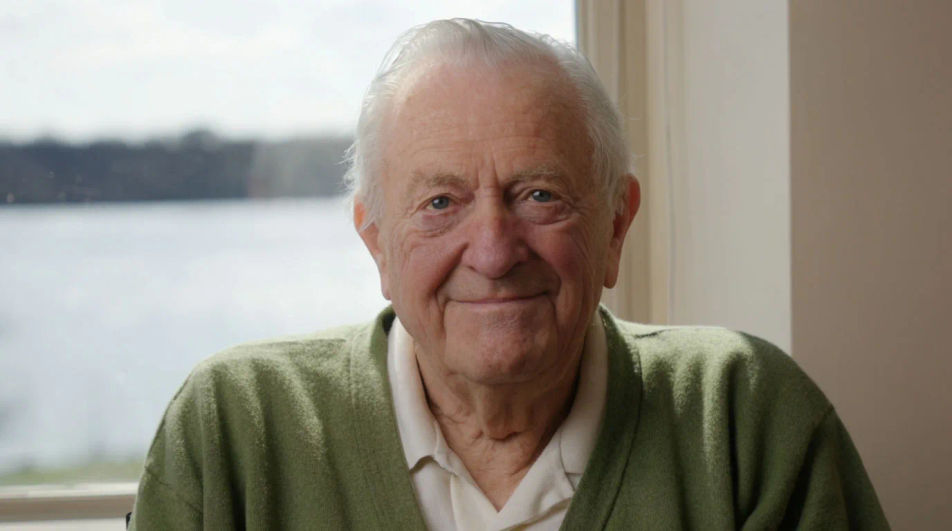
Histórias e podcasts
Histórias longas mantêm o ritmo, da construção silenciosa até o desfecho, sem que quem fala precise recomeçar a cada minuto.
Visão geral
O OmniHuman 2.0 é o modelo de vídeo humano guiado por áudio da ByteDance, lançado pela BytePlus em 15 de outubro de 2026. Ele transforma uma foto e uma faixa de áudio em um vídeo daquela pessoa interpretando a faixa. Em vez de só casar o formato da boca com o som, ele lê o tom, a emoção e as palavras. Um único plano agora chega a 5 minutos, contra 60 segundos, sem emendas (fonte). Para quem faz videoaulas, conteúdo para Reels, TikTok e Kwai ou clipes com um mascote, isso significa um avatar falante que aguenta o vídeo inteiro.
O que o OmniHuman 2.0 faz de diferente
A maioria dos modelos de foto falante só mexe a boca no ritmo do som. O OmniHuman 2.0 escuta como a frase é dita. Uma história sussurrada para dormir, um grito de incentivo do treinador e uma nota longa de música saem como atuações diferentes, mesmo partindo do mesmo tipo de entrada.
O plano mais longo pesa tanto quanto isso. Uma aula, uma história ou uma música completa roda em uma única tomada. Por isso não existe a emenda em que o rosto, a luz ou o fundo poderiam mudar.
O OmniHuman 2.0 no Morphic
O OmniHuman 2.0 chega em breve ao Morphic. Até lá, o Veed Fabric faz o mesmo trabalho: abra o Copilot, anexe uma foto e uma faixa de áudio e peça um vídeo falante. Todos os clipes desta página foram feitos assim. Para tirar o melhor resultado, veja o guia do OmniHuman 2.0.
Preços simples
Comece grátis hoje mesmo, com a opção de fazer upgrade ou cancelar quando quiser.
Basic
2400 mensal créditos
1 apenas usuário
Todos os modelos
Workflows
Standard
3625 mensal créditos
1 apenas usuário
Todos os modelos
Workflows
Pro
6350 compartilhado mensal créditos
1 usuário
Todos os modelos
Workflows
Max
24650 compartilhado mensal créditos
1 usuário
Todos os modelos
Workflows
Enterprise
Para limites maiores
Personalizado
termos de preços e cobrança

Free
Para experimentar
$0
grátis para sempre
Perguntas frequentes
Mais sobre o OmniHuman 2.0
Guias, prompts e comparações para o OmniHuman 2.0.
Outros modelos
Explore o restante do catálogo de modelos do Morphic.
Mirelo SFX 2.0
Mirelo AI
O modelo da Mirelo que transforma vídeo em som. Som novo para o seu vídeo, o mesmo diálogo.
Fish Audio Drama 3
Fish Audio
O modelo de voz mais expressivo da Fish Audio. Você dirige a interpretação, palavra por palavra.
Vidu Q4
Shengshu Technology
O mais novo modelo de vídeo da Shengshu. Até 12 imagens e 3 vozes mantidas num só clipe, com áudio nativo de 540p a 4K.
Nano Banana 2.1
Google DeepMind
O novo modelo de imagem do Google DeepMind. Design melhor, edição limpa, personagens fiéis.