Seed Audio 1.5 es el próximo modelo de audio de escenas completas de ByteDance y llegará pronto a Morphic. Con un solo prompt devuelve diálogo, música, ambiente y efectos de sonido como pistas separadas, de hasta seis minutos. Esta guía explica cómo escribir para él. Si quieres probar prompts de escena desde ya, abre el generador de audio con IA de Seed Audio 1.5.
Cómo se construye un prompt de Seed Audio 1.5
Escribe la escena en el orden en que la oiría quien escucha: dónde estamos, quién habla, qué dice y qué pasa alrededor. Primero va la historia y después la lista de sonidos.
| Parte | Qué escribir | Ejemplo |
|---|---|---|
| Escena | Lugar, hora, clima, tamaño del espacio | [Noche. Un andén de metro casi vacío, se oye la lluvia en la entrada.] |
| Voz | Nombre, edad, acento, emoción, ritmo | Mara (30 años, voz tranquila, tono cansado) |
| Línea | Las palabras exactas, entre comillas | “Ya pasó el último.” |
| Efectos de sonido | La fuente y cómo se mueve | [Pasos sobre el concreto mojado que se alejan.] |
| Música | Género, instrumentos, ambiente, volumen | [Un pad de sintetizador grave bajo todo lo demás.] |
| Tiempo | Una marca de tiempo donde importa | [0:06] Empiezan los pasos. |
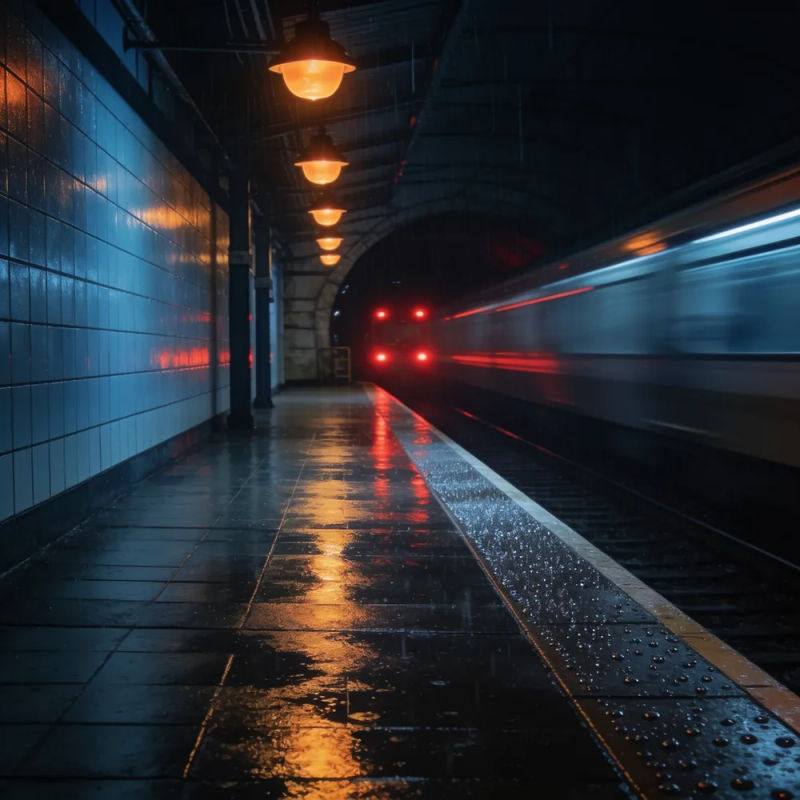
Seed Audio 1.5 todavía no está disponible. Por eso estas muestras se hicieron en Morphic, con voces y efectos de sonido de ElevenLabs y música de Lyria, mezclados para ajustarse a cada prompt.
Los cuatro modos de entrada de Seed Audio 1.5
Todos los modos parten de un prompt de texto. Lo que le sumas decide cuánto inventa el modelo y cuánto sigue.
| Modo | Qué añades | Ideal para |
|---|---|---|
| Texto | Nada más: el prompt describe cada voz y cada sonido | Primeros borradores, anuncios, bases sonoras para Reels |
| Texto + audio | Hasta seis clips de referencia para las voces | Un reparto que se repite, una voz narradora que ya usas |
| Texto + video | Un clip de video que el modelo observa | Doblaje, musicalizar un corte, diseño sonoro a imagen |
| Texto + audio + video | Video más referencias de voz | Doblaje con un reparto fijo a lo largo de los episodios |
Marcas de tiempo en Seed Audio 1.5
Seed Audio 1.0 aceptaba una ventana de tiempo en los diálogos, por ejemplo [5.5s:8.0s]. Seed Audio 1.5 extiende las marcas de tiempo a los efectos de sonido y a las entradas de música. Así, una puerta, un golpe musical o un crescendo caen donde tú los pones y no donde el modelo supone.
- Marca solo los momentos que deben coincidir con la imagen: una línea en un corte, un impacto en un golpe, un crescendo en una revelación.
- Deja el resto sin marcar. El sonido de sala y la música de fondo suenan más naturales cuando el modelo los coloca.
- Mantén las marcas en orden y deja un poco de espacio entre líneas, para que las voces no se superpongan por accidente.
[0:00] Murmullo del público en una sala pequeña. [0:04] Se apagan las luces con un clic. [0:05] Voz de bienvenida (cálida, en voz baja): “Bienvenidos a todos.” [0:09] Un solo acorde de piano.
Referencias de voz en Seed Audio 1.5
Añade hasta seis clips de referencia, uno por personaje. Etiqueta cada uno en el prompt para que el modelo sepa qué voz dice cada línea. La referencia define cómo suena la voz. El prompt define la interpretación.
| Para dirigir | Escríbelo así |
|---|---|
| Emoción | (referencia 2; con dolor, conteniendo el llanto) |
| Estilo | (referencia 1; tono seco y sobrio, con un toque de humor) |
| Ritmo | (referencia 3; lento, con pausas largas entre oraciones) |
| Sonidos que no son habla | (referencia 1; un suspiro antes de la línea, una risa breve después) |
Usa grabaciones limpias de una voz sobre la que tengas derechos. La voz de una persona real requiere su permiso.
Doblaje y traducción de video con Seed Audio 1.5
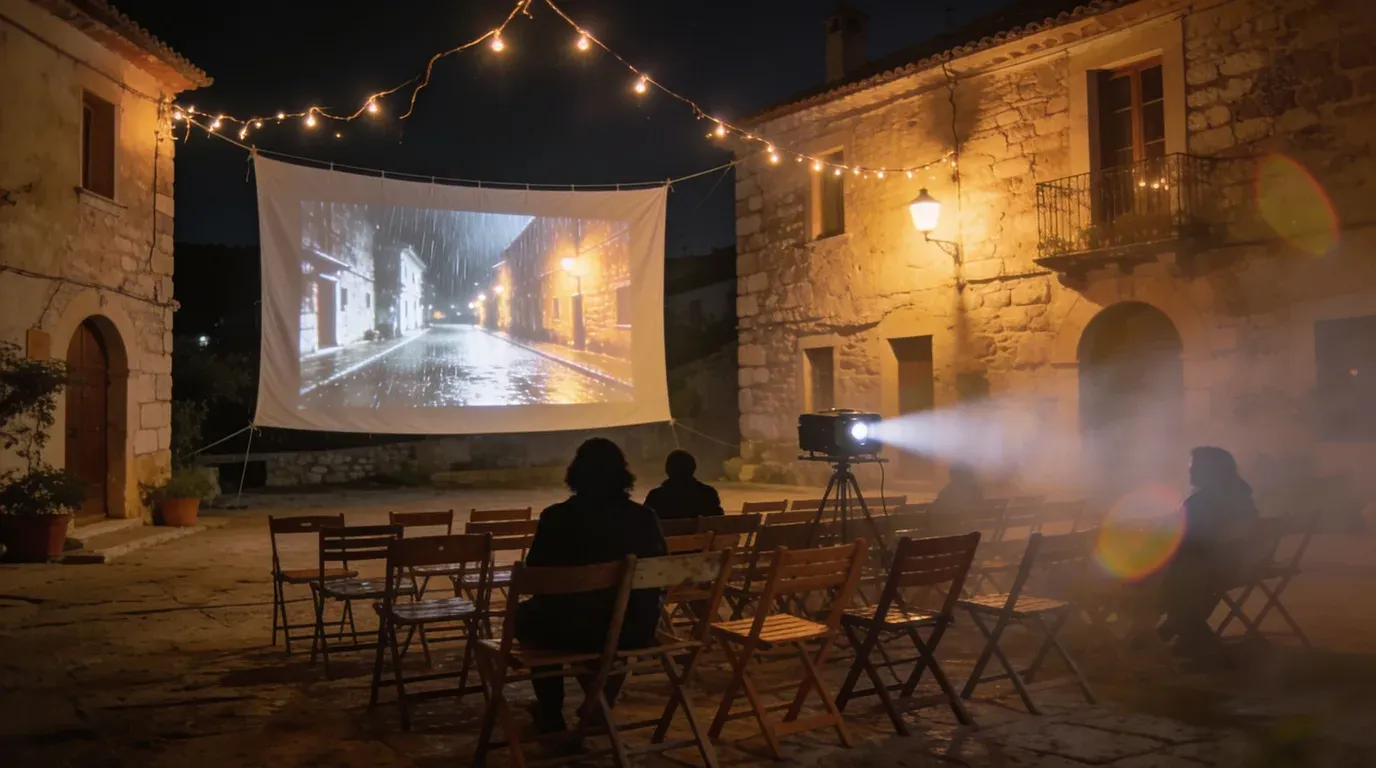
Dale un video a Seed Audio 1.5 y escribirá la voz en off, la música, los efectos y el ambiente siguiendo la acción. El modelo tiene presente el contexto de todo el clip. Para traducir, reemplaza el idioma hablado y conserva los efectos de sonido y la música originales.
- Describe la voz de cada hablante o añade una referencia, para que el doblaje mantenga el mismo reparto en todos los idiomas.
- Di qué conservar: “conserva la música y los efectos originales, reemplaza solo el diálogo”.
- Pide a alguien que hable el idioma con fluidez que revise la pronunciación, el sentido y el fraseo antes de publicar.
¿Quieres llevar un video en inglés al español latino? Hoy en Morphic, el doblaje de video con IA traduce un clip y le cambia la voz. La guía de doblaje y localización cubre los subtítulos, el lip sync y la edición final.
Traduce el diálogo al español latino. Conserva la música y los efectos de sonido originales. Voz narradora: cálida y relajada, con el mismo ritmo que el original.
Pistas separadas en Seed Audio 1.5
Seed Audio 1.0 devolvía un solo archivo mezclado. Seed Audio 1.5 devuelve el diálogo, el ambiente, los efectos y la música como pistas separadas, y puede dividir el diálogo por voz. Presiona reproducir para escuchar una escena de tormenta y silencia o aísla cualquier pista mientras suena. Cada voz tiene su propio carril.
| En la edición | Qué te permiten las pistas separadas |
|---|---|
| Volumen | Baja la música bajo una línea sin tocar las voces |
| Silenciar | Quita los efectos para un corte más tranquilo, o el diálogo para una base de tráiler |
| Reemplazar | Cambia la línea de un personaje o una sola señal y conserva el resto de la escena |
| Reutilizar | Pon el mismo ambiente bajo la escena siguiente para que el lugar suene continuo |
Seed Audio 1.5 frente a Seed Audio 1.0: qué cambió
La página de Seed Audio 1.0 de ByteDance mencionaba la entrada de video, el audio más largo y la salida multipista como próximos pasos. Según el brief previo al lanzamiento que aparece en Segmind, Seed Audio 1.5 incorpora las tres.
| Seed Audio 1.0 | Seed Audio 1.5 | |
|---|---|---|
| Duración por generación | 2 minutos | 6 minutos |
| Referencias de voz | 3 | 6 |
| Idiomas | 20 | 30 |
| Entradas | Texto, referencias de audio, una imagen | Suma video |
| Salida | Una pista mezclada | Diálogo, ambiente, efectos y música por separado |
| Marcas de tiempo | Líneas de diálogo | Líneas, efectos y señales de música |
| Canciones con letra | No | Sí |
La mayoría de los prompts de Seed Audio 1.0 sirven sin cambios. Para el detalle completo de los prompts de 1.0, consulta la guía de Seed Audio 1.0.
Preguntas frecuentes
Seed Audio 1.5 llegará pronto. ByteDance compartió el conjunto de funciones con socios, pero todavía no abre el acceso público. Mientras tanto, Seed Audio 1.0 está disponible en Morphic.
Llegará pronto a Morphic. Hoy puedes armar escenas completas con Seed Audio 1.0, y con ElevenLabs, Lyria y los demás modelos de audio en el mismo Canvas.
Escribe las líneas en el idioma en que quieres oírlas. Las indicaciones de escena y de voz pueden ir en español o en inglés, como te resulte más cómodo. Cada línea, en cambio, va en su idioma de destino. Antes de publicar, pide a alguien que hable ese idioma con fluidez que revise la pronunciación, el sentido y el fraseo. Si tu público es de un país concreto, mejor que sea alguien de ahí: el acento y las expresiones cambian de un país a otro.
Sí. La estructura de escena, voz, línea y efecto es la misma. Para aprovechar lo nuevo, añade un video, más referencias de voz, marcas de tiempo en los efectos y la música, o pide pistas separadas.
Solo con su permiso. Los límites de ByteDance bloquean las imitaciones reconocibles de la voz de una persona real sin su consentimiento. También bloquean el material con derechos de autor y las letras existentes. Las referencias deben ser grabaciones que tengas derecho a usar.