Gemini Omni
de Google DeepMind
El primer modelo de IA any‑to‑any de Google.
Entra texto, imágenes, audio y video; sale un solo video.
Funciones clave
Especificaciones técnicas
Omni Flash
Primer modelo de la familia Gemini Omni de Google
Video
La salida de imagen y audio está en la hoja de ruta de Gemini Omni
Up to 10s
Los clips Flash se limitan a 10 segundos en el lanzamiento para ampliar el acceso
720p
Gemini Omni Flash genera video en 720p
Any mix
Texto, imagen, audio y video en un solo prompt
Native
Audio sincronizado generado con cada clip; voz mediante Avatars
SynthID
Marca de agua imperceptible de procedencia de IA en cada clip
Google DeepMind
Posicionado como sucesor de Veo para la creación de video any-to-any
Casos de uso
Storyboard con múltiples entradas
Entran una imagen de personaje, una foto de locación, una pista musical y un beat; el modelo arma la toma e itera.
Edición de video conversacional
Edita cualquier clip en lenguaje simple: cambia el vestuario, cambia un fondo o reajusta el tiempo de un beat. El resto se mantiene estable.
Video de marketing
Cortes publicitarios que respetan los colores de marca, la forma del producto y el texto en pantalla. Una foto, un brief, un spot terminado.
Explicativos educativos
Visualiza ciencia, historia e ingeniería con física integrada. La ciencia se mantiene fiel y el material, limpio.
Video con vocero
Un retrato más una referencia de voz da el mismo presentador en cámara en shorts, cursos y recorridos.
Shorts para redes
Los clips de 10 segundos caben en YouTube Shorts, Reels y TikTok. Genera variaciones y publica la que funciona.
Ejemplos de prompts
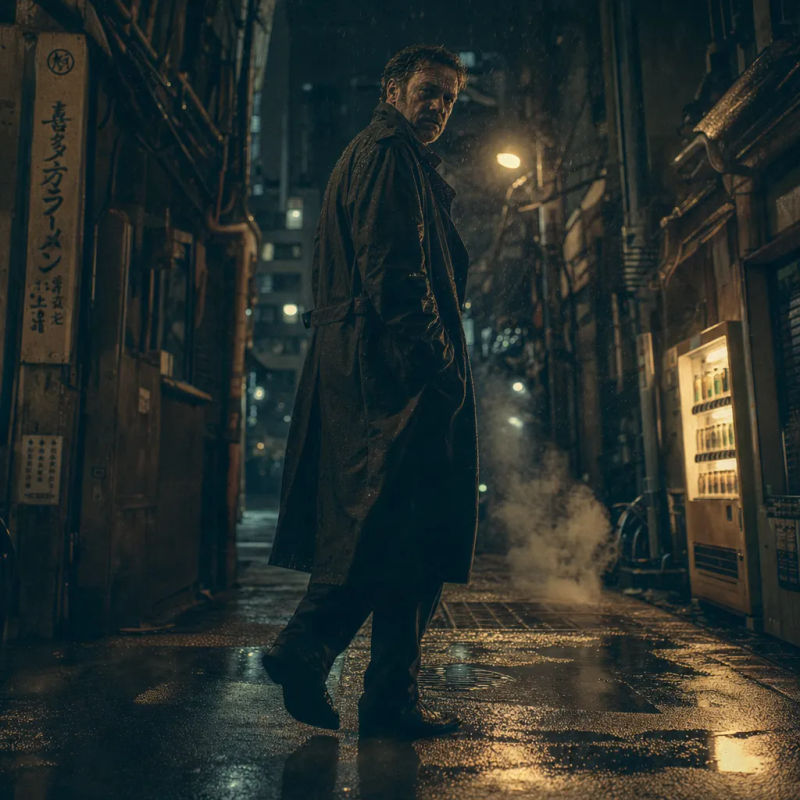
Noir cinematográfico
Detective en un callejón de Tokio bajo la lluvia, resplandor de lámparas de sodio, noir en tonos verde azulado y ámbar
Edit prompt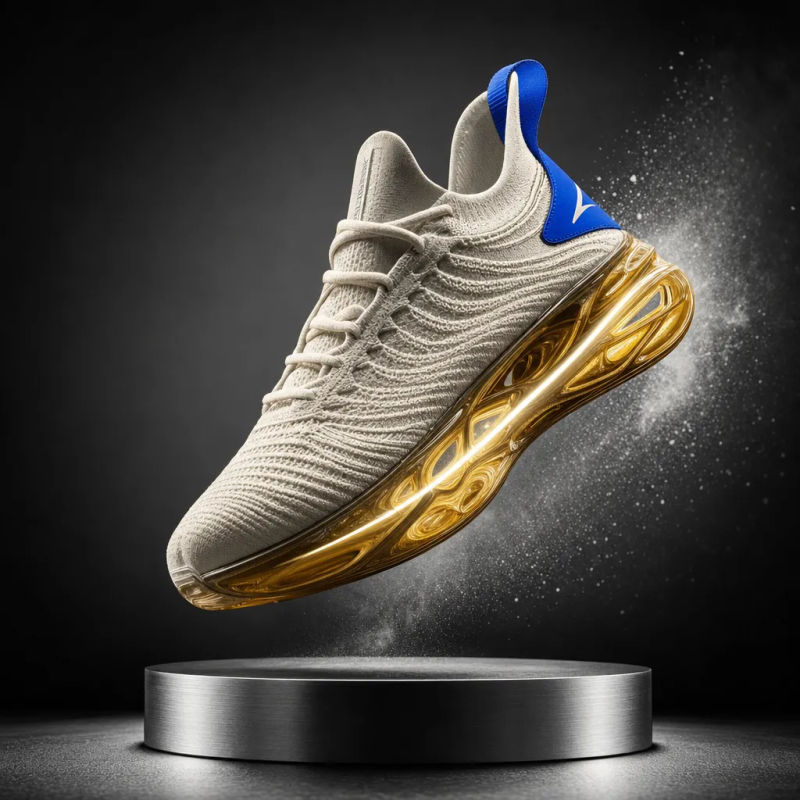
Lanzamiento de producto
Tenis vanguardista suspendido en el aire sobre un pedestal de titanio, luz principal dura, ambiente de lanzamiento
Edit prompt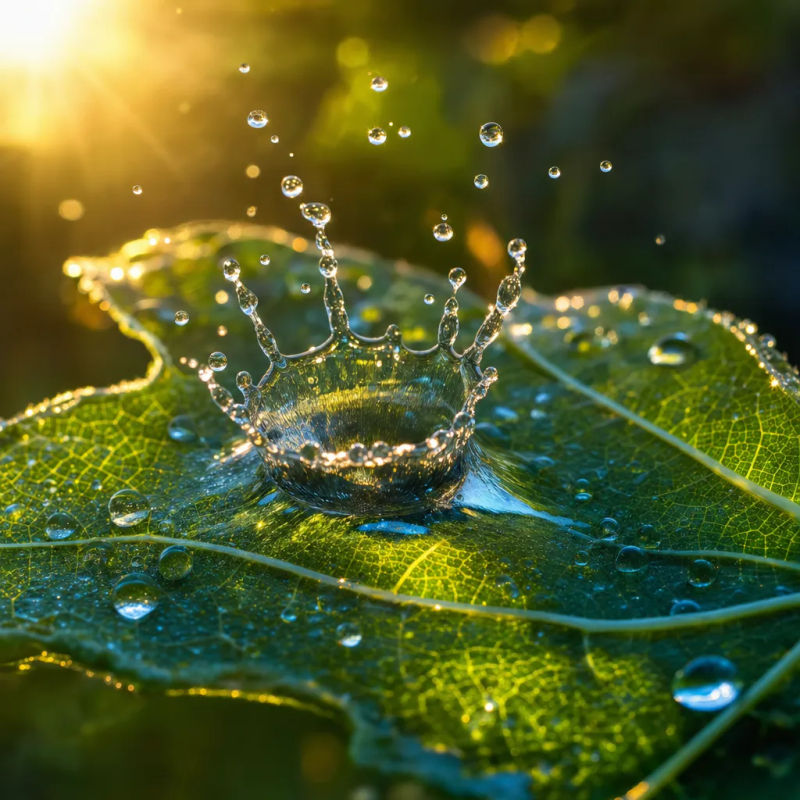
Explicativo de naturaleza
Gota congelada como una corona cristalina sobre una hoja con rocío, macro a contraluz al amanecer
Edit prompt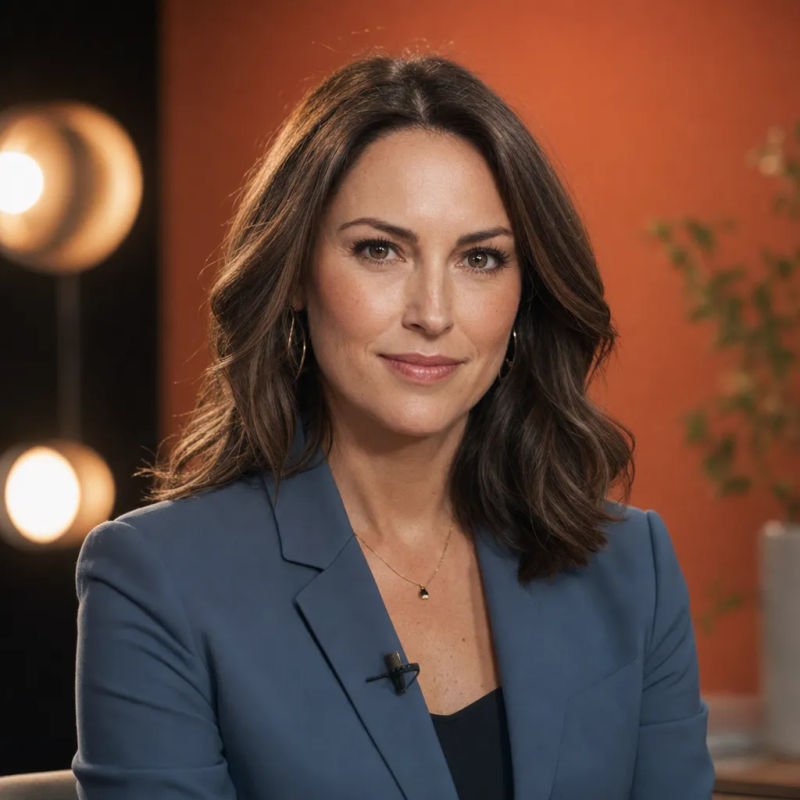
Vocero avatar
Presentador de estudio sereno mirando al lente, luz cálida de tres puntos, bokeh de 85mm
Edit prompt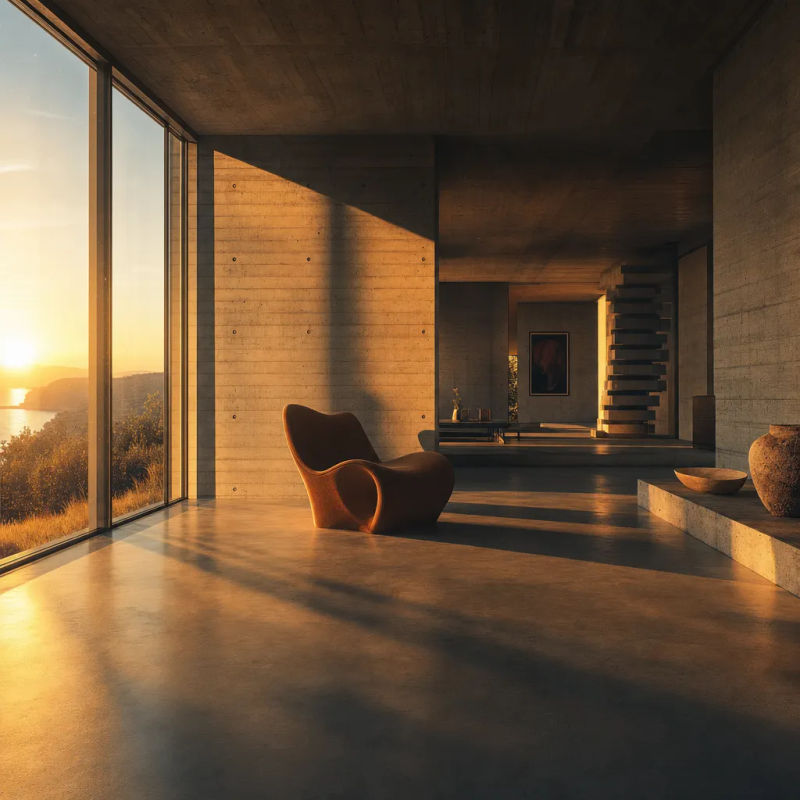
Recorrido arquitectónico
Luz de hora dorada a través de una villa brutalista de concreto, sombras largas, polvo flotando
Edit prompt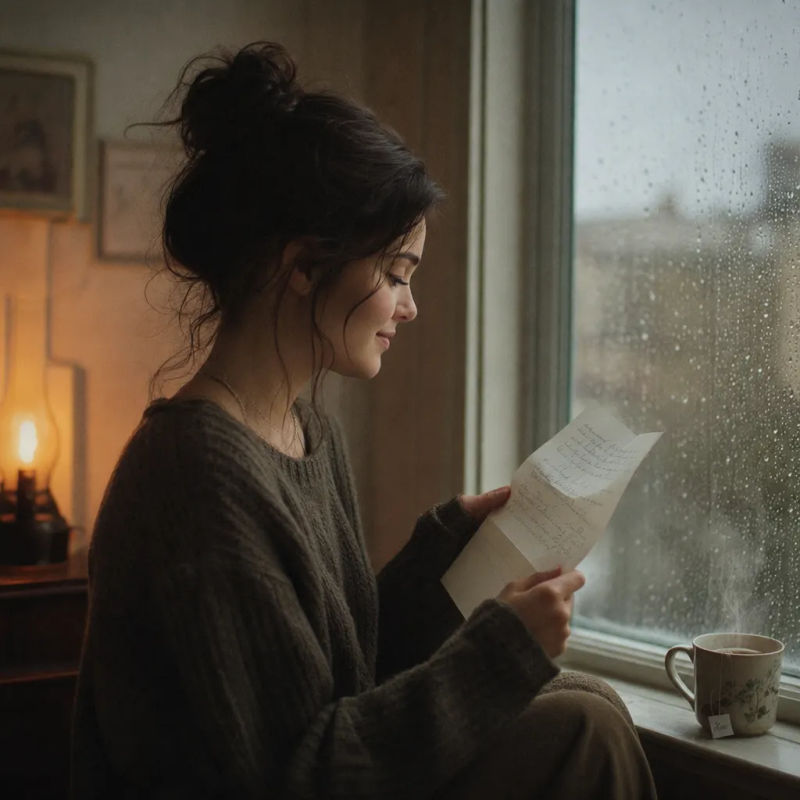
Momento narrativo
Mujer junto a una ventana con gotas de lluvia leyendo una carta, la preocupación se relaja hacia el alivio
Edit promptDescripción general
Gemini Omni es el primer modelo multimodal any-to-any de Google, presentado en Google I/O 2026 el 19 de mayo de 2026. La primera versión, Gemini Omni Flash, acepta texto, imágenes, audio y video en un solo prompt y produce un solo video, con edición conversacional, consistencia de personajes, física precisa y marca de agua SynthID en cada clip.
Qué hace diferente a Gemini Omni
En lugar de unir modalidades, Gemini Omni razona entre ellas. Un prompt que incluye una referencia de retrato, una foto de locación, una muestra de voz y un beat de una línea da como resultado una sola toma que refleja cada entrada a la vez. Los prompts siguientes editan esa misma escena, no una nueva, así que los personajes, la iluminación y la continuidad se mantienen entre turnos.
Gemini Omni en Morphic
En Morphic, Gemini Omni está en el selector de modelos de video junto a Veo 3.1, Seedance 2.0, Kling y el resto del catálogo de video. Cambia la barra de prompt al modo Video, elige Gemini Omni, adjunta referencias en cualquier combinación y sigue editando la misma escena con prompts posteriores.
Precios simples
Comienza gratis hoy, con la opción de mejorar tu plan o cancelar cuando quieras.
Basic
1100 mensual créditos
1 usuario
Todos los modelos
Workflows
Standard
3625 mensual créditos
1 usuario
Todos los modelos
Workflows
Pro
6350 compartidos mensual créditos
1 usuario
Todos los modelos
Workflows
Pro Max
24650 compartidos mensual créditos
1 usuario
Todos los modelos
Workflows
Enterprise
Para límites más altos
Personalizado
términos de precios y facturación
Free
Para experimentar
$0
gratis para siempre
Preguntas frecuentes
ChatGPT Images 2.5
OpenAI
El modelo de imagen de OpenAI, de septiembre de 2026. Más detalle, ediciones precisas, más rápido.
Lyria 3.5
Google DeepMind
El mejor modelo musical de Google. Canciones con estructura, voz y letra.
MiniMax H3 Max Turbo
fal.ai
El nivel rápido del H3 afinado por fal. El doble de rápido, casi igual de bueno.
Inworld TTS 2
Inworld
95 voces y más de 100 idiomas. La voz arranca en menos de un segundo.