OmniHuman 2.0
de ByteDance
El modelo de video con humanos de ByteDance, guiado por audio.
Una foto, una pista, cinco minutos en una toma.
Funciones clave
Las especificaciones son las del propio BytePlus, tomadas de su anuncio de lanzamiento del 15 de octubre de 2026. Los clips de esta página se hicieron en Morphic antes del lanzamiento de OmniHuman 2.0 en la plataforma, con Veed Fabric, que también convierte una foto y una pista de audio en un video parlante de hasta 5 minutos.
Especificaciones técnicas
5 min
Una toma continua, según BytePlus
60 s
El tope de una sola toma antes de la versión 2.0
Foto + audio
Una imagen del intérprete y una pista
Cualquier pista
Voz, música o diálogo
Casos de uso
Cursos y clases
Una clase completa en una sola toma, ideal para cursos en línea. La persona que enseña se ve igual en el minuto cuatro que en el uno y no hay nada que montar.
Explicativos y videos de cómo hacerlo
Graba o genera primero la locución y deja que una foto la entregue, con las pausas y los énfasis que mantienen a quien mira.
Videos musicales
Dale una pista cantada y el rostro lleva las notas largas, las respiraciones y el sentimiento de la canción, no solo las palabras.
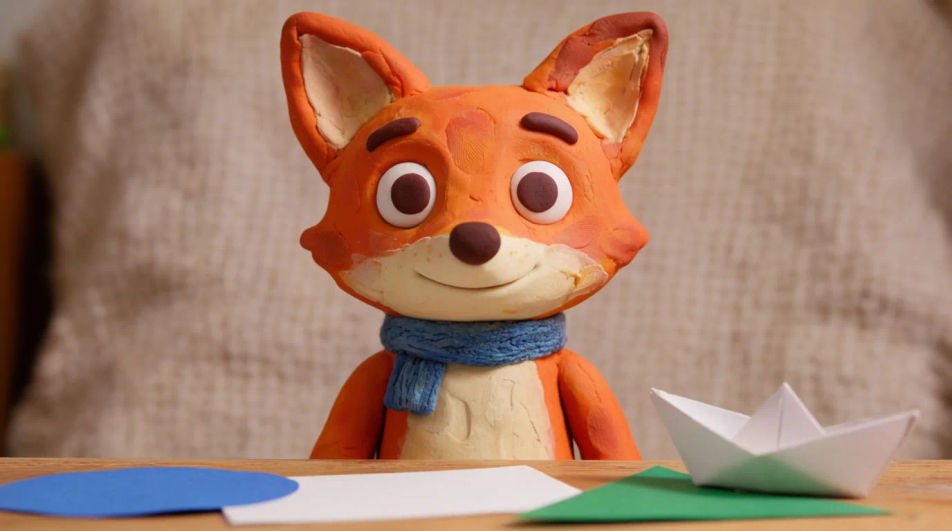
Mascotas y personajes
Dale voz a una mascota de marca, un personaje de plastilina o un héroe ilustrado para anuncios, contenido infantil e intros de canal.
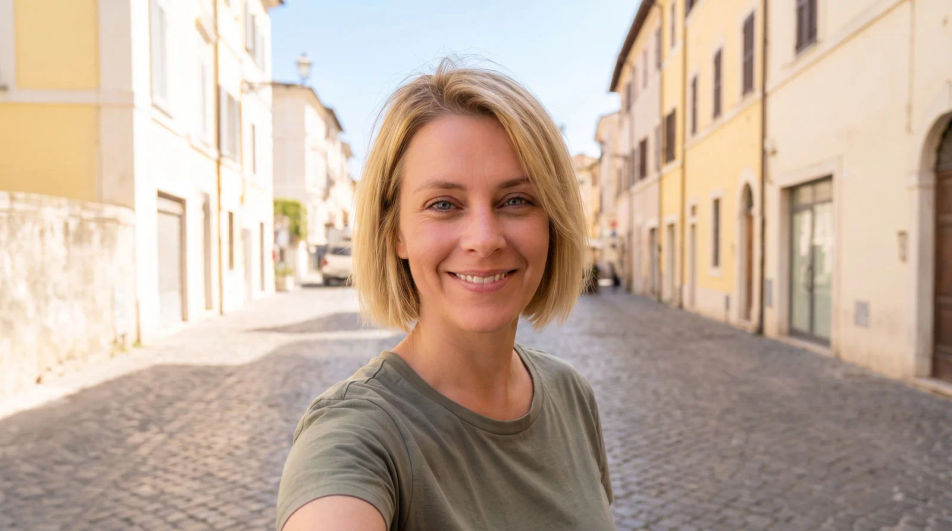
Videos para creadores y redes
Clips verticales para reels y shorts a partir de una sola foto tipo selfie y una pista de voz, listos para publicar.
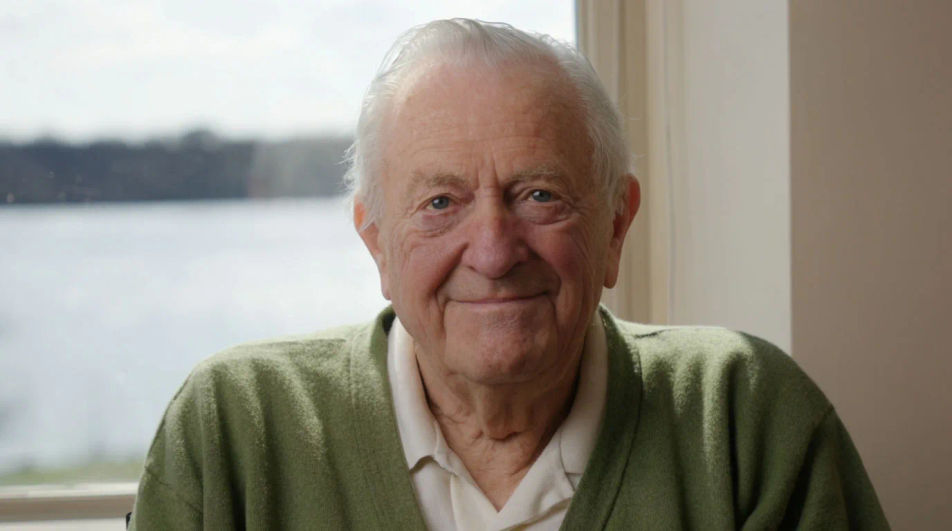
Historias y pódcast
Las historias largas mantienen su ritmo, desde la tensión tranquila hasta el remate, sin que el intérprete se reinicie cada minuto.
Descripción general
OmniHuman 2.0 es el modelo de video con humanos de ByteDance, guiado por audio. Salió a través de BytePlus el 15 de octubre de 2026. Con una foto y una pista de audio genera un video de esa persona interpretándola. Capta el tono, la emoción y las palabras, y no se queda en ajustar la boca. Una sola toma ya puede llegar a 5 minutos, frente a los 60 segundos anteriores, sin unir piezas (fuente).
Qué hace distinto OmniHuman 2.0
La mayoría de los modelos de foto parlante mueven la boca al ritmo del sonido. OmniHuman 2.0 escucha cómo se dice cada línea. Un cuento susurrado para dormir, la indicación gritada de un entrenador y una nota sostenida en una canción salen como interpretaciones distintas, aunque la entrada sea del mismo tipo.
La toma larga pesa tanto como eso. Una clase, una historia o una canción completa corre en un solo plano, así que no hay un corte donde el rostro, la luz o el fondo puedan cambiar. Si das cursos en línea o publicas en redes, ahorras el trabajo de armar una clase en pedazos.
OmniHuman 2.0 en Morphic
OmniHuman 2.0 ya está disponible en Morphic: abre Copilot, adjunta una foto y una pista de audio, y pide un video parlante con OmniHuman 2.0. Los clips de esta página se hicieron igual con Veed Fabric, antes del lanzamiento de OmniHuman 2.0. Para sacar el mejor resultado, consulta la guía de OmniHuman 2.0.
Precios simples
Comienza gratis hoy, con la opción de mejorar tu plan o cancelar cuando quieras.
Basic
2400 mensual créditos
1 usuario
Todos los modelos
Workflows
Standard
3625 mensual créditos
1 usuario
Todos los modelos
Workflows
Pro
6350 compartidos mensual créditos
1 usuario
Todos los modelos
Workflows
Max
24650 compartidos mensual créditos
1 usuario
Todos los modelos
Workflows
Enterprise
Para límites más altos
Personalizado
términos de precios y facturación

Free
Para experimentar
$0
gratis para siempre
Preguntas frecuentes
Más sobre OmniHuman 2.0
Guías, prompts y comparaciones para OmniHuman 2.0.
Otros modelos
Explora el resto del catálogo de modelos de Morphic.
Seedream 5.5
ByteDance
El modelo de imágenes Seedream de ByteDance, lanzado en noviembre de 2026. Edición multirronda limpia, realismo y texto más nítido.
Gemini Omni Flash 1.2
Google DeepMind
El modelo de video de Google, ahora con tomas de quince segundos. Edita la toma completa por 30% menos cada segundo.
ChatGPT Images 2.6
OpenAI
Modelo de imágenes de OpenAI, de noviembre de 2026. GIF animados, SVG y borradores más rápidos.
SAM 3.1
Meta
El modelo Segment Anything de Meta. Rastrea cualquier sujeto con una máscara que lo sigue.