Todos los modelos de video
Un solo espacio de trabajoHecho con Gemini Omni Flash 1.1
Funciones clave
Edición por conversación
Dices el cambio y cae sobre la misma toma: otro cielo, otro letrero. Lo que no mencionaste queda tal como se filmó.
Extensión de video
Haz crecer el clip de diez en diez segundos, hasta una escena de 40. La unión sale de tus cuadros finales y el movimiento sigue.
Referencia a video
Hasta diez imágenes y tres clips cortos guían una generación, cada uno marcado en el prompt como sujeto, estilo o escenario.
Consistencia de personaje
Rostros, vestuario y voces se sostienen entre cortes y entre ediciones, sin volver a subir la referencia en cada turno.
Audio y diálogo nativos
El sonido nace junto con la imagen: diálogos, efectos, ambiente y música al ritmo de la acción. Escribe el audio en el prompt.
Salida hasta 4K
Bocetas en 360p, cierras la toma en 720p y entregas esa misma toma en 1080p o 4K con el upscale incluido, desde un solo prompt.
Lo que genera Gemini Omni Flash 1.1
Escenas con sonido, desde una frase
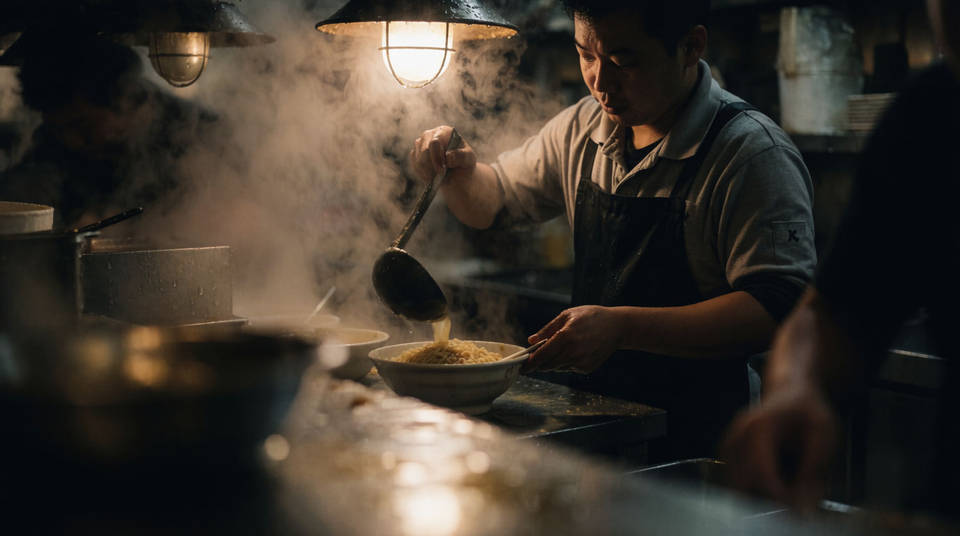
Escribe la toma y el audio juntos y los dos vuelven a la vez: la acción, el ambiente del lugar y la línea que dice el personaje, con los labios sincronizados. El sonido que nombras es el sonido que recibes.
Ediciones que escribes
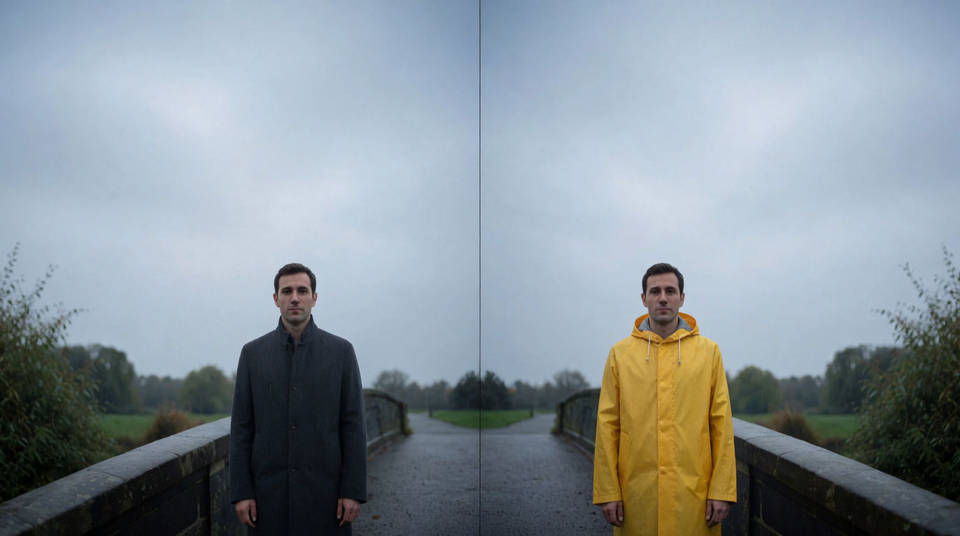
Genera y después dirige: cambia la luz de la escena, el vestuario, el letrero. Cada instrucción cae sobre la misma toma mientras todo lo que no mencionaste queda tal como se filmó.
Escenas que crecen a 40 segundos
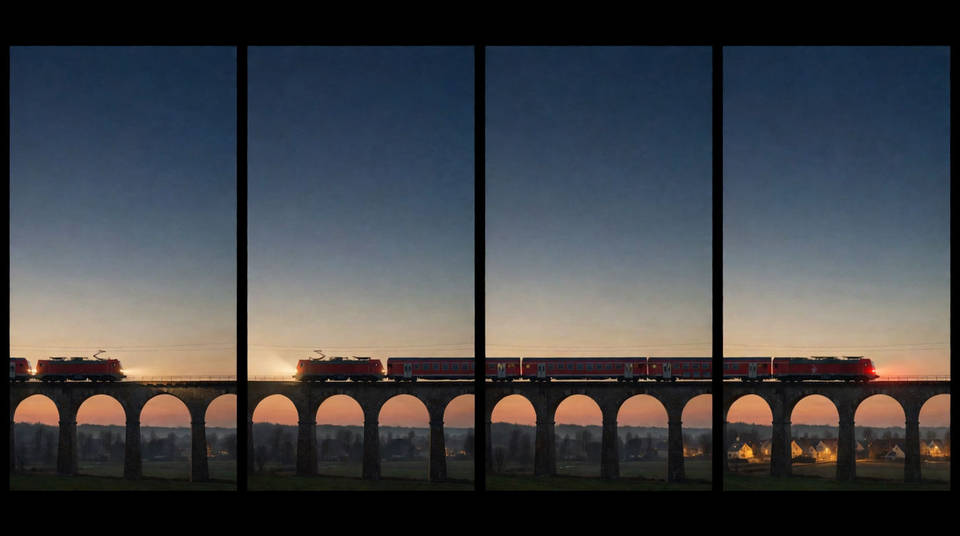
Arranca con un tiempo de diez segundos y extiéndelo de diez en diez. El modelo lee tus cuadros finales y continúa el movimiento, el elenco y la música, así que las uniones se leen como una sola toma.
Personajes y productos fieles a la referencia
Hasta diez imágenes y tres clips cortos fijan quién y qué aparece en la toma. Un personaje conserva su rostro, su ropa y su voz desde la primera generación hasta la última edición.
Genera un video en tres pasos
- 01
Abre Morphic
Regístrate y empieza a generar en un canvas visual libre e infinito.
- 02
Escribe la toma con su sonido
Sujeto, acción, cámara, luz y el audio. Di en qué momento pasa cada cosa, y si corre como una sola toma continua o con cortes.
- 03
Genera y después dirige
Afina la toma en los turnos siguientes: un cambio por turno, y extiéndela cuando la escena pida más aire.
Cinematic scene
One image to a 9-scene cinematic video.
Time-freeze effect
Cinematic time-freeze short film for any scene
Put yourself in a movie
Drop in a photo of yourself. Get a 12-second cinematic movie with animation and a matched soundtrack.
Next scene in sequence
Continues your scene sequence with perfect character consistency across frames.
Renovation timelapse
Photo of any real-estate becomes a cinematic renovation timelapse video with construction SFX and music.
Short film creator
Go from any idea to a finished short film with scenes, visuals, video, and music.
Todo en Morphic
Tu stack de video completoModelos
Gemini Omni, Veo 3.1, Seedance 2.5, Kling 3.0 y más. Elige el que le sirve a la toma y cámbialo a media producción.
Frames to video
Pon de 2 a 5 keyframes, describe el movimiento y Morphic rellena el intermedio. Time Control ajusta cuánto sostiene cada cuadro.
Lip sync
Ajusta una actuación a una línea grabada, o dale otra voz a un personaje, sin regenerar la toma a su alrededor.
Workflows
Convierte una secuencia terminada en un Workflow de un clic. Vuelve a correrlo, comparte el enlace o guárdalo para reusarlo rápido.