Bernini
ByteDance 提供
ByteDance のオープンソース動画モデル。
指示ベースで編集し、被写体の同一性を維持。
主な機能
技術仕様
Planner + DiT
Qwen2.5-VLプランナー、14BのWan2.2レンダラー
Edit, Generate, R2V
編集、生成、subject-to-video
480p / 16fps
デフォルトのレンダリング設定
Apache 2.0
オープンウェイト、セルフホスト可能
活用事例
実写映像の拡張
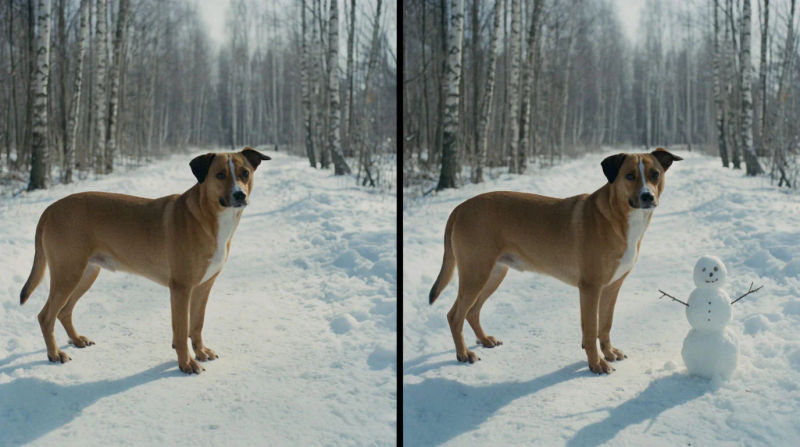
撮り直さずに、クリップ内の小道具を追加・削除したり、ディテールを修正したり、要素のスタイルを変えたりできる。一貫性の固定によりショットの他の部分は同一のまま保たれ、編集が自然になじむ。
繰り返し登場するキャラクターやアバター
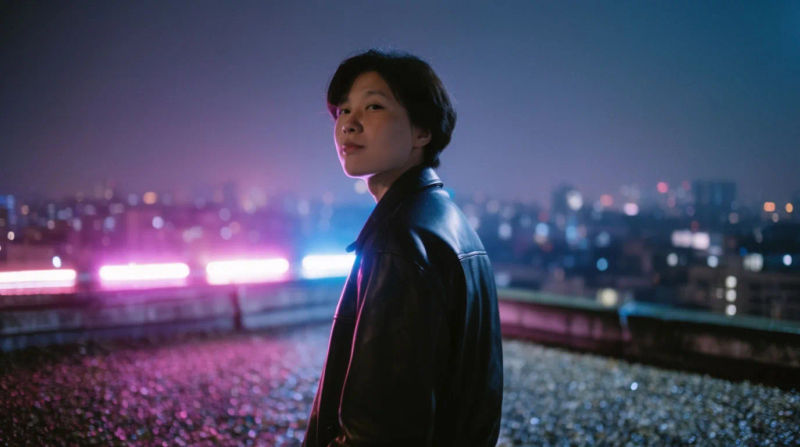
エピソード、広告、アバターシリーズを通じて同じ顔を保つ。subject-to-videoは数枚のリファレンス画像から人物の同一性を維持し、新しいシーンの中で動かせる。
バーチャル試着と商品の配置
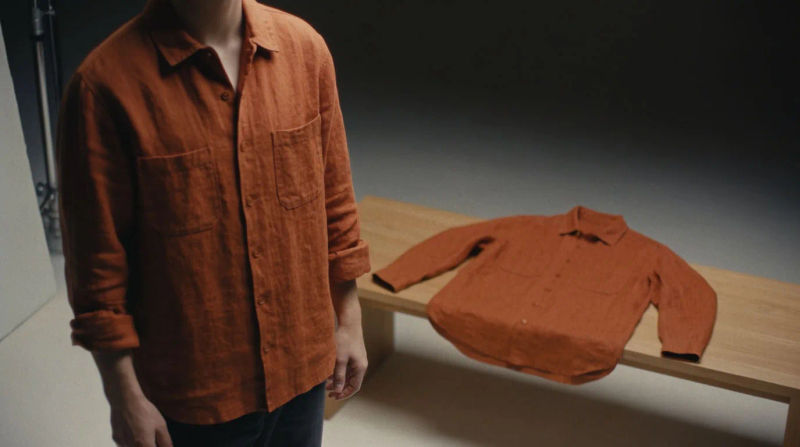
リファレンスから動いているモデルに衣服を着せ替えたり、商品や画面表示の動画をショットに挿入したりできる。ソースのクリップをそのまま保つ必要があるファッションや広告の制作に向く。
アクションの再構成
撮り直さずに、テイク内で誰かの動作を変える。例えば立ち姿勢をしゃがむ姿勢に変えられる。モーション編集はアクションを変えつつ、同一性、フレーミング、照明は固定したままにする。
プロンプト例
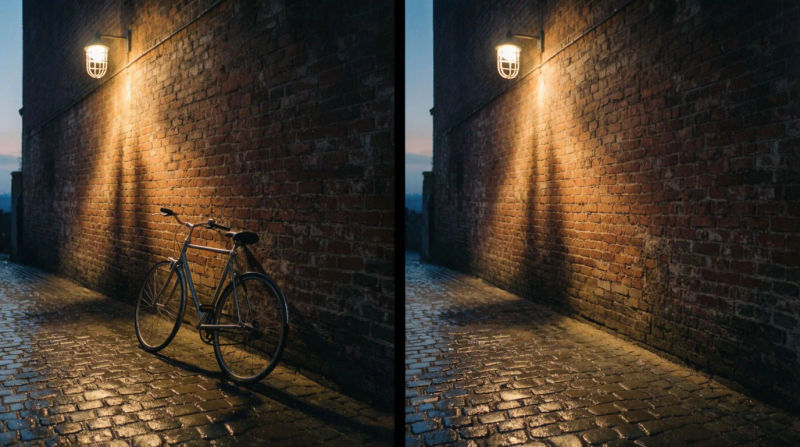
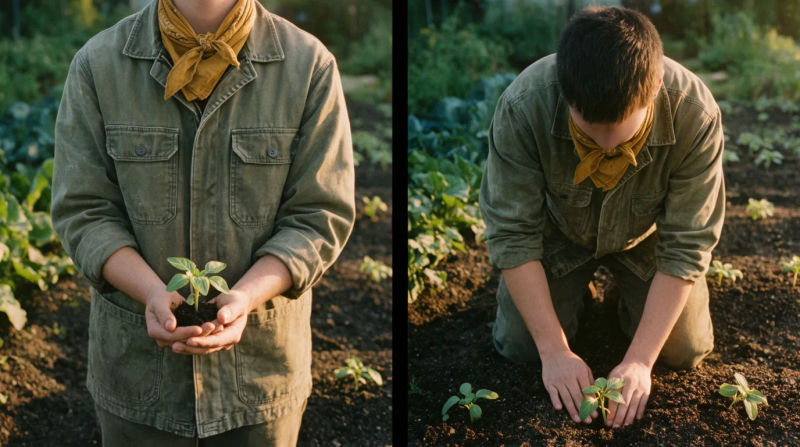
概要
BerniniはByteDanceによる、AI動画の生成と編集のためのオープンソースフレームワークで、2026年6月にApache 2.0で公開されました。その設計は作業を2つに分けます。MLLMベースのプランナー(Qwen2.5-VL)が結果のセマンティクスを決定し、その後Wan2.2をベースにしたDiTベースのレンダラーがピクセルを描画します。プランとレンダリングが別々の段階になっているため、Berniniはほとんどの動画モデルが苦手とすること、つまり実写クリップを編集しながら、変更を指示していない部分はすべて手つかずのまま残すことに、際立って優れています。テキストから画像、画像編集、テキストから動画、指示ベースの動画編集、衣装の入れ替えや動画挿入といったリファレンスガイド編集、そしてsubject-to-videoまでをカバーし、subject-to-videoでは新しいシーンの中で動く人物の同一性を維持することが際立った成果です。
シンプルな料金体系
今すぐ無料で始めて、いつでもアップグレードまたはキャンセルできます。
Basic
2400 月 クレジット
1 ユーザーのみ
すべてのモデル
ワークフロー
Standard
3625 月 クレジット
1 ユーザーのみ
すべてのモデル
ワークフロー
Pro
6350 共有 月 クレジット
1 ユーザー
すべてのモデル
ワークフロー
Max
24650 共有 月 クレジット
1 ユーザー
すべてのモデル
ワークフロー
Enterprise
より高い制限のために
カスタム
料金と請求条件

Free
気軽に試したい方に
$0
ずっと無料
よくある質問
Berniniをもっと知る
Berniniのガイド、プロンプト、比較。
その他のモデル
Morphicのモデルカタログをさらに見る。
Seedream 5.5
ByteDance
2026年11月リリースのByteDance製Seedream画像モデル。 崩れないマルチラウンド編集、自然なリアリティ、より鮮明な文字。
Gemini Omni Flash 1.2
Google DeepMind
Googleの動画モデルが、15秒に伸びました。 テイク全体を直せて、1秒あたり約30%安くなっています。
ChatGPT Images 2.6
OpenAI
OpenAIの画像モデル、2026年11月公開。 GIF、SVG、速い下書きに対応。
SAM 3.1
Meta
MetaのSegment Anythingモデル。 どんな被写体も、追従するマスクにして追跡します。