Vidu Q4
Shengshu Technology 제공
Shengshu의 최신 영상 모델.
레퍼런스 이미지 12장과 음성 3개를 한 클립 안에서 일관되게 유지하고, 540p~4K 영상에 오디오까지 만듭니다.
주요 기능
기술 사양
Vidu Q
Shengshu의 Vidu 라인이며, Q4가 최신 세대입니다
2가지
이미지-영상과 레퍼런스-영상, 둘 다 사용 가능
3~16초
한 번에 초 단위로 지정 (기본 5초)
540p~4K
540p, 720p, 1080p, 2K, 4K (기본 720p)
최대 12장
캐릭터와 제품, 사물, 장소를 일관되게 유지
최대 3개
클립당 3~12초 길이의 MP3 음성
네이티브
대사와 효과음을 클립과 함께 싱크에 맞춰 생성
5가지
레퍼런스-영상에서 16:9, 9:16, 4:3, 3:4, 1:1
활용 사례
캐릭터 중심 스토리텔링
인물을 한 번 지정해 두면 얼굴과 의상, 목소리가 샷 내내 유지됩니다. 시리즈물에서 첫 프레임부터 마지막까지 같은 인물로 보입니다.
브랜드 콘텐츠와 광고
제품 컷과 모델 이미지를 넣으면 클립 내내 같은 모습으로 유지되고, 장면에 오디오까지 붙습니다. 숏폼 광고와 SNS 영상에 맞습니다.
스틸 한 장 움직이기
이미지 한 장을 첫 프레임으로 넣고 프롬프트로 움직임과 카메라 워크, 대사 한 줄을 지시합니다. 원본의 피사체와 구도는 유지됩니다.
여러 피사체가 나오는 장면
프롬프트에서 이미지를 순서로 가리키면 인물과 사물, 장소가 한 장면으로 합쳐집니다.
목소리가 있는 대사 장면
레퍼런스 음성을 최대 3개 넣고 대사마다 말할 목소리를 지정하면, 클립 내내 같은 목소리로 이어집니다.
멀티샷 시퀀스
한 번의 생성 안에서 카메라 컷을 짜면, 컷마다 레퍼런스한 피사체가 유지됩니다. 클립을 따로 이어 붙이지 않아도 됩니다.
프롬프트 예시
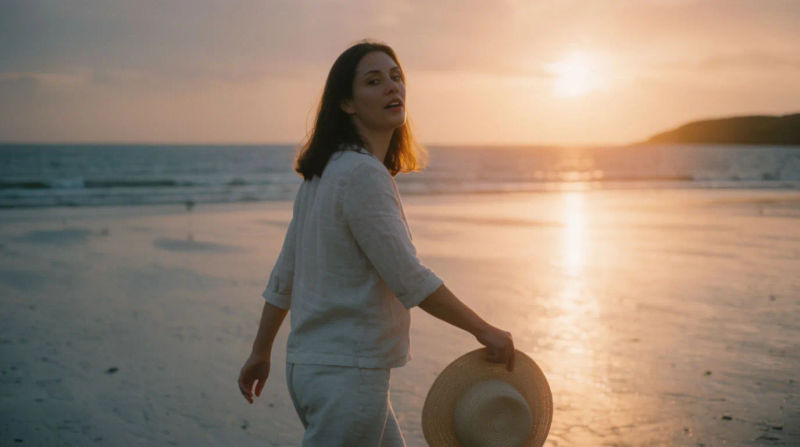
음성이 있는 레퍼런스 장면
해 질 무렵 해변을 걷는 인물([@reference_image_1]), 손에는 소품([@reference_image_2]). 카메라를 돌아보며 [reference_audio_1]의 목소리로 말한다
Edit prompt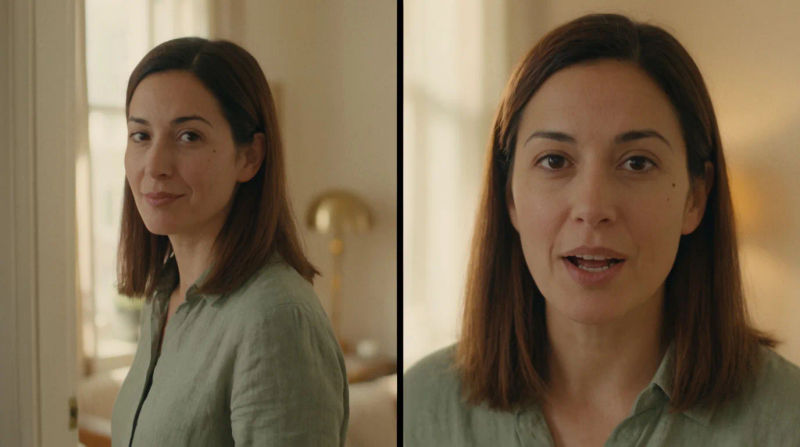
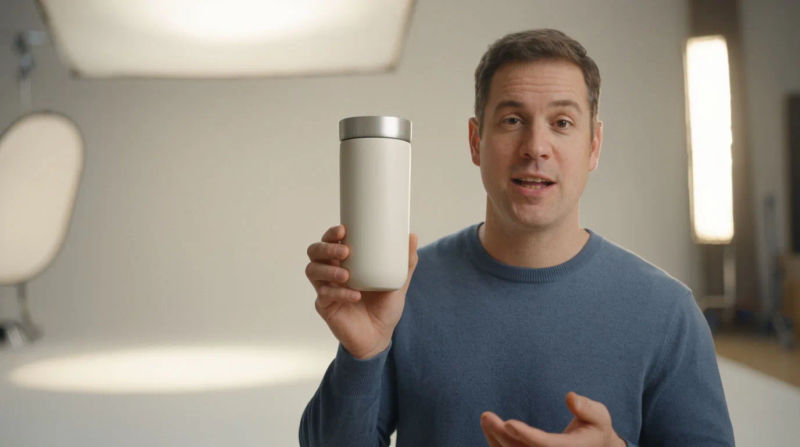
제품과 모델
밝은 스튜디오에서 모델([@reference_image_1])이 제품([@reference_image_2])을 들어 보이며 [reference_audio_1]의 목소리로 말한다: “Meet the new one”
Edit prompt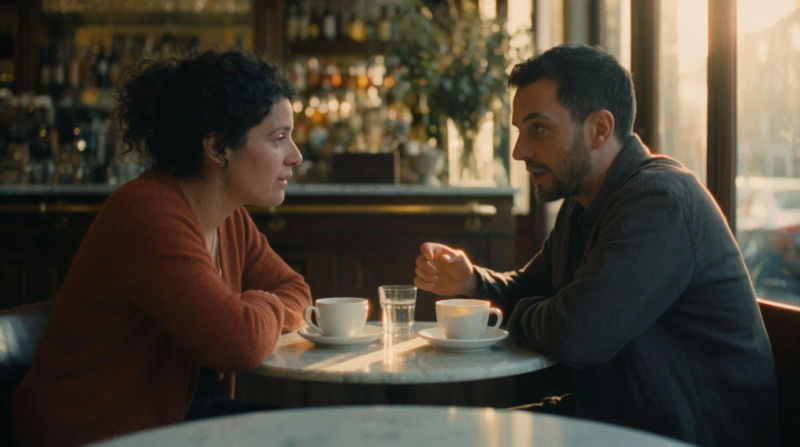
여러 피사체가 나오는 장면
작은 카페 테이블([@reference_image_3])을 사이에 두고 앉은 두 사람([@reference_image_1], [@reference_image_2])이 이야기를 나누고, 카메라가 천천히 밀고 들어간다
Edit prompt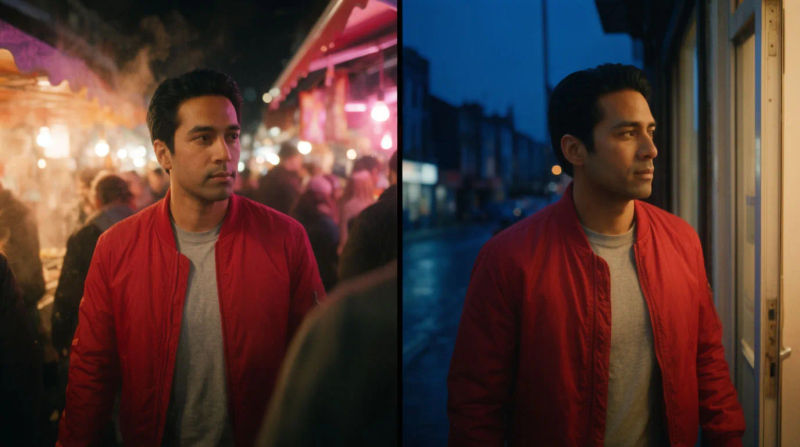
멀티샷 시퀀스
붉은 재킷의 인물([@reference_image_1]): 첫 샷은 야시장 골목을 누비고, 하드 컷으로 넘어가 해 질 녘 불 켜진 대문 앞에 도착한다
Edit prompt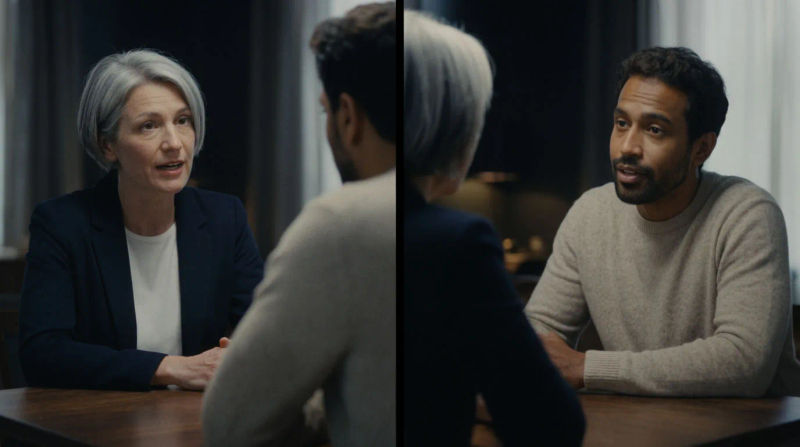
두 목소리의 대화
탁자를 사이에 두고 이야기하는 두 사람([@reference_image_1], [@reference_image_2]), 첫 번째는 [reference_audio_1]의 목소리로 말하고 두 번째는 [reference_audio_2]의 목소리로 답한다
Edit prompt개요
Vidu Q4는 Shengshu Technology의 최신 영상 생성 모델입니다. 직접 준비한 레퍼런스로 클립을 만들거나, 첫 프레임 한 장을 움직입니다. 레퍼런스는 이미지 최대 12장과 음성 클립 최대 3개입니다. 길이는 3~16초, 해상도는 최대 4K이고 네이티브 오디오를 켤 수 있습니다. Morphic에서 쓸 수 있는 가장 새로운 Vidu입니다.
Vidu Q4가 달라진 점
핵심은 레퍼런스 용량입니다. 많은 영상 모델은 이미지를 한 장만 받습니다. Vidu Q4는 한 프롬프트에 캐릭터와 제품, 사물, 장소 이미지를 최대 12장까지 받고, 음성 클립도 3개까지 받아 각각을 일관되게 유지합니다. 프롬프트에서 순서로 가리키기만 하면 되니, 한 번의 생성에서 출연진과 세트, 목소리가 함께 갖춰집니다.
이미지-영상과 레퍼런스-영상
Vidu Q4에는 두 가지 모드가 있습니다. 이미지-영상은 첫 프레임 한 장을 움직입니다. 피사체와 구도는 유지되고, 프롬프트가 움직임과 카메라 워크, 대사를 지시합니다. 레퍼런스-영상은 더 폭넓은 모드입니다. 이미지 최대 12장과 음성 클립 최대 3개를 프롬프트에서 지정하면, 모델이 이를 한 장면으로 엮고 인물과 제품, 목소리를 일관되게 유지합니다. 오디오는 두 모드 모두 영상과 같은 패스에서 만들어집니다. 레퍼런스-영상에서는 끄고 무음 클립으로 뽑을 수도 있습니다.
Morphic에서 쓰는 Vidu Q4
Vidu Q4는 Morphic에서 쓸 수 있습니다. Veo, Kling, Seedance, 이전 Vidu 릴리스 같은 영상 모델과 나란히 있습니다. 같은 Canvas에서 레퍼런스 한 세트를 두 모델에 보내 보세요. 출시 때 나온 비교 차트를 믿는 것보다, 내 캐릭터를 어느 쪽이 더 잘 유지하는지 직접 확인하는 편이 빠릅니다. 세로 9:16 숏폼 작업이라면 화면 비율을 먼저 정해 두고 시작하세요.
간단한 가격
오늘 무료로 시작하고 언제든지 업그레이드하거나 취소할 수 있습니다.
Basic
2400 월간 크레딧
1 명 전용
모든 모델
워크플로
Standard
3625 월간 크레딧
1 명 전용
모든 모델
워크플로
Pro
6350 공유 월간 크레딧
1 사용자
모든 모델
워크플로
Max
24650 공유 월간 크레딧
1 사용자
모든 모델
워크플로
Enterprise
더 높은 제한
사용자 정의
가격 및 청구 조건

Free
가볍게 사용해보기
$0
영구 무료
자주 묻는 질문
Gemini Omni Flash 1.2
Google DeepMind
Google의 영상 모델, 이제 15초까지. 테이크 전체를 수정하고 초당 비용은 30% 줄였습니다.
ChatGPT Images 2.6
OpenAI
OpenAI의 2026년 11월 이미지 모델. GIF와 SVG 출력, 더 빠른 초안.
SAM 3.1
Meta
Meta의 Segment Anything 모델. 피사체를 따라가는 마스크로 어떤 대상이든 추적합니다.
Seed Audio 1.5
ByteDance
ByteDance의 장면 단위 오디오 모델. 대사와 음악, 효과음이 트랙별로 따로 나옵니다.