Seed Audio 1.5
ByteDance 제공
ByteDance의 장면 단위 오디오 모델.
대사와 음악, 효과음이 트랙별로 따로 나옵니다.
주요 기능
사운드의 범위 듣기
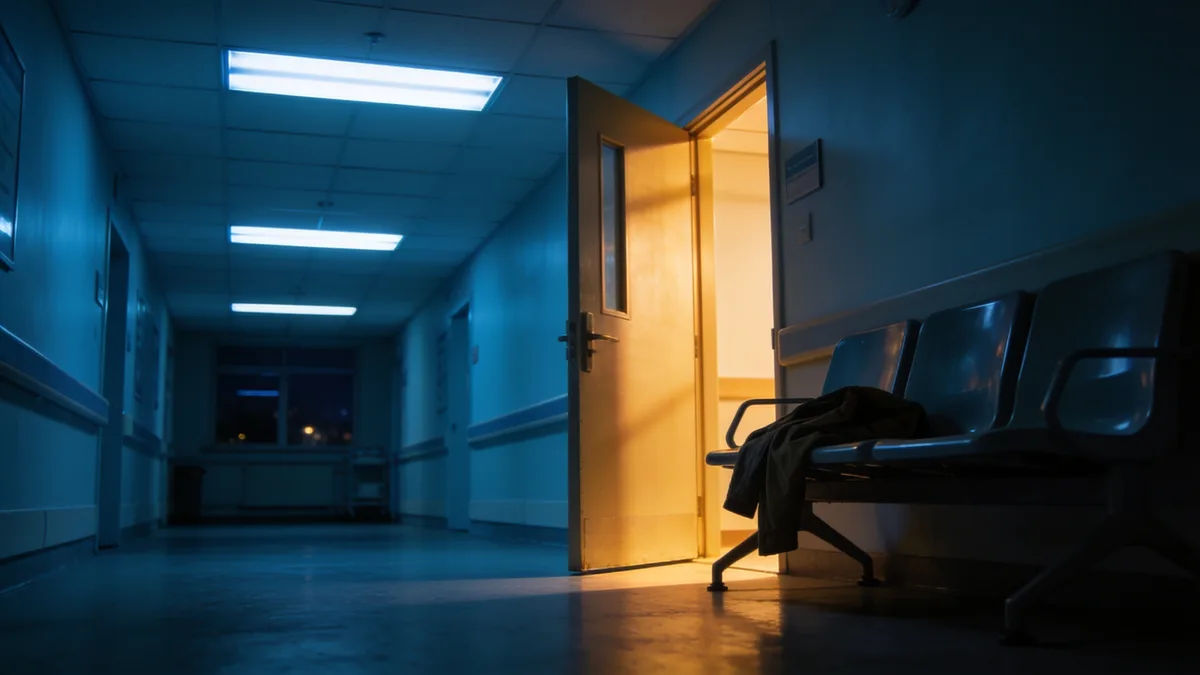
목소리 두 개와 복도의 웅웅거림, 긴장을 깔아 주는 패드 음.
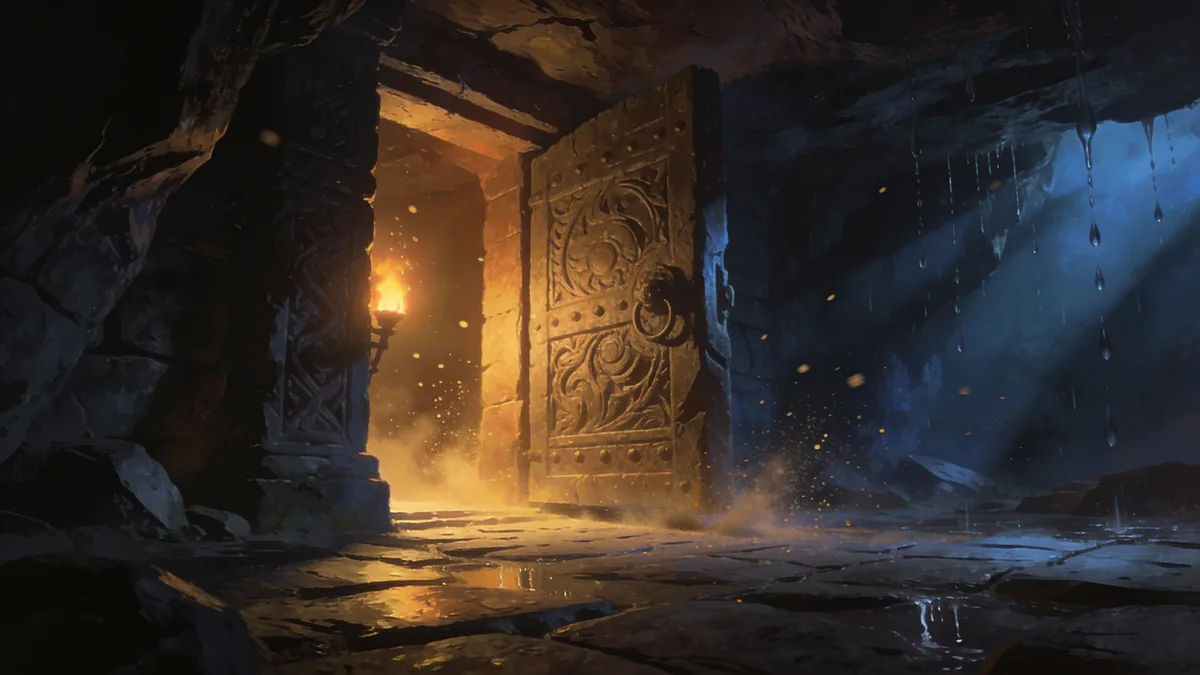
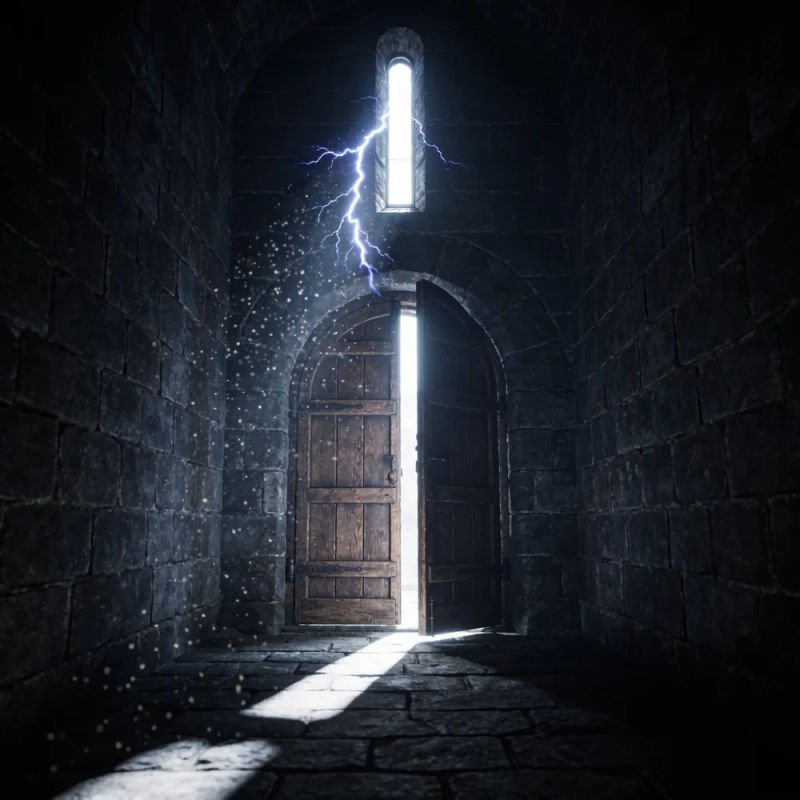
경고음, 물 떨어지는 소리, 이어서 열리는 문.
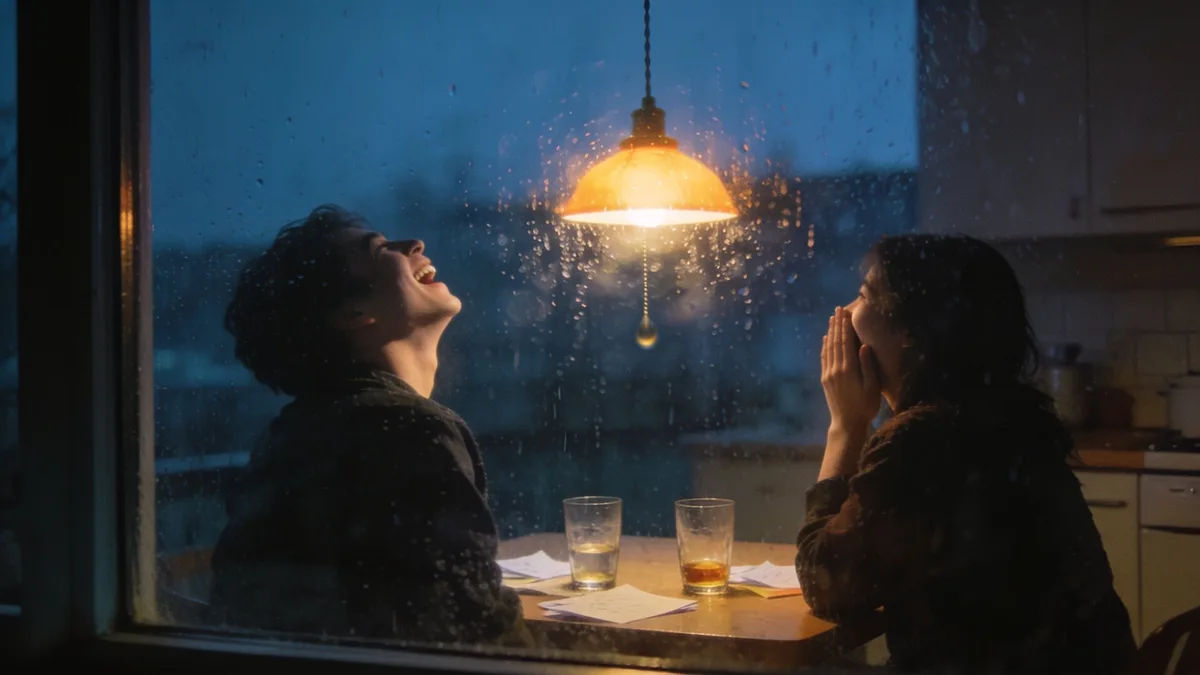
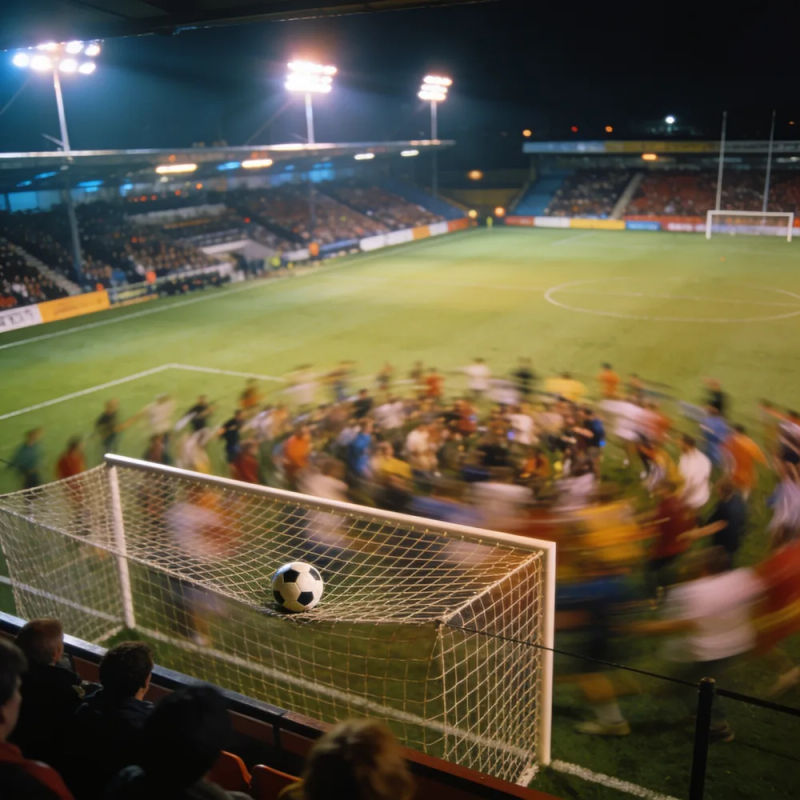
진행자 목소리 아래로 낮아지는 짧은 징글.
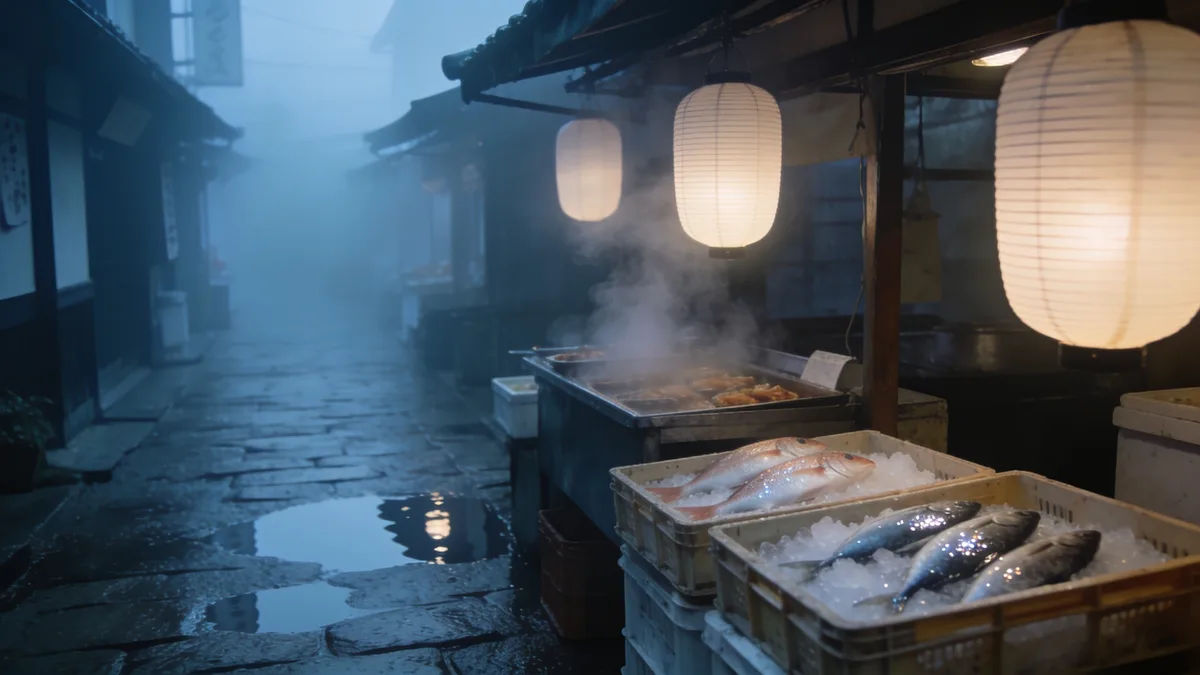
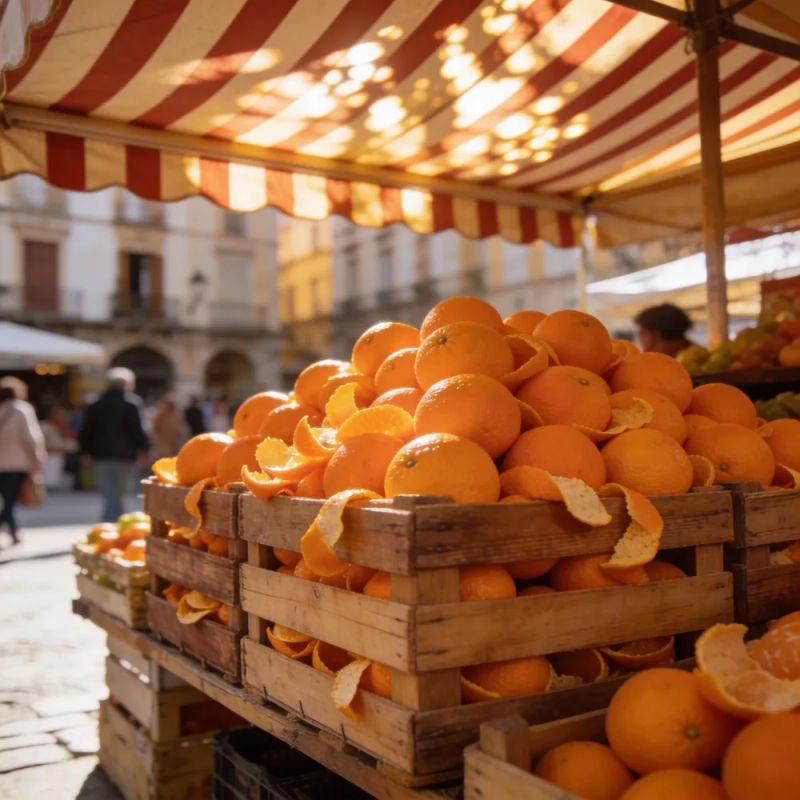
아침 시장 위로 흐르는 일본어 내레이션.
기술 사양
6분
한 번에 생성하는 길이이며, Seed Audio 1.0의 2분에서 늘었습니다
6개
한 번에 쓰는 레퍼런스 클립이며, 기존 3개에서 늘었습니다
30개
스페인어와 포르투갈어의 지역 변형 포함
5가지
텍스트에서 오디오, 음성 레퍼런스, 영상에서 오디오, 영상 더빙, 스템 분리
활용 사례
더빙과 현지화
완성된 영상을 넣으면 화면에 맞춘 더빙이 나옵니다. 원래의 효과음과 음악은 남아서, 국내 콘텐츠를 다른 언어로 내보낼 때 씁니다.
웹드라마와 숏드라마
6분이면 한 장면이 통째로 들어갑니다. 트랙이 나뉘어 있어 대사 한 줄을 고치려고 다시 만들 필요가 없습니다.
오디오북과 오디오 드라마
내레이션과 인물 목소리, 방 안의 소리를 함께 만듭니다. 긴 챕터에서도 같은 캐스트가 유지됩니다.
광고와 프로모션
보이스오버와 음악의 고조, 효과음을 한 번에 뽑습니다. 광고주가 수정을 요청하면 그 레이어만 다시 만듭니다.
게임 장면
컷신과 트레일러에 쓸 캐릭터 대사와 환경음, 타이밍 효과음을 초 단위로 맞춥니다.
팟캐스트
인트로 징글과 진행자 두 명, 실제처럼 들리는 공간감을 만듭니다. 편집용으로 목소리마다 트랙이 따로 있습니다.
프롬프트 예시
개요
Seed Audio 1.5는 ByteDance의 장면 단위 오디오 모델이며, Seed Audio 1.0의 후속입니다. ByteDance는 2026년 10월 28일에 이 모델을 공개했고, 공식 API는 BytePlus ModelArk를 통해 제공됩니다. 프롬프트 하나로 대사와 음악, 환경음, 효과음을 만들고, 한 번에 최대 6분까지 이어집니다. 영상과 음성 레퍼런스, 타임스탬프로도 방향을 줄 수 있습니다.
Seed Audio 1.5가 달라진 점
장면이 레이어로 나뉘어 돌아옵니다. 대사, 환경음, 효과음, 음악이 각자의 트랙이라서 틀린 대사나 너무 큰 효과음을 그것만 따로 고칠 수 있습니다. 영상을 넣으면 완성된 컷에 소리가 맞춰집니다. 더빙과 번역에 필요한 기능이고, 한국어도 지원 언어에 들어 있습니다.
Morphic에서 쓰는 Seed Audio 1.5
Seed Audio 1.5는 곧 Morphic에 들어옵니다. 지금은 Seed Audio 1.0으로 장면 전체를 만들 수 있습니다. ElevenLabs와 Lyria를 비롯한 오디오 모델도 함께 있어서, 오늘 Canvas에서 장면을 먼저 짜 볼 수 있습니다. 프롬프트 작성법은 Seed Audio 1.5 프롬프트 가이드에서 볼 수 있습니다. 샘플 장면에서 바로 시작하려면 Seed Audio 1.5 AI 오디오 생성기로 가세요.
간단한 가격
오늘 무료로 시작하고 언제든지 업그레이드하거나 취소할 수 있습니다.
Basic
2400 월간 크레딧
1 명 전용
모든 모델
워크플로
Standard
3625 월간 크레딧
1 명 전용
모든 모델
워크플로
Pro
6350 공유 월간 크레딧
1 사용자
모든 모델
워크플로
Max
24650 공유 월간 크레딧
1 사용자
모든 모델
워크플로
Enterprise
더 높은 제한
사용자 정의
가격 및 청구 조건
Free
가볍게 사용해보기
$0
영구 무료