FLUX 3 Max
fal.ai 제공
fal이 후처리 학습으로 다듬은 FLUX 3.
대본에 충실하고, 속도에 맞춰 설계했습니다.
주요 기능
렌더링 시간은 fal이 공개한 벤치마크이며, Morphic에서 직접 잰 두 번의 결과를 더했습니다. 이 페이지의 모든 클립은 Morphic에서 FLUX 3 Max로 만들었습니다.
기술 사양
~12초
fal이 측정한 10초 720p 클립 평균
5~20초
클립마다 1초 단위로 설정
720p / 1080p
기본은 720p, 필요하면 1080p
2~10개
첫·마지막 프레임 또는 시점을 지정한 정지 이미지
활용 사례
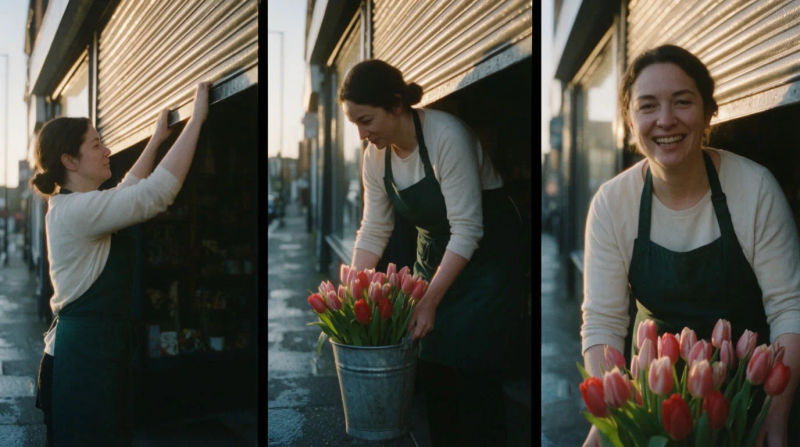
대본으로 만드는 광고 장면
배달 기사가 미끄러지듯 멈춰 서서 가방을 건네고, 둘이 함께 웃습니다. 비트를 한 번만 적으면 클립이 그 순서대로 끝까지 재생됩니다.
가까이서 보는 물리적 디테일
얼음이 가라앉으며 갈라지고 차가 잔 밖으로 튑니다. 소리는 눈에 보이는 순간에 정확히 맞춰 들립니다.
카메라 앞에서 말하는 대사
대사를 따옴표 안에 적으면 글자 그대로 발화되고 입 모양도 맞습니다. 주변에는 부두의 바람 소리와 갈매기 소리가 깔립니다.
끊기지 않는 롱테이크
15초짜리 드론 추적 샷이 자동차와 도로, 등대가 드러나는 순간까지 컷이나 이음새 없이 한 동선으로 이어집니다.
키프레임으로 만드는 변형
흙덩이와 원통, 그릇을 담은 정지 이미지 세 장이 물레 위에서 하나의 연속된 작업으로 이어집니다. 각 단계는 고정한 위치에 정확히 도착합니다.
사진 한 장을 움직이는 영상으로
사진을 넣으면 그 프레임 안에서 움직입니다. 회전목마가 돌고 전구가 켜지며, 바다와 갈매기 소리가 빈 곳을 채웁니다.
프롬프트 예시
개요
FLUX 3 Max는 fal Research의 영상 모델입니다. Black Forest Labs의 FLUX 3를 바탕으로, fal이 Black Forest Labs와 협력해 후처리 학습을 거쳤습니다. 목표는 프롬프트를 더 충실히 따르고, 화질을 높이고, 속도를 끌어올리는 것이었습니다. 2026년 10월 19일에 출시되었습니다. 클립 길이는 5초에서 20초, 해상도는 720p 또는 1080p이며, 소리는 화면과 함께 생성됩니다.
FLUX 3 Max가 달라진 점
핵심은 시간입니다. fal의 모델 페이지는 10초 클립의 렌더링을 약 12초로 소개합니다. 이 정도 화질의 영상은 보통 몇 분이 걸립니다. 그래서 초안을 보고, 고치고, 다시 돌리는 일이 한자리에서 끝납니다. 후처리 학습의 효과도 보입니다. 이어서 적은 동작이 순서대로 재생되고, Artificial Analysis의 이미지 투 비디오 순위에서는 상위 모델과 비슷한 자리에 있습니다. Max는 Black Forest Labs가 내놓은 더 큰 등급이 아니라 fal이 다듬은 FLUX 3입니다.
Morphic에서 쓰는 FLUX 3 Max
영상 모델 선택기에서 Seedance, Kling, Veo, MiniMax H3와 나란히 FLUX 3 Max를 고를 수 있습니다. 텍스트 투 비디오와 이미지 투 비디오, 그리고 키프레임을 최대 10장까지 쓰는 Frames to Video를 지원합니다. Morphic은 후처리 학습을 맡은 fal을 통해 모델을 실행하며, 프롬프트를 가장 충실히 따르는 high reasoning 설정을 씁니다. 결과는 Canvas에 쌓이므로 같은 프롬프트를 다른 모델에도 돌려 나란히 비교할 수 있습니다. 쓰는 방법은 FLUX 3 Max 가이드에서, 바로 쓸 프롬프트는 FLUX 3 Max 프롬프트 모음에서 확인하세요.
간단한 가격
오늘 무료로 시작하고 언제든지 업그레이드하거나 취소할 수 있습니다.
Basic
2400 월간 크레딧
1 명 전용
모든 모델
워크플로
Standard
3625 월간 크레딧
1 명 전용
모든 모델
워크플로
Pro
6350 공유 월간 크레딧
1 사용자
모든 모델
워크플로
Max
24650 공유 월간 크레딧
1 사용자
모든 모델
워크플로
Enterprise
더 높은 제한
사용자 정의
가격 및 청구 조건

Free
가볍게 사용해보기
$0
영구 무료
자주 묻는 질문
Gemini Omni Flash 1.2
Google DeepMind
Google의 영상 모델, 이제 15초까지. 테이크 전체를 수정하고 초당 비용은 30% 줄였습니다.
ChatGPT Images 2.6
OpenAI
OpenAI의 2026년 11월 이미지 모델. GIF와 SVG 출력, 더 빠른 초안.
SAM 3.1
Meta
Meta의 Segment Anything 모델. 피사체를 따라가는 마스크로 어떤 대상이든 추적합니다.
Seed Audio 1.5
ByteDance
ByteDance의 장면 단위 오디오 모델. 대사와 음악, 효과음이 트랙별로 따로 나옵니다.