Seedance 2.5 AI 영상 모델
ByteDance 제공
ByteDance의 차세대 영상 모델.
네이티브 1080p로 최대 30초, 클립 편집과 연장까지.
주요 기능
위 내용은 ByteDance가 밝힌 Seedance 2.5의 출시 사양이며, 독립 벤치마크는 아직 나오지 않았습니다.
기술 사양
이용 가능
지금 Morphic에서 사용할 수 있습니다.
네이티브 1080p
출시 당시 720p에서 향상된 네이티브 1080p 생성
최대 30초
한 번의 생성으로 만드는 싱글샷 네이티브 길이
최대 50개
생성당 이미지 30장, 영상 10개, 오디오 10개
4가지
자동, 참조, 편집, 연장
4~30초
편집에 쓸 수 있는 클립 길이이며 결과물도 같은 길이입니다.
활용 사례
긴 호흡의 광고 영상
30초 네이티브 클립이면 방송 광고 한 편 분량이 한 번에 나옵니다. 짧은 샷 여러 개를 이어 붙일 필요가 없습니다.
숏폼 드라마와 스킷
긴 싱글 테이크는 숏폼 드라마나 연재 스킷에 잘 맞습니다. 4초짜리 컷으로는 담기 어려운 장면에 여유가 생깁니다.
영화·드라마 프리비즈
본 촬영 전에 시퀀스가 어떻게 흘러가는지 더 길게 미리 볼 수 있습니다. 감독이 장면의 호흡을 확인하는 단계에 쓰기 좋습니다.
참조로 잡는 연속성
참조를 최대 50개까지 넣어 캐릭터, 세트, 색감을 시퀀스 내내 고정할 수 있습니다. 컷이 바뀌어도 일관성이 유지됩니다.
마음에 드는 테이크 살리기
영역 단위 편집은 잘 나온 클립에서 어긋난 요소 하나만 고칩니다. 샷 전체를 다시 뽑을 필요가 없습니다.
짧게 나온 클립 늘리기
연장은 마지막 프레임 뒤를 이어 가거나 첫 프레임 앞 장면을 채웁니다. 짧게 나온 장면에 길이를 더할 수 있습니다.
오디오로 이끄는 장면
오디오 전용 참조를 쓰면 음성, 음악, 효과음 트랙이 속도감과 비트 맞춤, 립싱크를 이끌어 줍니다.
프롬프트 예시
개요
Seedance 2.5는 ByteDance의 차세대 영상 모델입니다. 최대 30초의 네이티브 싱글샷 영상을 만들고, 멀티모달 참조를 최대 50개까지 받습니다. 이미 가진 클립을 편집하거나 연장할 수 있고, 10개 이상 언어의 네이티브 오디오도 갖췄습니다. Seedance 2.0 라인을 대체하는 모델이 아니라 그 위에 쌓은 모델입니다. 지금 Morphic에서 바로 쓸 수 있습니다.
Seedance 2.5가 달라진 점
가장 큰 변화는 길이입니다. 최대 30초 싱글샷을 한 번에 만듭니다. 지금 대부분의 모델이 내놓는 몇 초짜리 클립과는 차원이 다릅니다. 광고 한 편, 숏폼 드라마의 한 장면, 긴 프리비즈를 한 번에 뽑을 수 있습니다.
참조도 크게 늘었습니다. 생성 한 번에 멀티모달 참조를 최대 50개까지 받습니다. 이미지 30장, 영상 10개, 오디오 10개입니다. Seedance 2.0은 이미지 9장, 오디오와 영상 클립 3개였습니다.
새로 생긴 오디오 전용 참조는 속도감과 립싱크를 이끌어 줍니다. 10개 이상 언어를 네이티브로 지원합니다.
클립 안 편집에는 제어가 두 가지 더해졌습니다. 화이트 모델 제어는 질감 없는 3D 지오메트리로 샷의 구도를 먼저 잡고, 그 위에 조명을 입힙니다. 그린스크린 편집은 피사체를 그대로 두고 배경만 바꿉니다.
클립 편집과 연장
Seedance 2.5는 빈 프롬프트에서 시작할 때만 쓰는 모델이 아닙니다. 이미 가진 영상도 다룹니다. 두 방식 모두 같은 참조 기반 생성에서 실행되며, 각각 작업 유형으로 지정해 둘 수 있습니다. 지정하면 모델이 요청을 새 렌더로 오해하지 않습니다.
편집은 영역 단위로 이뤄집니다. 클립을 첨부하고 바꿀 내용을 말하면 나머지 화면은 그대로 유지됩니다. 피사체 교체, 오브젝트 추가와 제거, 화면 일부 다시 그리기, 음악이나 음성 교체가 여기에 해당합니다. 결과물은 원본에 맞춰지므로 화면 비율과 길이를 따로 정할 수 없습니다. 첨부하는 클립은 4~30초여야 합니다.
연장은 내용을 바꾸지 않고 분량을 더합니다. 마지막 프레임 뒤를 이어 가거나, 첫 프레임 앞 장면을 만들거나, 두 클립을 잇는 전환을 만들 수 있습니다. 이어 붙이는 지점에서도 캐릭터, 리듬, 스타일이 유지됩니다. 화면 비율은 원본을 따르지만, 편집과 달리 새로 붙일 분량은 초 단위로 정할 수 있습니다. 기준은 간단합니다. 샷은 좋은데 요소 하나가 어긋났다면 편집을, 샷은 좋은데 짧다면 연장을 고르세요.
네이티브 1080p 출력
Seedance 2.5는 네이티브 1080p로 렌더링합니다. 작은 렌더를 늘린 것이 아니라 1920x1080 프레임을 바로 생성하며, 출시 당시의 720p에서 올라왔습니다. 풀HD로 바로 납품할 수 있으므로 소셜, 웹, 광고 파이프라인에 올리기 전에 업스케일 단계를 거치지 않아도 됩니다. 720p를 억지로 늘린 영상보다 가장자리와 질감도 깨끗합니다. 30초 싱글 테이크, 네이티브 오디오, 최대 50개 참조도 모두 한 번의 패스로 1080p에서 나옵니다.
품질과 사실감
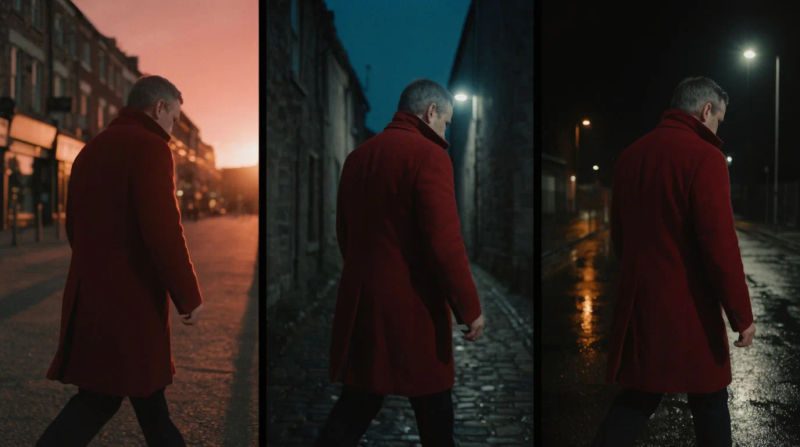
Seedance 2.5는 실제 촬영 영상에 한층 가까워졌습니다. 조명은 물리 법칙을 따릅니다. 눈동자의 캐치라이트가 더 자연스럽고, 빛의 방향과 감쇠도 일관됩니다. 푸시, 풀, 팬, 틸트 같은 카메라 움직임은 30초 롱테이크 내내 흔들림이나 프레임 끊김 없이 안정적입니다. 연기는 키프레임으로 끊어 놓은 느낌이 아니라 하나로 이어져 보이고, 미세한 표정도 설득력 있습니다. 피부 질감과 머리카락에서 느껴지던 언캐니 밸리도 줄어 실사 느낌이 더 강해졌습니다.
Seedance 라인에서의 위치
Seedance 2.5는 Seedance 라인의 최상위 모델입니다. Seedance 2.0과 Seedance 2.0 4K보다 위에 있고, 더 가벼운 Seedance 2.0 Mini와 Fast 등급보다도 위에 놓입니다. 멀티모달 입력, 네이티브 오디오, AI 카메라 제어 같은 Seedance 2.0의 기능은 그대로 가져오고, 더 긴 클립과 더 많은 참조를 얹었습니다. ByteDance가 이전 출시처럼 Pro나 Turbo 계열 변형을 뒤이어 내놓을 수도 있습니다.
숏폼 드라마에 활용하기
세로형 숏폼 드라마에서 Seedance 2.5의 가장 큰 강점은 이름값 그대로 길이입니다. 최대 30초 싱글샷이라서 대립 장면의 투 샷이나 천천히 드러나는 푸시인을 여러 짧은 클립으로 자르지 않고 하나의 테이크로 담을 수 있습니다. 한 장면 내내 캐릭터가 흔들리지 않는 것이 장점입니다. 오디오 전용 참조로 대사의 속도감과 립싱크를 잡을 수 있고, 최대 50개 참조로 저장해 둔 출연진을 에피소드 전체에서 컷마다 이어 갈 수 있습니다.
호흡이 필요한 장면에 쓰세요. 감정을 오래 붙잡는 클로즈업, 대사가 오가는 장면, 분위기를 까는 도입부가 그런 예입니다. 몇 초면 충분한 빠른 컷이나 액션 위주 샷은 다른 모델로 돌리는 편이 낫습니다. 대사와 일관성 면에서 다른 엔진과 어떻게 다른지는 숏폼 드라마에 맞는 AI 모델 비교에서 볼 수 있습니다.
Seedance 2.5와 Morphic
Seedance 2.5는 지금 Morphic에서 바로 쓸 수 있습니다. 나머지 Seedance 라인은 물론 Kling, Veo 같은 다른 영상 모델과 나란히 고를 수 있습니다. 프롬프트 바에서 모델을 선택하고, 샷을 브리프로 적고, 참조를 붙여 생성하세요. 결과물은 모두 Canvas에 모입니다. 같은 브리프를 Seedance 2.5와 다른 모델에 각각 돌려 보고, 확정하기 전에 나란히 비교할 수 있습니다.
간단한 가격
오늘 무료로 시작하고 언제든지 업그레이드하거나 취소할 수 있습니다.
Basic
2400 월간 크레딧
1 명 전용
모든 모델
워크플로
Standard
3625 월간 크레딧
1 명 전용
모든 모델
워크플로
Pro
6350 공유 월간 크레딧
1 사용자
모든 모델
워크플로
Max
24650 공유 월간 크레딧
1 사용자
모든 모델
워크플로
Enterprise
더 높은 제한
사용자 정의
가격 및 청구 조건

Free
가볍게 사용해보기
$0
영구 무료
자주 묻는 질문
Gemini Omni Flash 1.2
Google DeepMind
Google의 영상 모델, 이제 15초까지. 테이크 전체를 수정하고 초당 비용은 30% 줄였습니다.
ChatGPT Images 2.6
OpenAI
OpenAI의 2026년 11월 이미지 모델. GIF와 SVG 출력, 더 빠른 초안.
SAM 3.1
Meta
Meta의 Segment Anything 모델. 피사체를 따라가는 마스크로 어떤 대상이든 추적합니다.
Seed Audio 1.5
ByteDance
ByteDance의 장면 단위 오디오 모델. 대사와 음악, 효과음이 트랙별로 따로 나옵니다.