Gemini Omni
von Google DeepMind
Googles erstes Any‑to‑any‑KI‑Modell.
Text, Bild, Audio und Video rein, ein fertiges Video raus.
Hauptfunktionen
Technische Spezifikationen
Omni Flash
Erstes Modell in Googles Gemini-Omni-Reihe
Video
Bild- und Audioausgabe sind für die Gemini-Omni-Roadmap geplant
Bis zu 10s
Flash-Clips sind zum Start auf 10 Sekunden begrenzt, um den Zugang zu erweitern
720p
Gemini Omni Flash gibt Video in 720p aus
Beliebige Mischung
Text, Bild, Audio und Video in einem Prompt
Nativ
Synchronisiertes Audio wird mit jedem Clip erzeugt; Stimme über Avatare
SynthID
Unmerkliches KI-Herkunftswasserzeichen auf jedem Clip
Google DeepMind
Positioniert als Nachfolger von Veo für Any-to-any-Videoerstellung
Anwendungsfälle
Multimodales Storyboarding
Ein Charakterbild, ein Ortsfoto, ein Musik-Cue und ein Stichwort gehen ein, das Modell baut die Einstellung und arbeitet iterativ weiter.
Konversationelle Videobearbeitung
Bearbeiten Sie jeden Clip in normaler Sprache: Garderobe tauschen, Hintergrund ändern oder einen Moment neu timen. Der Rest bleibt stabil.
Marketingvideo
Werbeschnitte, die Markenfarben, Produktform und Bildschirmtext respektieren. Ein Foto, ein Briefing, ein fertiger Spot.
Lehrvideos und Erklärvideos
Visualisieren Sie Naturwissenschaft, Geschichte und Technik mit eingebauter Physik. Die Fakten bleiben korrekt, das Material sauber.
Sprecher-Video
Ein Porträt plus eine Stimmreferenz ergibt denselben Präsentator vor der Kamera über Shorts, Kurse und Anleitungen hinweg.
Social Shorts
10-Sekunden-Clips passen zu YouTube Shorts, Reels und TikTok. Erzeugen Sie Varianten und veröffentlichen Sie die beste.
Prompt-Beispiele
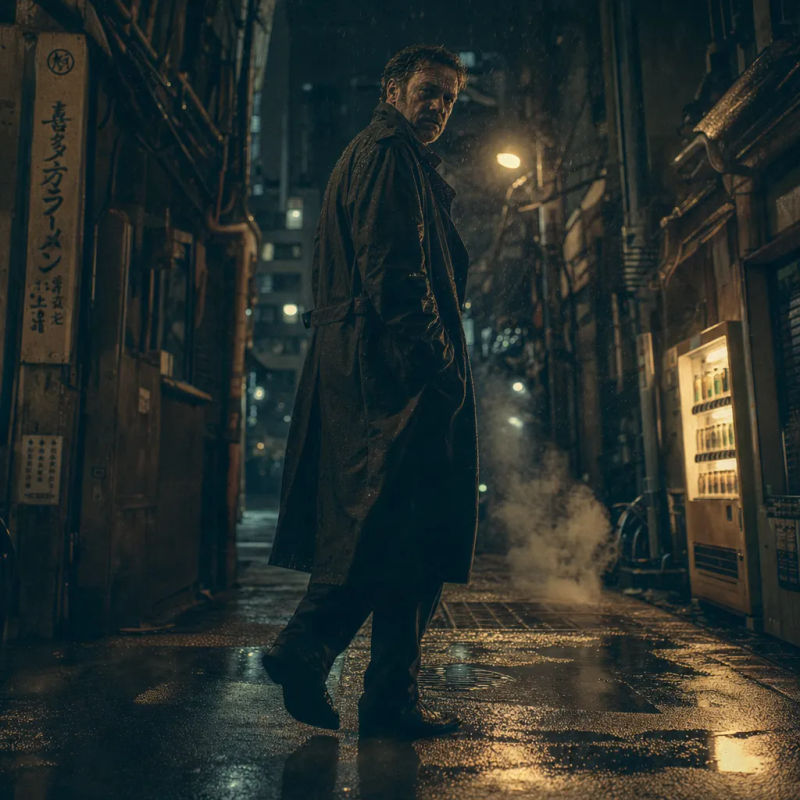
Cinematic Noir
Detektiv in einer regennassen Tokioter Gasse, Natriumlampen-Glühen, Teal-Amber-Noir
Edit prompt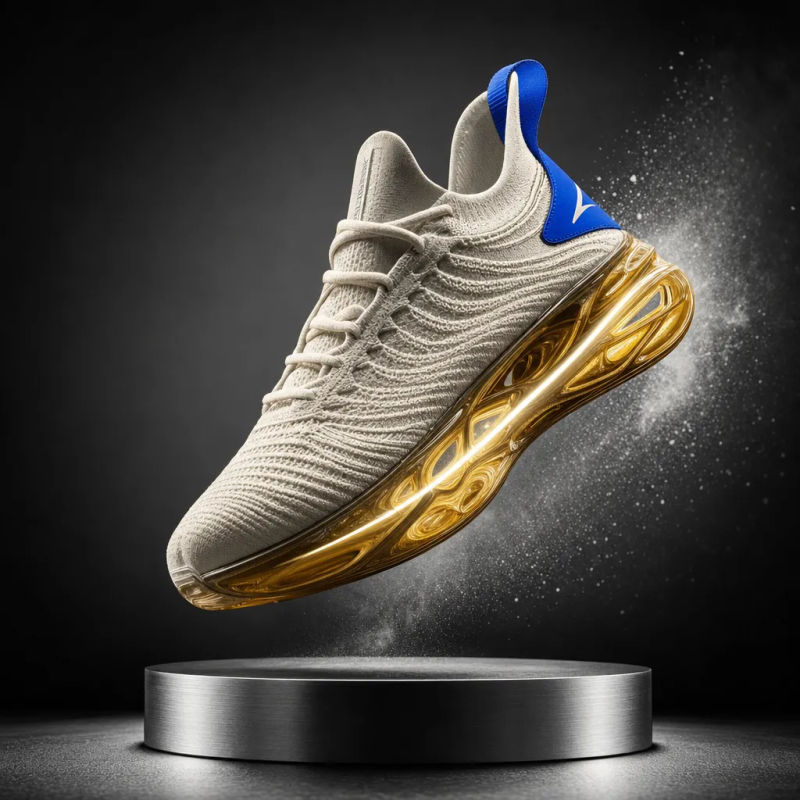
Produktlaunch
Avantgardistischer Sneaker schwebt über einem Titan-Sockel, hartes Streiflicht, Launch-Stimmung
Edit prompt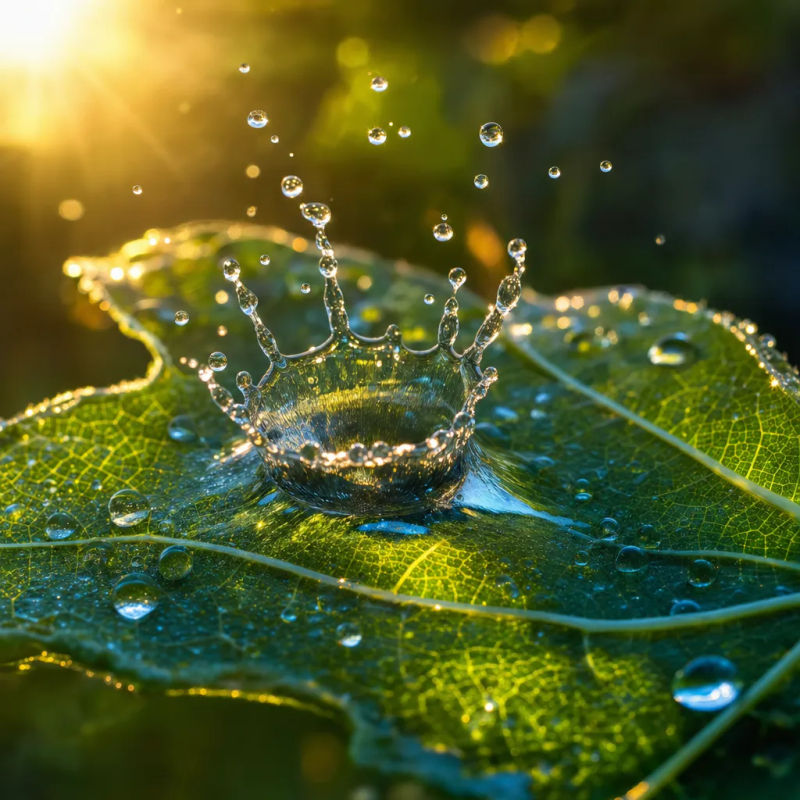
Naturerklärung
Wassertropfen erstarrt zur kristallinen Krone auf einem taufeuchten Blatt, Gegenlicht bei Sonnenaufgang, Makro
Edit prompt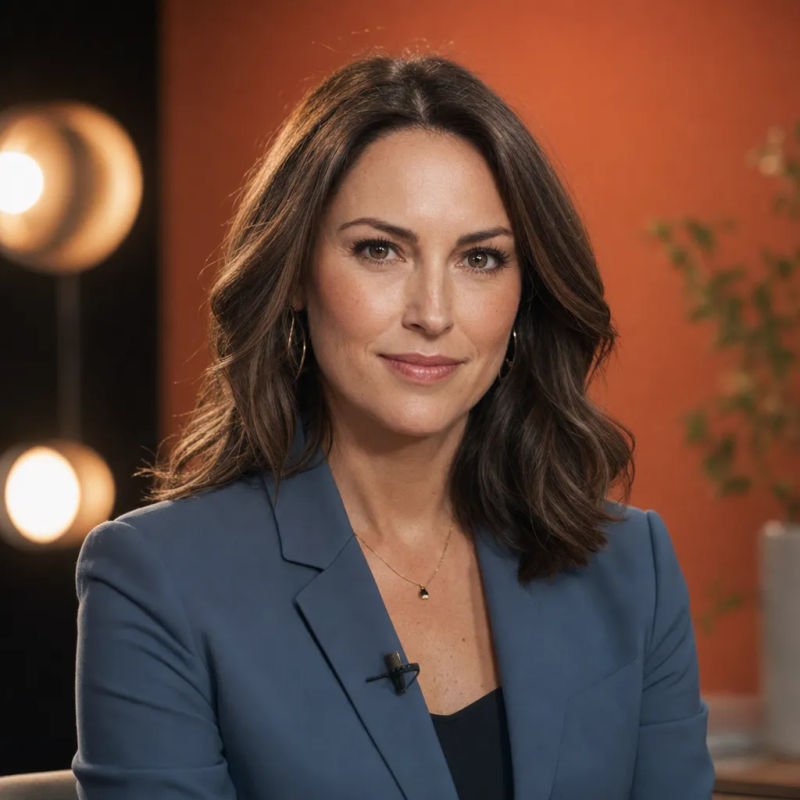
Avatar-Sprecher
Souveräner Studio-Moderator blickt in die Kamera, warmes Dreipunktlicht, 85mm-Bokeh
Edit prompt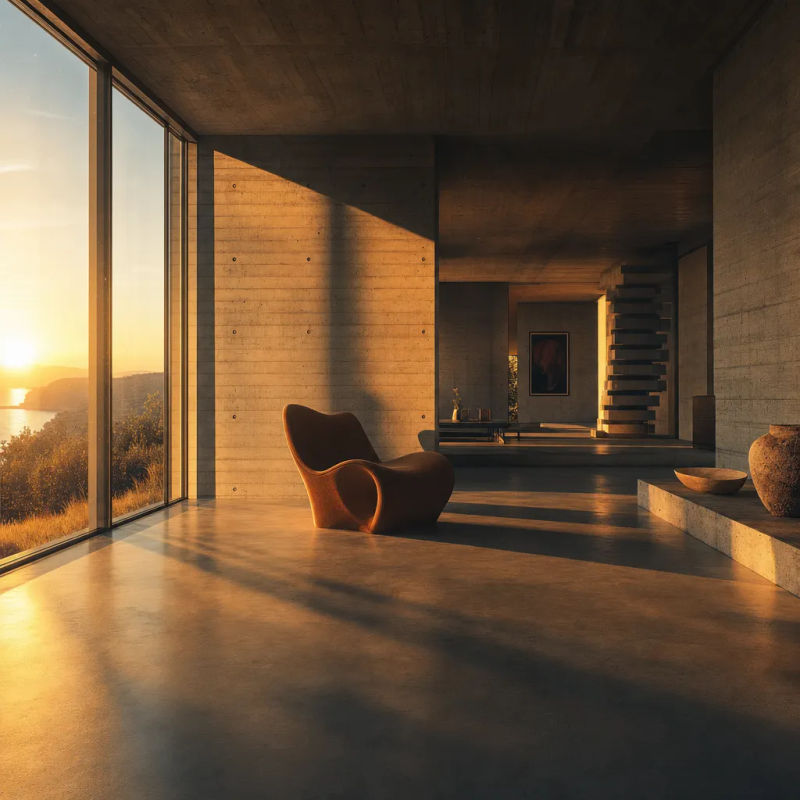
Architektur-Rundgang
Goldenes Licht durch eine brutalistische Betonvilla, lange Schatten, treibender Staub
Edit prompt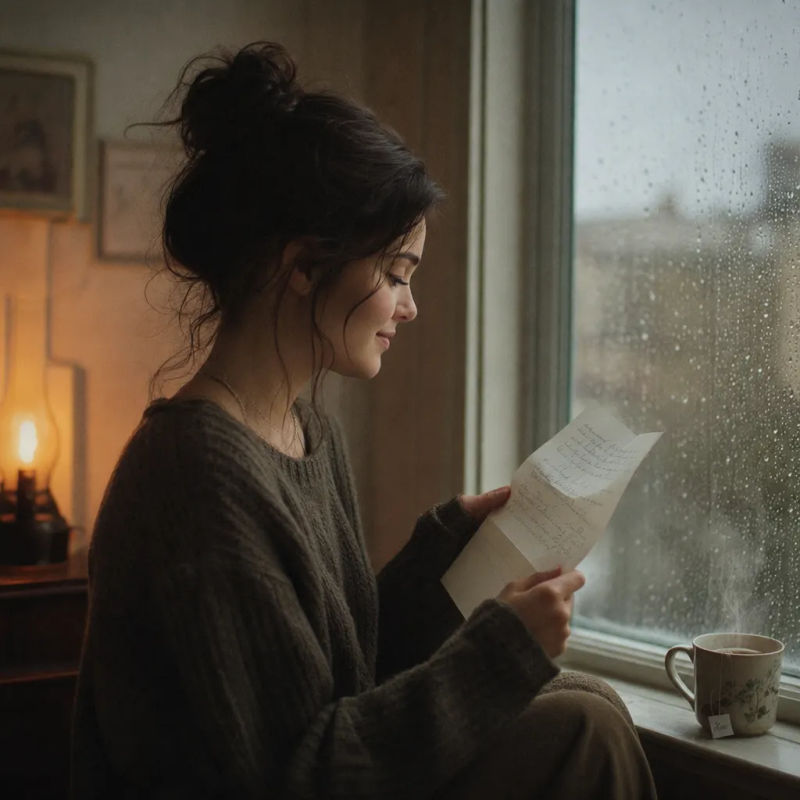
Überblick
Gemini Omni ist Googles erstes Any-to-any-Multimodalmodell, vorgestellt auf der Google I/O 2026 am 19. Mai 2026. Die erste Version, Gemini Omni Flash, nimmt Text, Bilder, Audio und Video in einem einzigen Prompt entgegen und erzeugt daraus ein einziges Video, mit konversationeller Bearbeitung, Charakterkonsistenz, präziser Physik und SynthID-Wasserzeichen auf jedem Clip.
Was Gemini Omni anders macht
Statt Modalitäten aneinanderzureihen, verknüpft Gemini Omni sie inhaltlich. Ein Prompt mit Porträtreferenz, Ortsfoto, Stimmprobe und einer Kurzbeschreibung ergibt eine einzige Einstellung, die jede Eingabe gleichzeitig berücksichtigt. Folgeprompts bearbeiten dieselbe Szene weiter, nicht eine neue – Charaktere, Licht und Kontinuität bleiben über mehrere Züge hinweg erhalten.
Gemini Omni auf Morphic
Auf Morphic steht Gemini Omni in der Videomodellauswahl neben Veo 3.1, Seedance 2.0, Kling und dem übrigen Videokatalog. Wechseln Sie die Prompt-Leiste in den Video-Modus, wählen Sie Gemini Omni, fügen Sie Referenzen in beliebiger Kombination hinzu und bearbeiten Sie dieselbe Szene mit Folgeprompts weiter.
Einfache Preise
Starten Sie noch heute kostenlos, mit der Option, jederzeit zu upgraden oder zu kündigen.
Basic
2400 monatliche Credits
1 Nutzer
Alle Modelle
Workflows
Standard
3625 monatliche Credits
1 Nutzer
Alle Modelle
Workflows
Pro
6350 gemeinsame monatliche Credits
1 Nutzer
Alle Modelle
Workflows
Max
24650 gemeinsame monatliche Credits
1 Nutzer
Alle Modelle
Workflows
Enterprise
Für höhere Limits
Individuell
Preis- und Abrechnungsbedingungen
Free
Zum Ausprobieren
$0
dauerhaft kostenlos
Häufig gestellte Fragen
ChatGPT Images 2.5
OpenAI
OpenAIs Bildmodell, erschienen im September 2026. Schärfere Details, präzise Edits, kürzere Wartezeit.
Lyria 3.5
Google DeepMind
Googles bestklingendes Musikmodell. Ganze Songs mit Aufbau und Gesang.
MiniMax H3 Max Turbo
fal.ai
Das Tempo-Modell von fal, aus H3 Max. Doppelt so schnell, fast gleiche Optik.
Inworld TTS 2
Inworld
Eine Stimme, über 100 Sprachen. 95 Stimmen, erster Ton in Echtzeit.