Audio-Generierung
Demnächst verfügbar

Seed Audio 1.5

von ByteDance

ByteDances Szenen‑Audiomodell.
Dialog, Musik und Effekte als getrennte Spuren.
Seed Audio 1.5

Hauptfunktionen

Hören Sie die Bandbreite
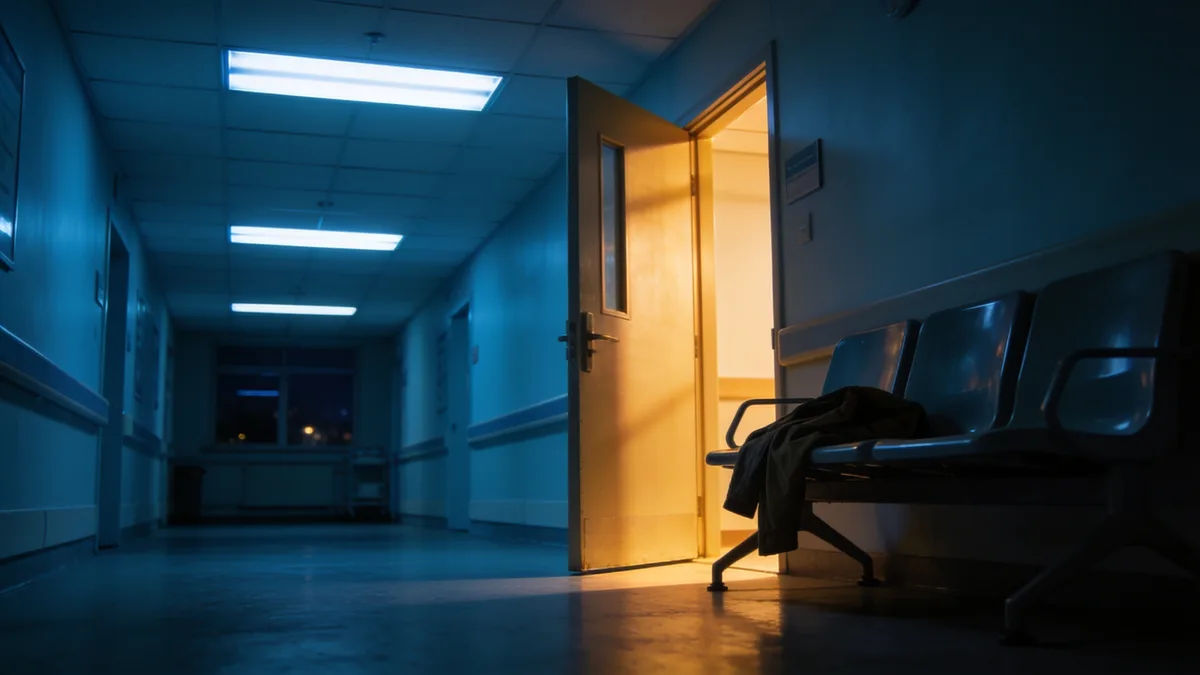
Ein leerer Krankenhausflur bei Nacht, auf einer Bank liegt ein zurückgelassener Mantel
Kurzdrama-SzeneDialog

Zwei Stimmen, das Brummen eines Flurs und ein angespannter Pad-Klang.
0:00
0:12
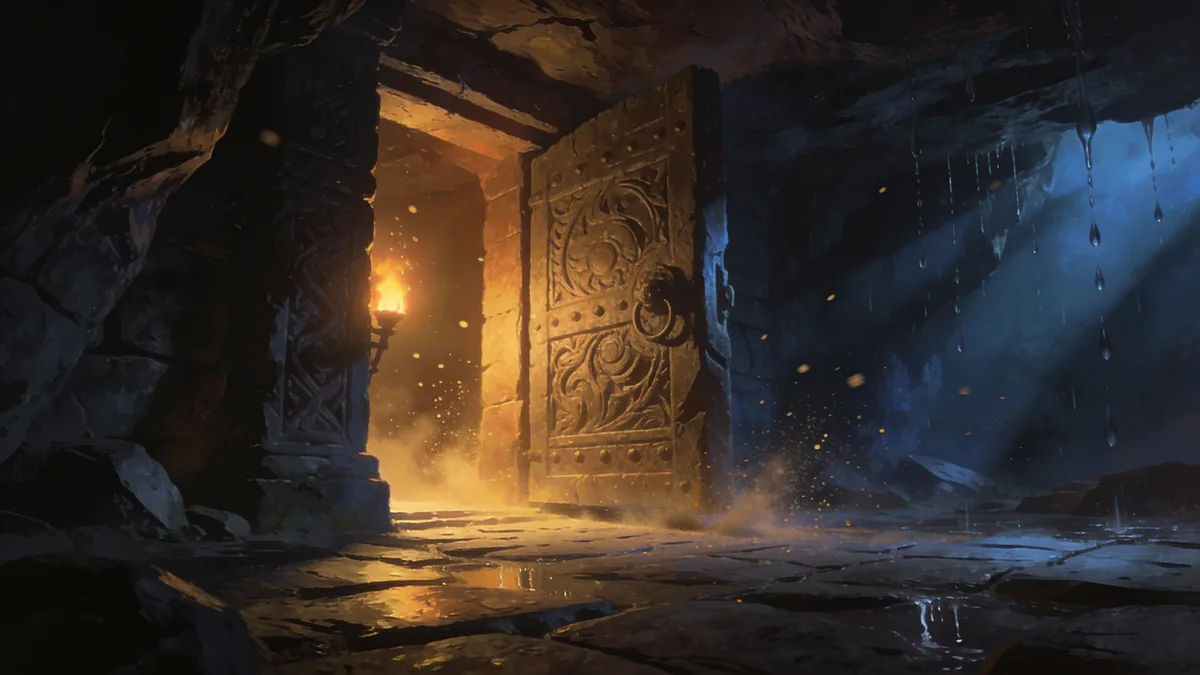
Ein behauenes Steintor öffnet sich in einer fackelbeleuchteten Höhle
SpielszeneSounddesign

Eine Warnung, tropfendes Wasser, dann öffnet sich das Tor.
0:00
0:12
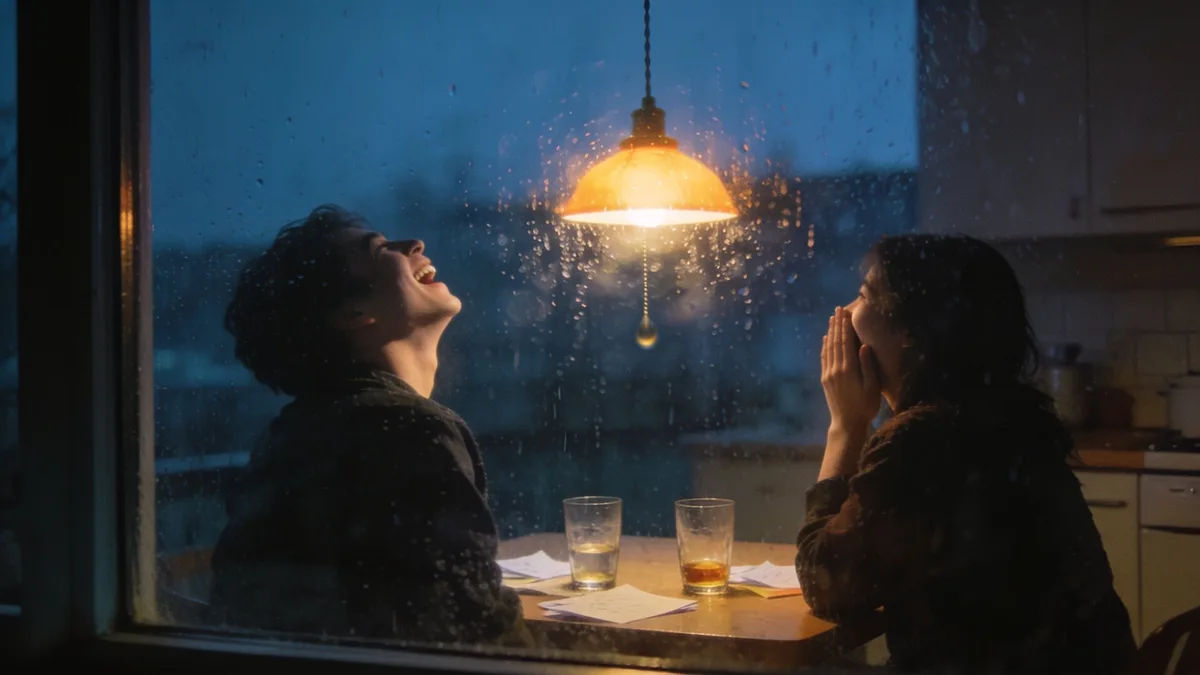
Zwei Freunde lachen nachts an einem Küchentisch, gesehen durch ein regennasses Fenster
Podcast-AuftaktMusik und Stimme

Ein kurzer Jingle, der unter der Moderation zurücktritt.
0:00
0:12
Eine ruhige japanische Marktgasse im Morgengrauen mit schlichten Papierlaternen
Japanische ErzählungMehrsprachig

Japanische Erzählung über einem Morgenmarkt.

0:00
0:12

Technische Spezifikationen

6 Min.

Pro Generierung, vorher 2 Min. bei Seed Audio 1.0

6

Referenzclips pro Generierung, zuvor 3

30

Mit Varianten von Spanisch und Portugiesisch

5

Text zu Audio, Stimmreferenz, Video zu Audio, Videodublierung und Stemtrennung

Anwendungsfälle
Zwei parallele Bänder aus bernsteinfarbenem und blauem Licht, die nebeneinander durch Dunst ziehen

Synchronisation

Fertigen Schnitt einspeisen: Die Synchronfassung folgt dem Bild, Effekte und Musik bleiben.
Ein warmer Lichtstrahl fällt durch die Dunkelheit auf eine gewölbte Glasscheibe

Kurzdramen und Serien

Sechs Minuten decken eine Szene ab. Mit getrennten Spuren überarbeiten Sie eine Zeile ohne neuen Render.
Ein Stapel dünner Glasscheiben, an den Kanten bernsteinfarben leuchtend, wie Buchseiten nach hinten versetzt

Hörbücher und Hörspiele

Erzählung, Figurenstimmen und Raumklang zusammen, dieselbe Besetzung über ein langes Kapitel.
Ein heller weißgoldener Lichtpunkt, von dem weiche Ringe nach außen laufen

Werbespots

Sprecher, Musik-Steigerung und Effekte in einem Zug. Bei Kundenwünschen rendern Sie nur diese Ebene neu.
Ein Ring aus blassgoldenem Licht steht aufrecht im dichten Dunst wie ein Portal

Spielszenen

Figurenzeilen, Umgebungsklang und getimte Effekte für Zwischensequenzen und Trailer, sekundengenau.
Zwei leuchtende, durchscheinende Kugeln stehen einander gegenüber, zwischen ihnen wandert Licht

Podcasts

Intro-Jingle, zwei Hosts, ein Raum, der echt klingt, und für den Schnitt jede Stimme auf eigener Spur.

Prompt-Beispiele
Zwei Kaffeetassen und ein altes Ticket auf einem Café-Tisch am regennassen Fenster

Café-Wiedersehen im Regen

Regencafé, leises Klavier. Lena, nervös: „Ticket aufgehoben?“ Theo lacht.
0:00
0:12
Edit prompt
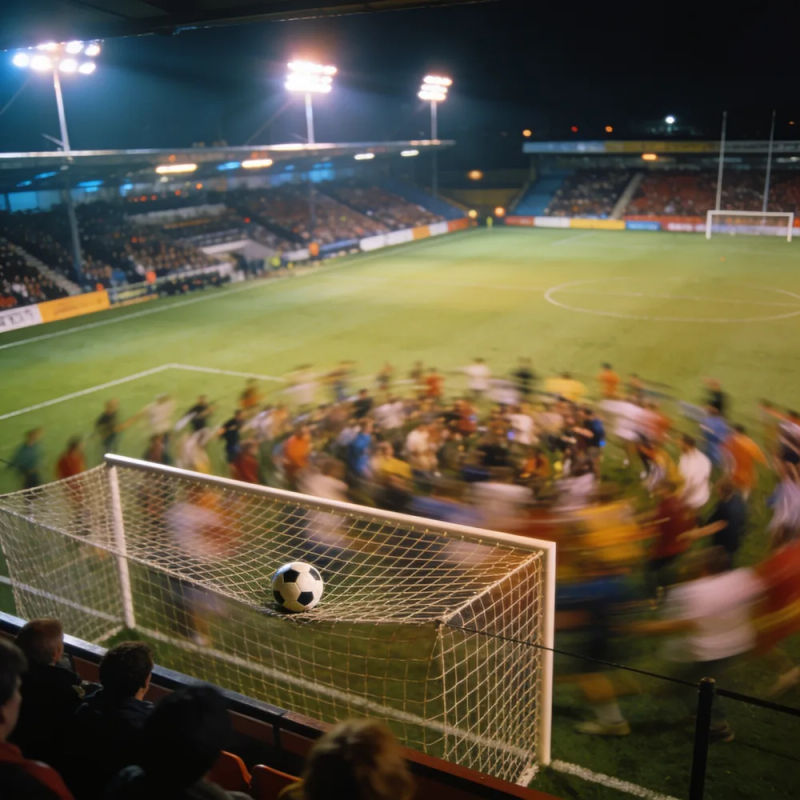
Ein Fußballstadion unter Flutlicht bei Nacht, der Ball liegt im Netz

Stadionruf mit Zeitmarken

[0:00] Menge schwillt an. [0:03] Kommentator: „Tor!“ [0:06] Hupe.
0:00
0:12
Edit prompt
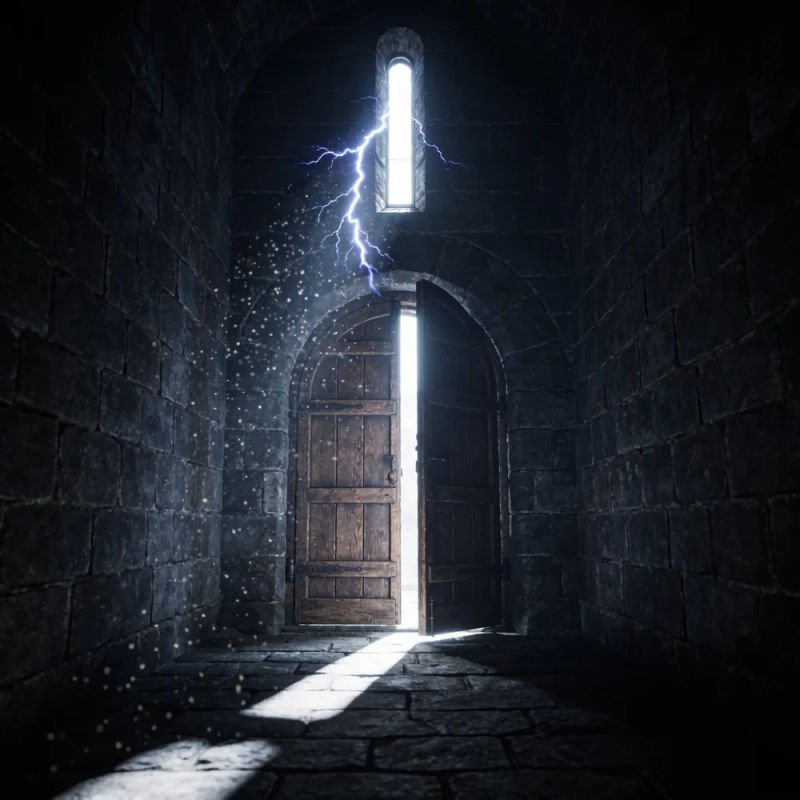
Eine alte Holztür steht einen Spalt offen in einem dunklen Steinkorridor, im hohen Fenster zuckt ein Blitz

Trailer-Erzähler

Tiefe Streicher, Wind. Dunkler Erzähler: „Manche Türen bleiben zu.“ Donner.
0:00
0:12
Edit prompt
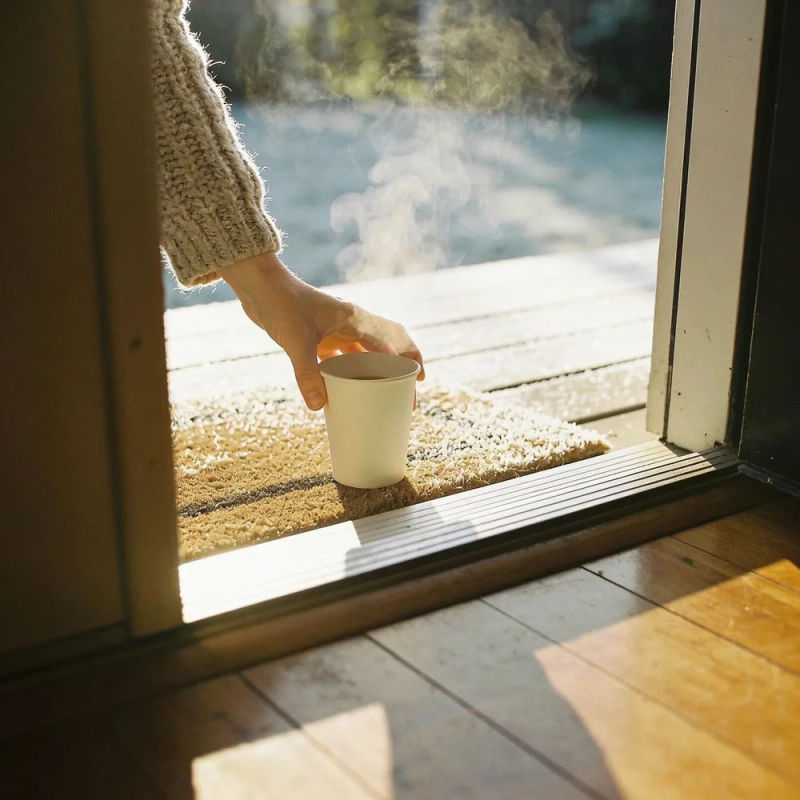
Eine Hand greift durch die Haustür nach einem dampfenden Pappbecher auf der Fußmatte

Kaffeewerbung

Pop-Beat, Kaffee läuft. Helle Stimme: „Kaffee frisch, um acht vor der Tür.“
0:00
0:12
Edit prompt
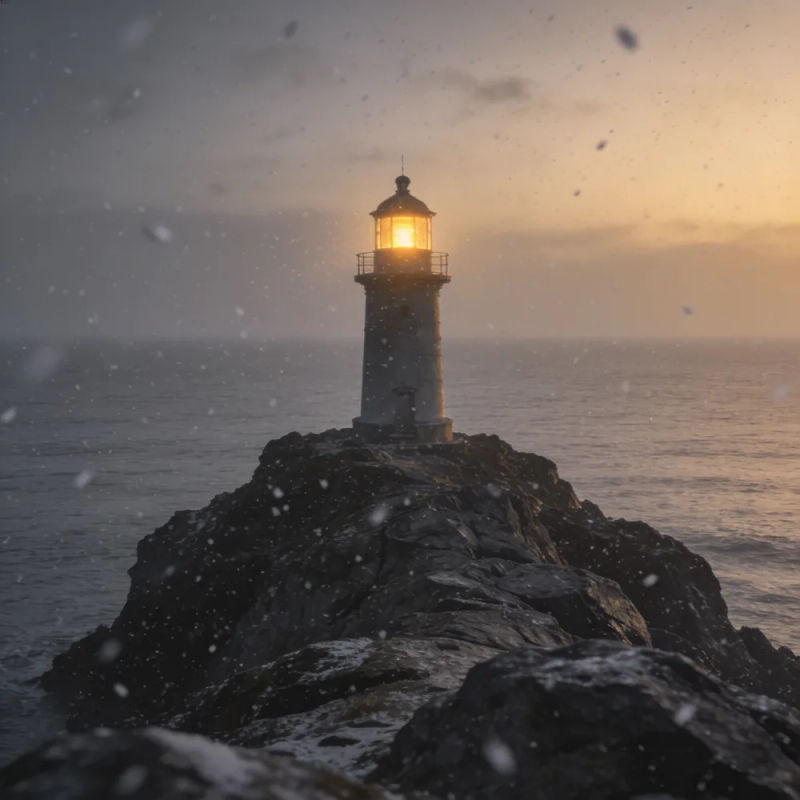
Ein Leuchtturm auf einer steinigen Landzunge in der Dämmerung bei Schneefall

Hörbuch-Auftakt

Feuerknistern, Wind draußen. Erzähler, ruhig: „Ein Schiff fehlte.“
0:00
0:12
Edit prompt
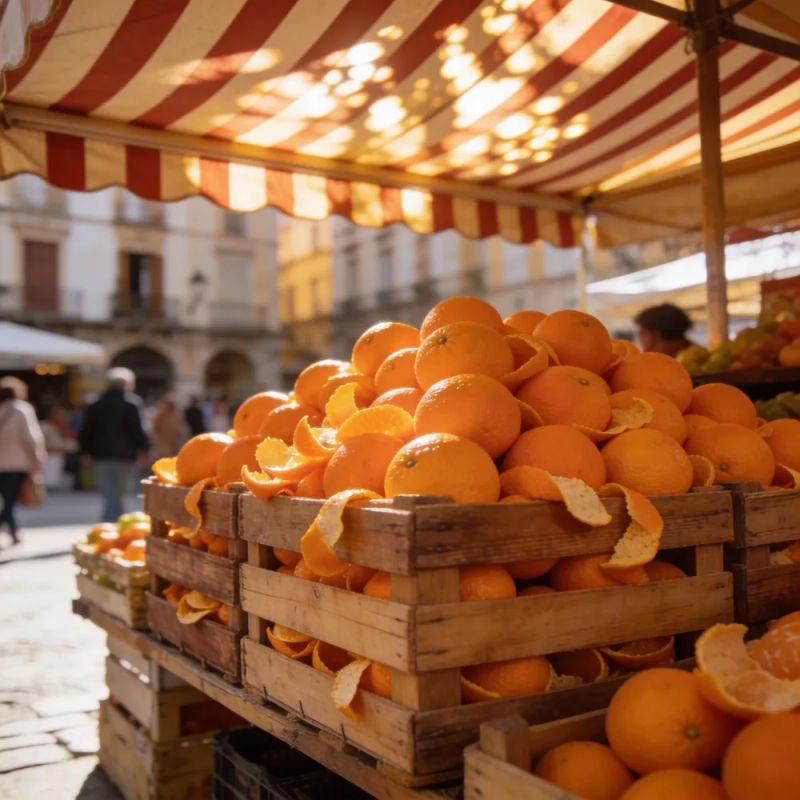
Kisten mit frischen Orangen an einem sonnigen Marktstand auf einem Stadtplatz

Markt auf Spanisch

Markt. Händler, auf Spanisch: „¡Naranjas frescas, a un euro el kilo!“

0:00
0:12
Edit prompt

Overview

Seed Audio 1.5 ist ByteDances Audiomodell für ganze Szenen und der Nachfolger von Seed Audio 1.0. ByteDance hat es am 28. Oktober 2026 veröffentlicht, und die offizielle API ist über BytePlus ModelArk verfügbar. Aus einem Prompt entstehen Dialog, Musik, Ambiente und Soundeffekte. Eine Generierung läuft bis zu sechs Minuten. Als Vorgabe dienen Video, Stimmreferenzen und Zeitmarken.

Was Seed Audio 1.5 anders macht

Die Szene kommt in Ebenen zurück. Dialog, Ambiente, Effekte und Musik liegen auf getrennten Spuren. Eine falsche Zeile oder ein zu lauter Einsatz lässt sich deshalb einzeln korrigieren.

Mit Video als Eingabe folgt der Ton einem fertigen Schnitt. Genau das brauchen Synchronisation und Übersetzung. Für alle, die Inhalte für den deutschen Markt vertonen, ist das der naheliegende Einsatz.

Seed Audio 1.5 auf Morphic

Seed Audio 1.5 kommt bald zu Morphic. Seed Audio 1.0 ist schon jetzt für ganze Szenen verfügbar, neben ElevenLabs, Lyria und den übrigen Audiomodellen. Die Szene bauen Sie also heute auf dem Canvas.

Wie ein Prompt aufgebaut ist, zeigt der Seed Audio 1.5 Prompt-Guide. Zum Einstieg mit einer Beispielszene eignet sich der Seed Audio 1.5 KI-Audiogenerator.

Einfache Preise

Starten Sie noch heute kostenlos, mit der Option, jederzeit zu upgraden oder zu kündigen.

Basic

$19/ Monat
abgerechnet als $228 pro Jahr

2400 monatliche Credits

1 Nutzer

Alle Modelle

Workflows

Standard

$24/ Monat
abgerechnet als $288 pro Jahr

3625 monatliche Credits

1 Nutzer

Alle Modelle

Workflows

Pro

$45/ Monat
abgerechnet als $540 pro Jahr

6350 gemeinsame monatliche Credits

1 Nutzer

+ bis zu 4 weitere gegen Aufpreis

Alle Modelle

Workflows

Max

$170/ Monat
abgerechnet als $2040 pro Jahr

24650 gemeinsame monatliche Credits

1 Nutzer

+ bis zu 9 weitere gegen Aufpreis

Alle Modelle

Workflows

Enterprise

Für höhere Limits

Individuell

Preis- und Abrechnungsbedingungen
High-Volume-Credits
Individuelle Platzlimits
Alle Modelle
Workflows
Pricing Gradient

Free

Zum Ausprobieren

$0

dauerhaft kostenlos

Bis zu 20 Credits
Nur 1 Nutzer
Eingeschränkte Modelle
Workflows

Häufig gestellte Fragen

Was ist Seed Audio 1.5?
Seed Audio 1.5 ist ByteDances Audiomodell für ganze Szenen und der Nachfolger von Seed Audio 1.0. Aus einem Prompt erzeugt es Dialog, Musik, Ambiente und Soundeffekte für eine ganze Szene und liefert sie als getrennte Spuren. Es nimmt auch Video als Eingabe. So kann es Filmmaterial synchronisieren oder einen Schnitt passend zum Bild vertonen.
Ist Seed Audio 1.5 auf Morphic verfügbar?
Seed Audio 1.5 ist veröffentlicht und kommt bald zu Morphic. Seed Audio 1.0 ist schon jetzt verfügbar, neben ElevenLabs, Lyria und weiteren Audiomodellen. Die Beispiele auf dieser Seite entstanden auf Morphic mit ElevenLabs-Stimmen und -Soundeffekten sowie Lyria-Musik, gemischt zu Szenen. Sie zeigen, welche Art von Ausgabe Seed Audio 1.5 liefern soll.
“Wann ist Seed Audio 1.5 erschienen?”
“ByteDance hat Seed Audio 1.5 am 28. Oktober 2026 veröffentlicht. Die offizielle API ist über BytePlus ModelArk verfügbar. Seed Audio 1.0 steht bereits auf Morphic zur Verfügung.”
Darf Seed Audio 1.5 die Stimme einer echten Person oder einen bestehenden Song nachahmen?
Nicht ohne Erlaubnis. ByteDance sperrt erkennbare Nachahmungen der Stimme einer realen Person, sofern keine Einwilligung vorliegt. Dasselbe gilt für urheberrechtlich geschütztes Material, Markenlogos und bestehende Liedtexte. Möglich bleibt, eine Stimme aus eigenen Aufnahmen zu besetzen und eigene Songs mit eigenem Text zu schreiben.
Was ist neu in Seed Audio 1.5 gegenüber Seed Audio 1.0?
Eine Generierung läuft bis zu sechs statt zwei Minuten, und Sie nutzen sechs statt drei Stimmreferenzen. Neu ist Video als Eingabe. Dialog, Ambiente, Effekte und Musik kommen als getrennte Spuren statt als ein Mix. Die Sprachabdeckung wächst von 20 auf 30 Sprachen. Neben Zeilen platzieren Sie jetzt auch Soundeffekte und Musikeinsätze per Zeitmarke.
Welche fünf Eingabemodi hat Seed Audio 1.5?
Erstens Text zu Audio: Der Prompt beschreibt alles, wahlweise mit einem Referenzbild. Zweitens Stimmreferenz: Bis zu sechs Aufnahmen legen die Stimmen fest. Drittens Video zu Audio: Das Modell sieht das Material und schreibt dazu passenden Ton. Viertens Videodublierung: Die Sprache wird in bis zu 30 Sprachen übersetzt, Effekte und Musik bleiben erhalten, und ein Glossar mit bis zu 50 Einträgen schützt Fachbegriffe. Fünftens Stemtrennung: Eine bestehende Aufnahme wird in einzelne Stems zerlegt.
Kann Seed Audio 1.5 ein Video synchronisieren oder übersetzen?
Ja. Mit einem Video als Eingabe erzeugt das Modell eine Synchronfassung samt Soundtrack, die dem Bild über den ganzen Clip folgt. Bei einer Übersetzung ersetzt es die gesprochene Sprache und behält Originaleffekte und Hintergrundmusik. Lassen Sie Aussprache und Wortwahl vor der Veröffentlichung von einer Person prüfen, die die Sprache fließend spricht.
Unterstützt Seed Audio 1.5 Deutsch, und welche Sprachen gibt es noch?
Ja, Deutsch gehört zu den 30 unterstützten Sprachen. Dazu zählen Chinesisch, Englisch, Japanisch, Koreanisch, mexikanisches Spanisch, kastilisches Spanisch, Französisch, brasilianisches Portugiesisch, europäisches Portugiesisch, Thai, Indonesisch, Vietnamesisch, Malaiisch, Filipino, Arabisch, Italienisch, Russisch, Niederländisch, Polnisch, Türkisch, Schwedisch, Finnisch, Dänisch, Norwegisch, Tschechisch, Ungarisch, Griechisch, Rumänisch und Hindi.