Gemini Omni Flash 1.2
de Google DeepMind
El modelo de video de Google, ahora con tomas de quince segundos.
Edita la toma completa por 30% menos cada segundo.
Funciones clave
Especificaciones técnicas
Gemini Omni
Tercera versión de Omni Flash; id del modelo gemini-omni-1.2-flash
3 a 15 s
Segundos enteros, 10 s por defecto; con extensión llega a 30 s
Hasta 4K
360p y 720p nativos; 1080p y 4K por escalado
US$0.07 por segundo
En 720p; cerca de 30% menos que Omni Flash 1.1
6 imágenes
Tres por personaje, para hasta dos personajes, más clips de 3 s
Nativo
Diálogo, efectos y música en la misma pasada
16:9, 9:16
Se cambian sobre una toma terminada con una instrucción de seguimiento
SynthID
Marca de procedencia invisible en cada clip generado
Casos de uso
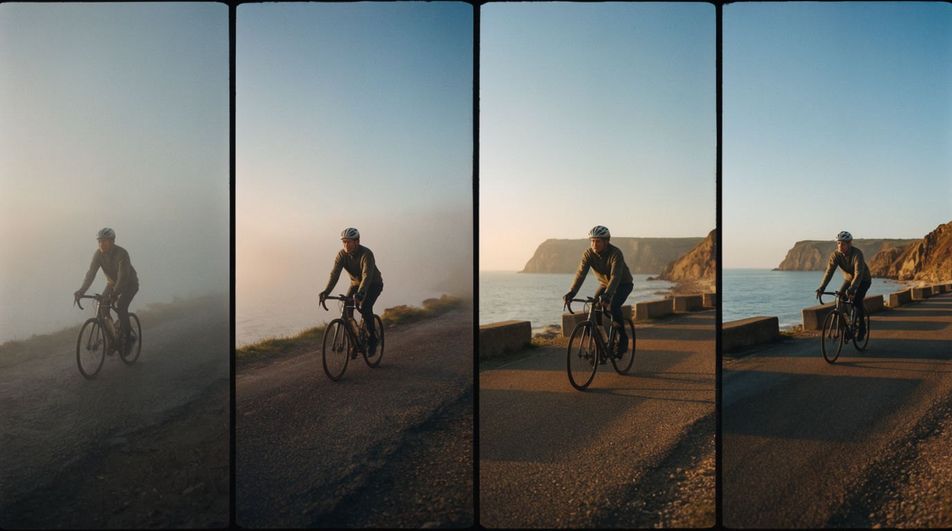
Tomas de quince segundos
Una escena completa en una sola generación: el avance, el giro y la llegada, en lugar de un fragmento de diez segundos que tienes que extender.
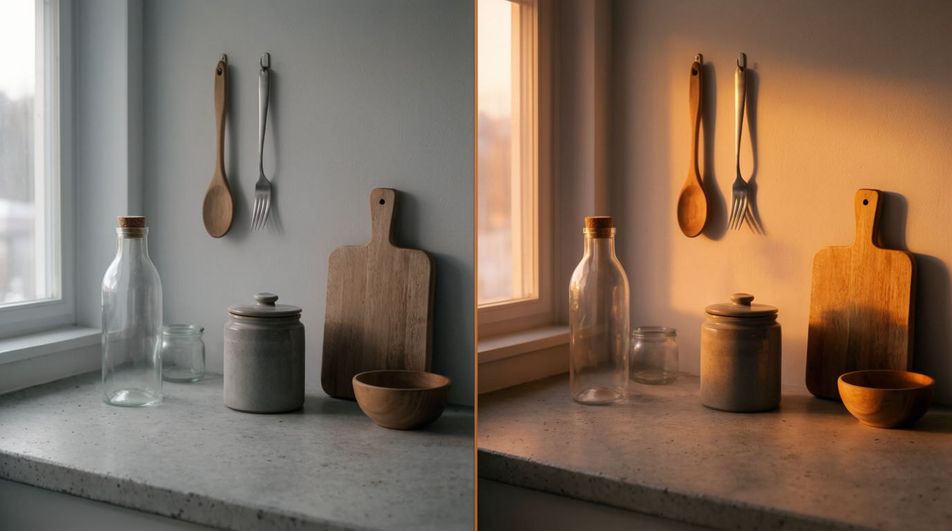
Ediciones que escribes
Entrega la toma y di el cambio: reilumina el cuarto, cambia el frasco, reescribe la etiqueta. El resto del encuadre se queda igual.
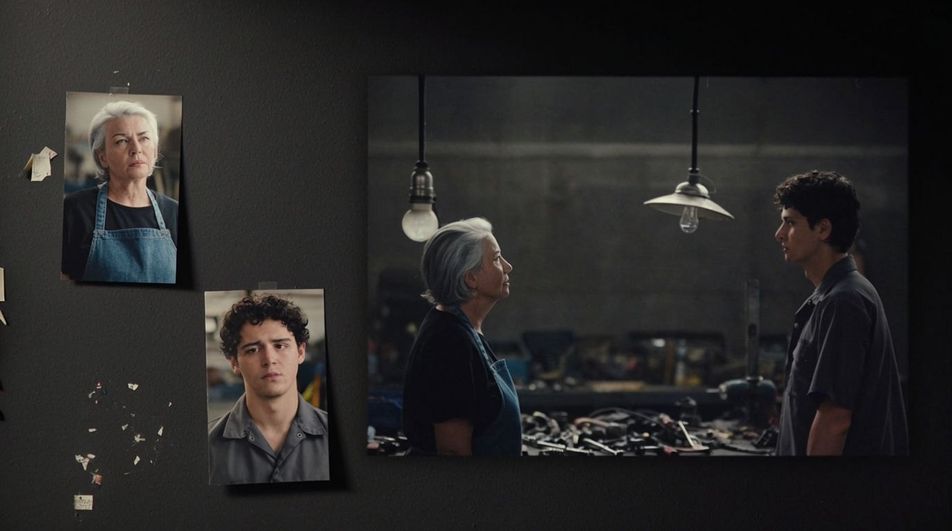
Dos personajes, los dos fijos
Con tres fotos de cada persona quedan fijos los dos rostros y su vestuario. Así una escena de dos se reconoce desde la primera toma hasta la última edición.
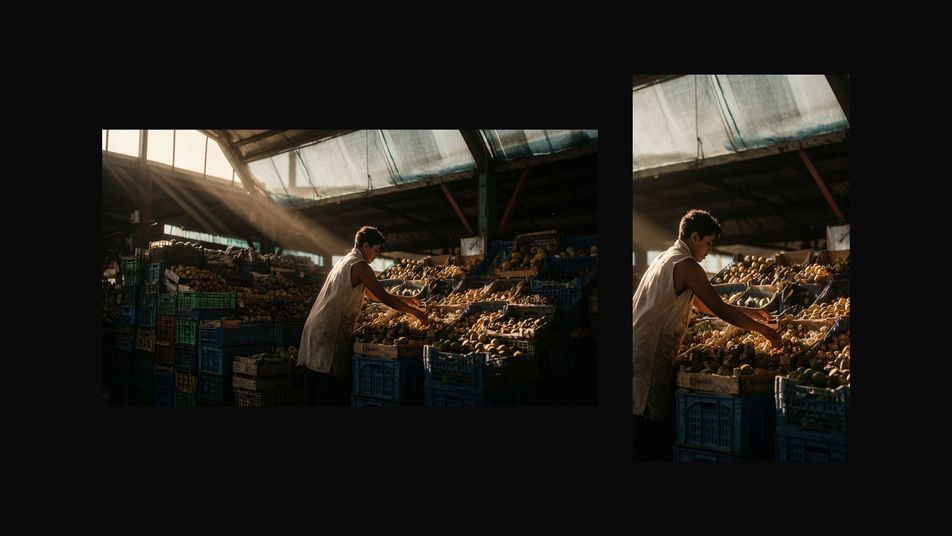
Una toma, dos proporciones
Pide la versión vertical cuando ya aprobaste la horizontal. Es útil para Reels, TikTok y Shorts: la proporción pasa a ser una instrucción de seguimiento, no otra generación.
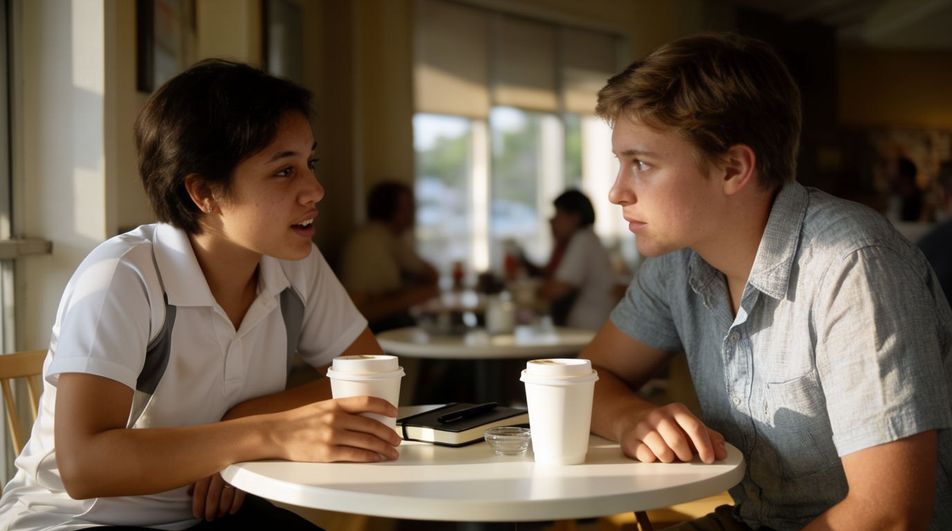
Escenas con dos voces
Escribe las dos partes y cada línea vuelve en la boca correcta, con sincronía labial y con voces que se mantienen en las ediciones siguientes.
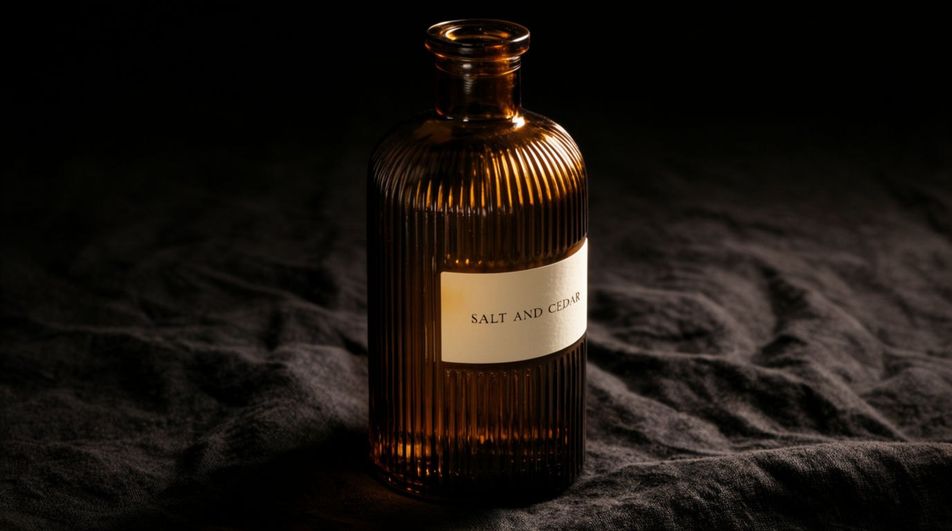
Empaques que no se deforman
Tu propia caja entra como referencia y su tipografía sobrevive al giro de cámara, en vez de disolverse en letras parecidas. Sirve para anuncios de producto.
Ejemplos de prompts
Escena de quince segundos
Quince segundos en una sola toma: un vendedor de elotes empuja su carrito por una plaza al atardecer
Edit promptDos voces
Dos primas discuten sobre cuánto chile lleva el mole, cocina cálida, diálogos que se traslapan
Edit promptMovimiento de cámara
Un solo movimiento de grúa continuo, desde una calle mojada hasta una ventana iluminada
Edit promptGiro de producto
Un frasco de vidrio acanalado gira despacio sobre lino oscuro, con la etiqueta legible
Edit promptToma guiada por el sonido
Primer plano de una cafetera de moka a punto de hervir, con cada tic y cada borboteo audibles
Edit promptDescripción general
Gemini Omni Flash 1.2, que Google escribe como Gemini Omni 1.2 Flash, es la tercera versión del modelo de video multimodal de Google DeepMind, anunciada el 5 de noviembre de 2026. Si haces Reels, anuncios o videos para YouTube, la idea te resultará familiar: entra un prompt, imágenes o clips cortos, y sale video con audio sincronizado. Después, las instrucciones de seguimiento siguen trabajando sobre la misma toma. Lo que cambia es cuánta escena cabe en una generación y cuánto cuesta llegar ahí.
Novedades de Gemini Omni Flash 1.2
Una generación ahora dura hasta quince segundos, en segundos enteros desde tres, cuando la 1.1 se detenía en diez. La edición conversacional cubre el clip completo. Cambiar un producto, el clima o pedir la versión vertical son instrucciones de seguimiento sobre una toma aprobada. Las referencias se organizan por personas: seis imágenes por solicitud, hasta tres para cada uno de dos personajes. Además, Google publica el 720p en cerca de US$0.07 por segundo, alrededor de 30% menos que la tarifa de la 1.1, y los borradores en 360p salen todavía más baratos.
Las mejoras discretas están en lo que se queda quieto. Google describe rostros, ropa, tipografía de empaque y color más estables durante la toma. También menos cortes involuntarios dentro de un movimiento de cámara continuo, un diálogo más natural con mejor sincronía labial y compatibilidad con más de un hablante. Tres áreas siguen sin resolverse: la acción deportiva rápida, los guiones que cambian de rumbo con rapidez y la física compleja.
Quince segundos cambian lo que escribes
Diez segundos son un fragmento. Por eso un prompt para la 1.1 solía describir un solo gesto y dejar el resto a la extensión. Quince segundos ya forman una escena con principio y final, así que el prompt puede llevar una estructura pequeña: el avance, el giro, la llegada. La extensión sigue existiendo para escenas más largas, en turnos de tres a diez segundos hasta un total de treinta, tomando los últimos diez segundos del clip como contexto. La diferencia práctica es que la necesitarás menos veces.
Gemini Omni Flash 1.2 y Morphic
Gemini Omni Flash 1.2 todavía no está en el catálogo de Morphic. Gemini Omni Flash 1.1 sí está, en el selector de modelos de video junto a Veo 3.1, Seedance 2.5, Kling y los demás. Así puedes trabajar hoy con la forma de prompt de la familia y su audio nativo, y correr el mismo brief en varios modelos para compararlos lado a lado en el Canvas. Todos los ejemplos de esta página se hicieron en Morphic con el modelo vivo más cercano, no con la 1.2. Google anunció que las solicitudes a la 1.1 en su propia API se dirigen a la 1.2 desde el 3 de diciembre de 2026. Para la mecánica de los prompts, lee la guía de Gemini Omni Flash 1.2. Si prefieres partir de un ejemplo listo, copia uno de la biblioteca de prompts de Gemini Omni Flash 1.2. También puedes ver qué cambió en la comparación entre la 1.2 y la 1.1 o abrir el generador de video con IA de Gemini Omni Flash 1.2.
Precios simples
Comienza gratis hoy, con la opción de mejorar tu plan o cancelar cuando quieras.
Basic
2400 mensual créditos
1 usuario
Todos los modelos
Workflows
Standard
3625 mensual créditos
1 usuario
Todos los modelos
Workflows
Pro
6350 compartidos mensual créditos
1 usuario
Todos los modelos
Workflows
Max
24650 compartidos mensual créditos
1 usuario
Todos los modelos
Workflows
Enterprise
Para límites más altos
Personalizado
términos de precios y facturación

Free
Para experimentar
$0
gratis para siempre
Preguntas frecuentes
ChatGPT Images 2.6
OpenAI
Modelo de imágenes de OpenAI, de noviembre de 2026. GIF animados, SVG y borradores más rápidos.
SAM 3.1
Meta
El modelo Segment Anything de Meta. Rastrea cualquier sujeto con una máscara que lo sigue.
Seed Audio 1.5
ByteDance
Audio de escena completa de ByteDance. Diálogo, música y efectos en pistas separadas.
FLUX Video Upscale
Black Forest Labs
El escalador de video de Black Forest Labs. Hasta 4K, con el detalle fino reconstruido y el sonido intacto.