OmniHuman 2.0
oleh ByteDance
Model video manusia berbasis audio dari ByteDance.
Satu foto, satu trek, lima menit dalam satu take.
Fitur utama
Spesifikasi berasal dari BytePlus sendiri, dalam pengumuman peluncuran 15 Oktober 2026. OmniHuman 2.0 belum ada di Morphic, jadi klip di halaman ini dibuat di Morphic dengan Veed Fabric. Model itu sudah bisa mengubah satu foto dan satu trek audio jadi video bicara hingga 5 menit.
Spesifikasi teknis
5 menit
Satu shot menerus, menurut BytePlus
60 dtk
Batas satu shot sebelum versi 2.0
Foto + audio
Satu gambar pemeran dan satu trek
Trek apa pun
Ucapan, musik, atau dialog
Contoh penggunaan
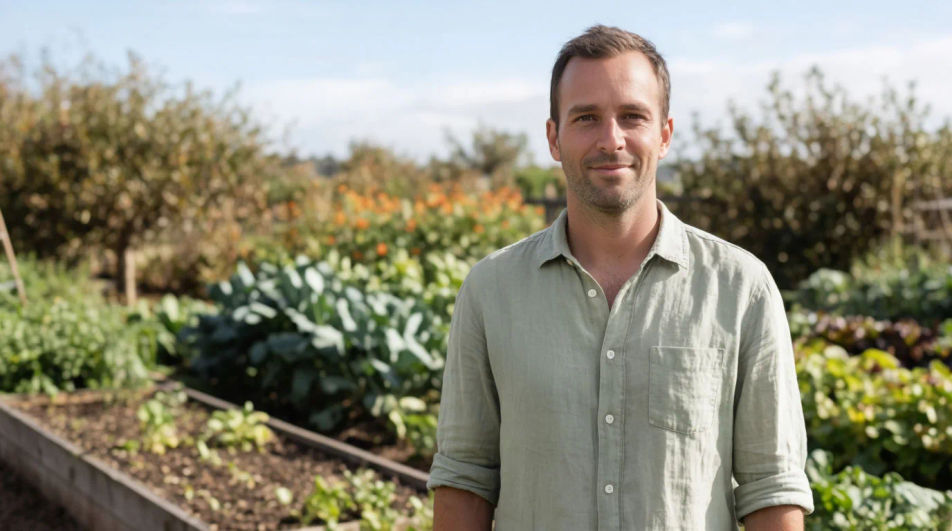
Kursus dan pelajaran
Satu pelajaran penuh dalam satu take. Pengajar tampil sama di menit keempat seperti di menit pertama, dan tidak ada yang perlu disambung.
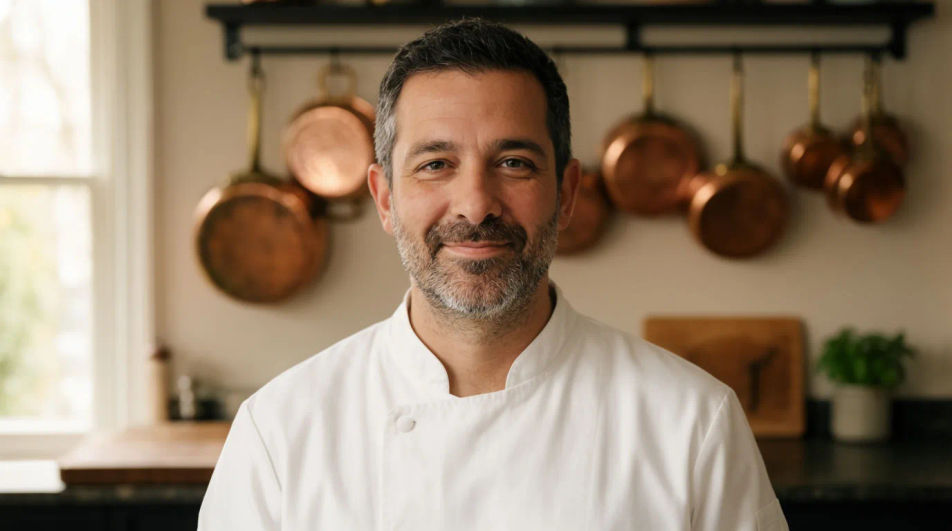
Video penjelasan dan tutorial
Rekam atau buat voiceover dulu, lalu biarkan satu foto menyampaikannya, lengkap dengan jeda dan penekanan yang menjaga penonton tetap menonton.
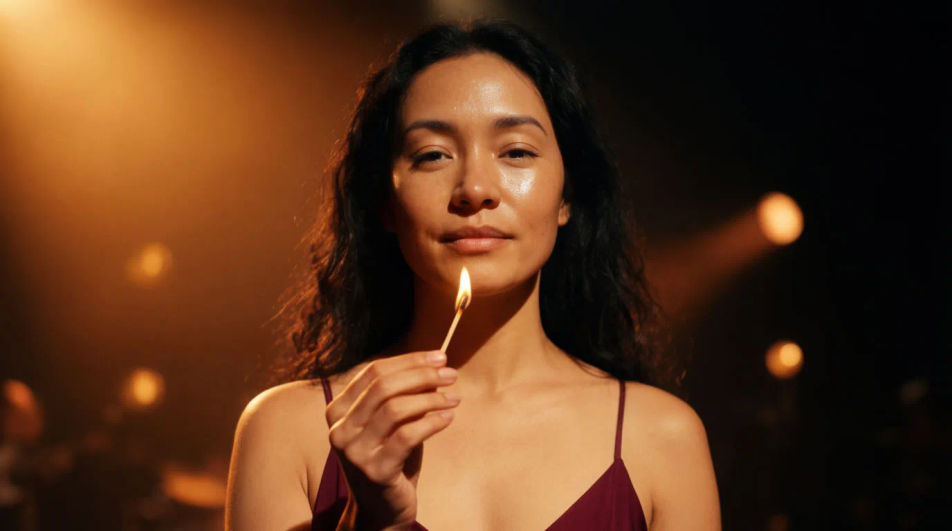
Klip penampilan musik
Beri trek nyanyian, dan wajah ikut membawa nada panjang, tarikan napas, serta rasa lagunya, bukan hanya liriknya.
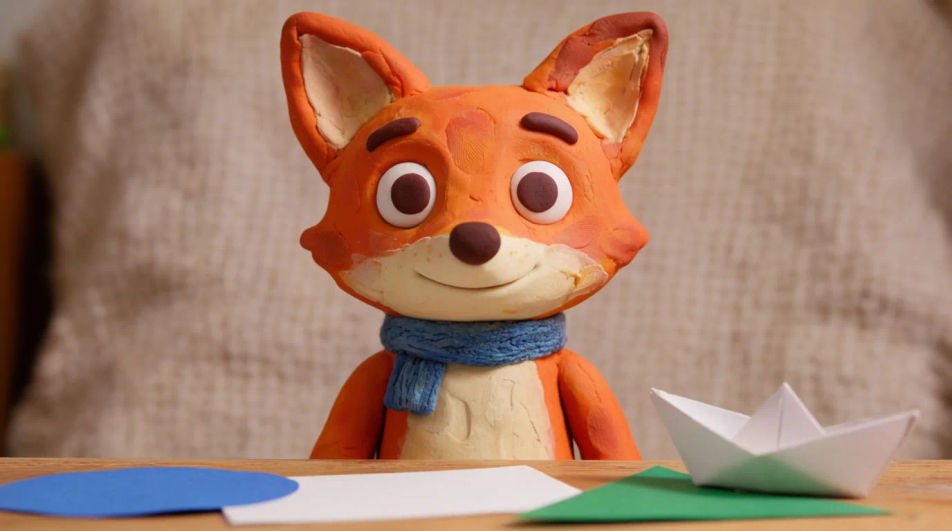
Maskot dan karakter
Beri suara pada maskot brand, karakter clay, atau tokoh ilustrasi untuk iklan, konten anak, dan intro kanal.
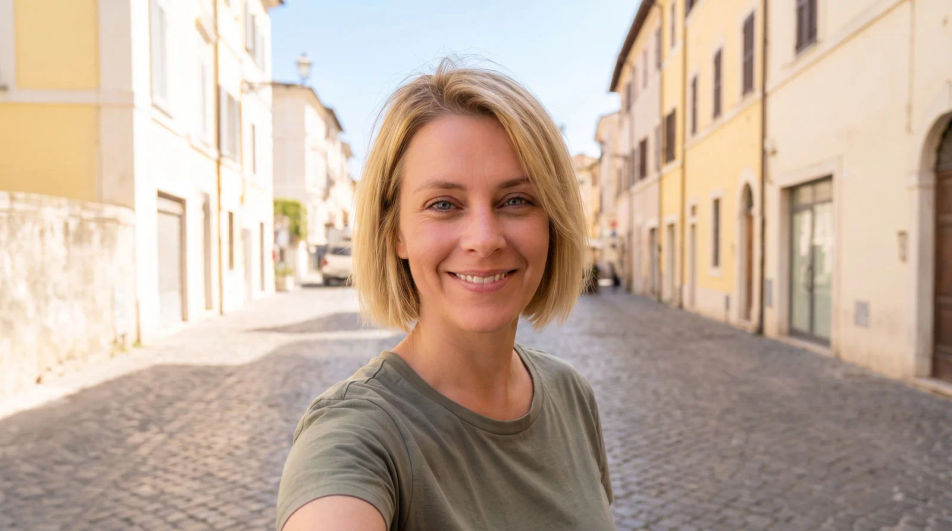
Video kreator dan media sosial
Klip bicara vertikal untuk Reels dan Shorts dari satu foto bergaya swafoto dan satu trek suara, siap diunggah.
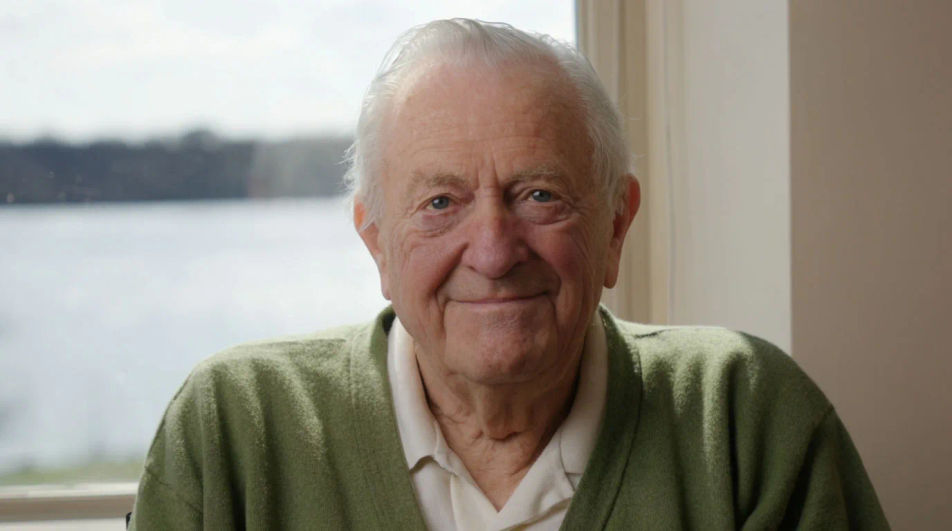
Cerita dan podcast
Cerita lisan yang panjang tetap terjaga iramanya, dari bagian pembuka yang tenang sampai kejutan di akhir, tanpa pemeran yang mengulang tiap menit.
Ikhtisar
OmniHuman 2.0 adalah model video manusia berbasis audio dari ByteDance, dirilis lewat BytePlus pada 15 Oktober 2026. Model ini mengubah satu foto dan satu trek audio menjadi video orang itu membawakan trek tersebut. Yang dibaca bukan hanya bentuk mulut, tetapi juga nada, emosi, dan kata dalam audio. Satu shot kini bisa sampai 5 menit, naik dari 60 detik, tanpa sambungan (sumber).
Bagi pemilik usaha kecil, pengajar kursus online, dan kreator konten, artinya jelas. Satu foto dan satu voiceover sudah cukup untuk video penjelasan produk, pelajaran lengkap, atau klip untuk TikTok dan Reels. Anda tidak perlu menyewa studio atau merekam ulang.
Apa yang berbeda dari OmniHuman 2.0
Kebanyakan model foto bicara hanya menggerakkan mulut mengikuti bunyi. OmniHuman 2.0 mendengarkan cara sebuah kalimat diucapkan. Dongeng yang dibisikkan, teriakan aba-aba pelatih, dan satu nada panjang dalam lagu menghasilkan penampilan yang berbeda dari jenis input yang sama.
Take yang lebih panjang sama pentingnya. Pelajaran, cerita, atau lagu penuh berjalan sebagai satu shot. Karena itu tidak ada titik sambung tempat wajah, cahaya, atau latar bisa berubah.
OmniHuman 2.0 di Morphic
OmniHuman 2.0 segera hadir di Morphic. Sampai saat itu, Veed Fabric mengerjakan hal yang sama: buka Copilot, lampirkan foto dan trek audio, lalu minta video bicara. Semua klip di halaman ini dibuat dengan cara itu. Tips untuk hasil terbaik ada di panduan OmniHuman 2.0.
Harga sederhana
Mulai gratis hari ini, dengan opsi untuk upgrade atau membatalkan kapan saja.
Basic
2400 bulanan kredit
1 pengguna saja
Semua model
Workflows
Standard
3625 bulanan kredit
1 pengguna saja
Semua model
Workflows
Pro
6350 bersama bulanan kredit
1 pengguna
Semua model
Workflows
Max
24650 bersama bulanan kredit
1 pengguna
Semua model
Workflows
Enterprise
Untuk batas yang lebih tinggi
Khusus
ketentuan harga dan penagihan

Free
Untuk bereksperimen
$0
gratis selamanya
FAQ
Selengkapnya tentang OmniHuman 2.0
Panduan, prompt, dan perbandingan untuk OmniHuman 2.0.
Model lainnya
Jelajahi katalog model Morphic selengkapnya.
Mirelo SFX 2.0
Mirelo AI
Model video-ke-suara dari Mirelo. Suara baru untuk video Anda, dialog tetap sama.
Fish Audio Drama 3
Fish Audio
Model suara Fish Audio yang paling ekspresif. Arahkan setiap penampilan, sampai ke tiap kata.
Vidu Q4
Shengshu Technology
Model video terbaru Shengshu. Hingga 12 gambar referensi dan 3 suara tetap konsisten dalam satu klip, audio bawaan, 540p sampai 4K.
Nano Banana 2.1
Google DeepMind
Model gambar Flash baru Google DeepMind. Desain rapi, edit bersih, karakter stabil.