HeyGen Video 1
HeyGen 提供
HeyGenのテキストから動画を作る生成AI。
映像と音声を、1回でまとめて生成します。
主な機能
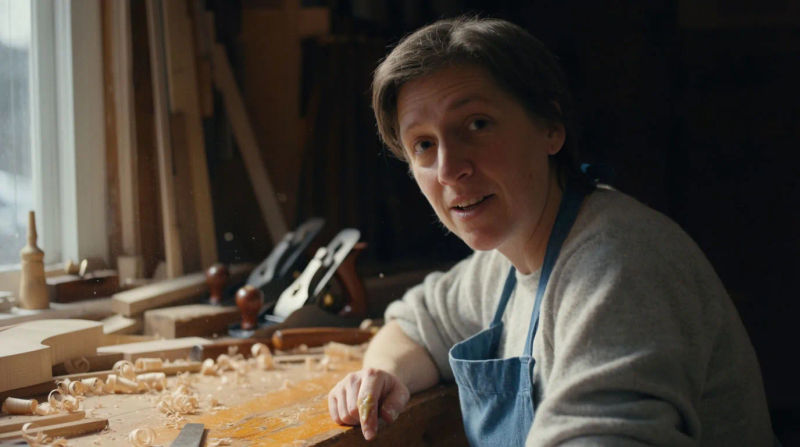
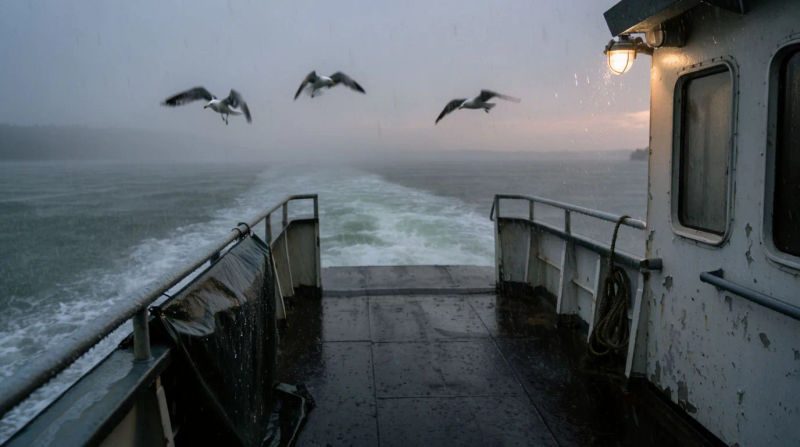
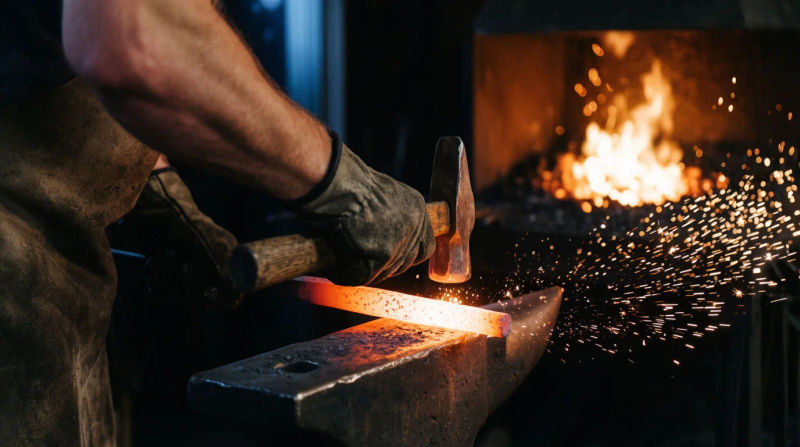
スペックはHeyGenが公開しているHeyGen Video 1のモデル情報にもとづきます。HeyGen Video 1はMorphicでは使えません。このページのクリップは、音声つきで動画を生成できる現行のMorphic H3と、セリフ入りのクリップにはVeo 3.1を使い、Morphicで作ったものです。プロンプトの横にある静止画はKrea 2 Largeで作ったもので、それぞれのプロンプトが描く内容を示すためのものです。HeyGen Video 1が出力したフレームではありません。
技術仕様
15秒
1クリップあたり。5秒から指定できます
2K
480p、768p、1080p、2Kから選べます
ネイティブ
セリフ・環境音・効果音を同じ生成で作ります
画像
参照ベースの生成で、渡した画像に沿って動かせます
活用事例
セリフ入りの広告
カメラに向かって話す短いクリップも、セリフと部屋の音、口の動きがそろった状態で出てきます。そのまま投稿に回せます。
料理・屋台のシーン
にぎやかな場面は音も一緒に生まれます。焼ける音、人混み、食器の触れ合う音まで入るので、市場や厨房のクリップが素材ライブラリなしで生きてきます。
シネマティックなBロール
雨や風、部屋の響きが、映像のタイミングに合わせて付きます。挿入カットが、映っている場所そのものの音になります。
スポーツ・アクション
動きの速い場面では、打球やバウンドがビートに合って鳴ります。ラリーも疾走も、無音のクリップではなく動きと音がひと続きで伝わります。
商品・クラフトの映像
手元のアップには、ろくろの回る音や湿った土、水の音といった細かな音が入ります。制作風景のクリップが、手仕事らしい臨場感を持ちます。
暮らし・ライフスタイル
やかんの湯気やフライパンの音、朝のラジオといった日常の音が付きます。ストック映像らしさが消えて、本物のキッチンの空気が出ます。
プロンプト例
概要
HeyGen Video 1は、HeyGenのテキストから動画を作る生成AIです。映像と音声を1回の生成で作るので、セリフも環境音も効果音も、画面の動きに合った状態でクリップが返ってきます。長さは5〜15秒、解像度は最大2K。21:9のワイドから9:16の縦型まで選べます。
HeyGen Video 1ならではの点
多くの動画生成AIが返すのは、音のないクリップです。音は別の作業になります。効果音を探して、タイミングを合わせて、声を足して、リップシンクをかける。そんな手間が残ります。
HeyGen Video 1は、映像と同時にサウンドトラックも作ります。言葉も部屋の響きも動きの音も、受け取った時点で場面に合っています。MiniMax H3に追加学習を施したモデルで、HeyGenが独自の映像と音に調整しました。クリップの再生中も、場面がぶれずにまとまります。
MorphicでHeyGen Video 1を使うには
HeyGen Video 1はMorphicでは使えません。音声つきの動画生成なら、現在はMorphic H3が同じ役割を果たします。Copilotを開いて、場面と欲しい音を書くだけです。映像と同期したサウンドトラックが、1回の生成で返ってきます。
セリフとリップシンクが要になるクリップには、Veo 3.1が向いています。このページのクリップも、すべてその使い分けで作りました。プロンプトの書き方はHeyGen Video 1 guideに、ベースモデルとの違いはHeyGen Video 1 vs MiniMax H3にまとめています。
シンプルな料金体系
今すぐ無料で始めて、いつでもアップグレードまたはキャンセルできます。
Basic
2400 月 クレジット
1 ユーザーのみ
すべてのモデル
ワークフロー
Standard
3625 月 クレジット
1 ユーザーのみ
すべてのモデル
ワークフロー
Pro
6350 共有 月 クレジット
1 ユーザー
すべてのモデル
ワークフロー
Max
24650 共有 月 クレジット
1 ユーザー
すべてのモデル
ワークフロー
Enterprise
より高い制限のために
カスタム
料金と請求条件

Free
気軽に試したい方に
$0
ずっと無料
よくある質問
HeyGen Video 1をもっと知る
HeyGen Video 1のガイド、プロンプト、比較。
その他のモデル
Morphicのモデルカタログをさらに見る。
Seedream 5.5
ByteDance
2026年11月リリースのByteDance製Seedream画像モデル。 崩れないマルチラウンド編集、自然なリアリティ、より鮮明な文字。
Gemini Omni Flash 1.2
Google DeepMind
Googleの動画モデルが、15秒に伸びました。 テイク全体を直せて、1秒あたり約30%安くなっています。
ChatGPT Images 2.6
OpenAI
OpenAIの画像モデル、2026年11月公開。 GIF、SVG、速い下書きに対応。
SAM 3.1
Meta
MetaのSegment Anythingモデル。 どんな被写体も、追従するマスクにして追跡します。