Seed Audio 1.5: gerador de áudio com IA

Modelo da ByteDance para áudio de cena. Diálogo, música e efeitos em camadas.

Todos os modelos de áudio

Em um só lugar

Cenas completas, não só vozes

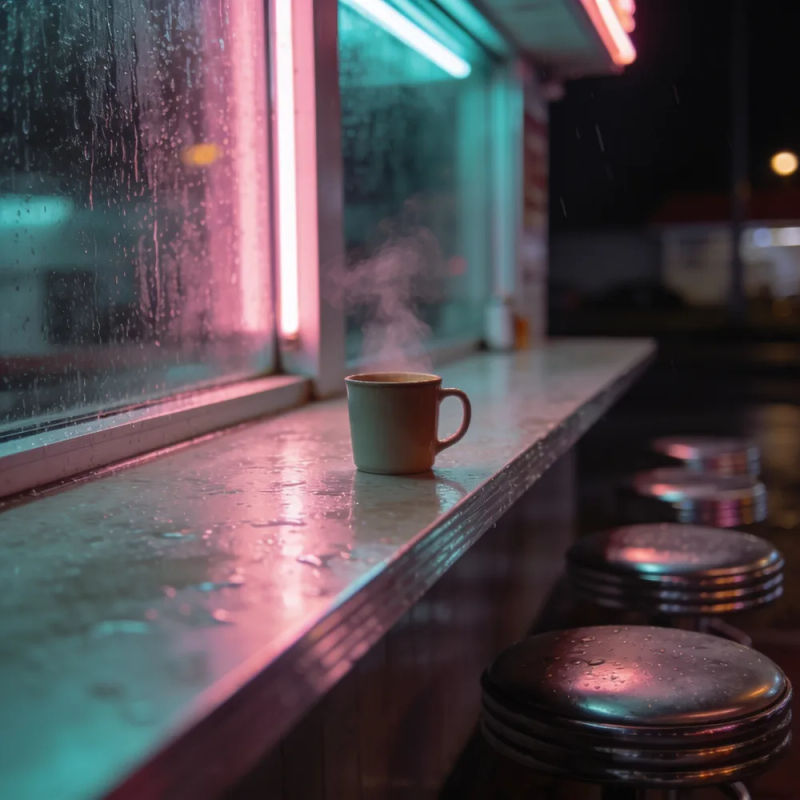
Balcão de uma lanchonete de madrugada, com uma caneca fumegante e chuva na janela
Lanchonete de madrugada
[Diner at 2 a.m., a fridge hums, rain outside.] Waitress (50s, kind): "Coffee's on the house tonight, hon." Driver (tired, grateful): "You're an angel. Long road tonight."
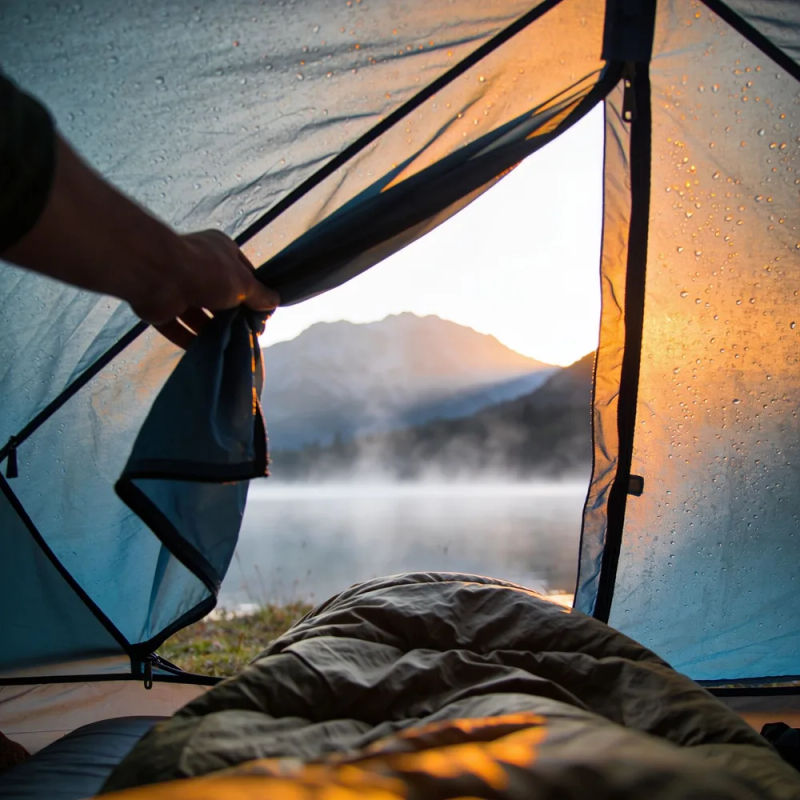
Uma mão abrindo o zíper de uma barraca, ao amanhecer, diante de um lago de montanha com neblina
Anúncio de camping
[Warm acoustic guitar builds.] Narrator (warm, smiling): "Weekend plans? Pack light. We've got the tent." [0:08] The music swells and a tent zipper closes.
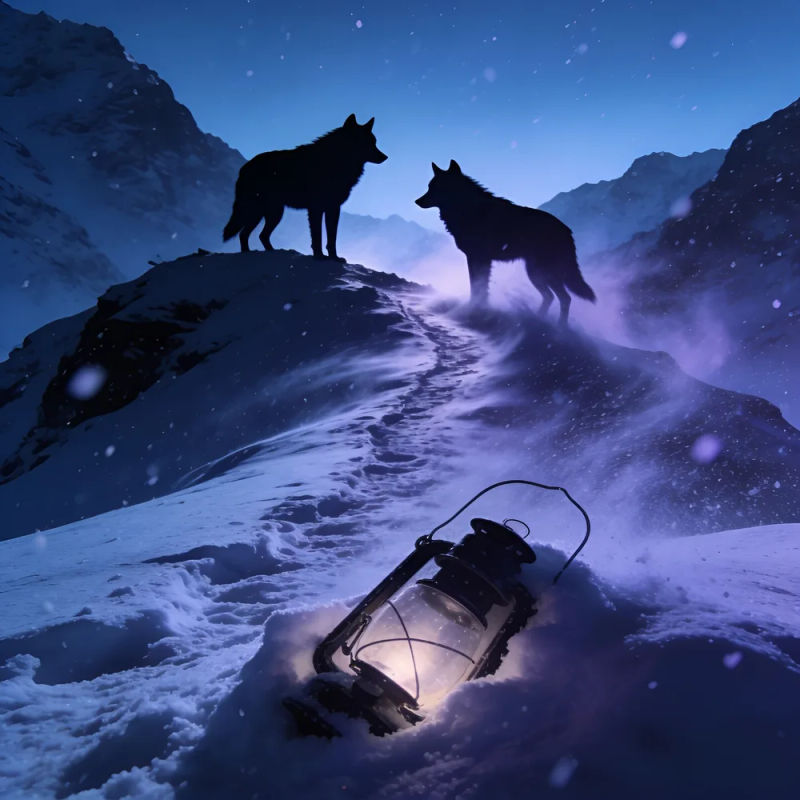
Dois lobos em uma crista nevada na hora azul, com uma lanterna na neve
Cena de jogo
[Snowy mountain pass, howling wind, tense low strings.] Scout (urgent whisper): "Wolves. Two of them. Don't move." [0:06] A low growl, close by.
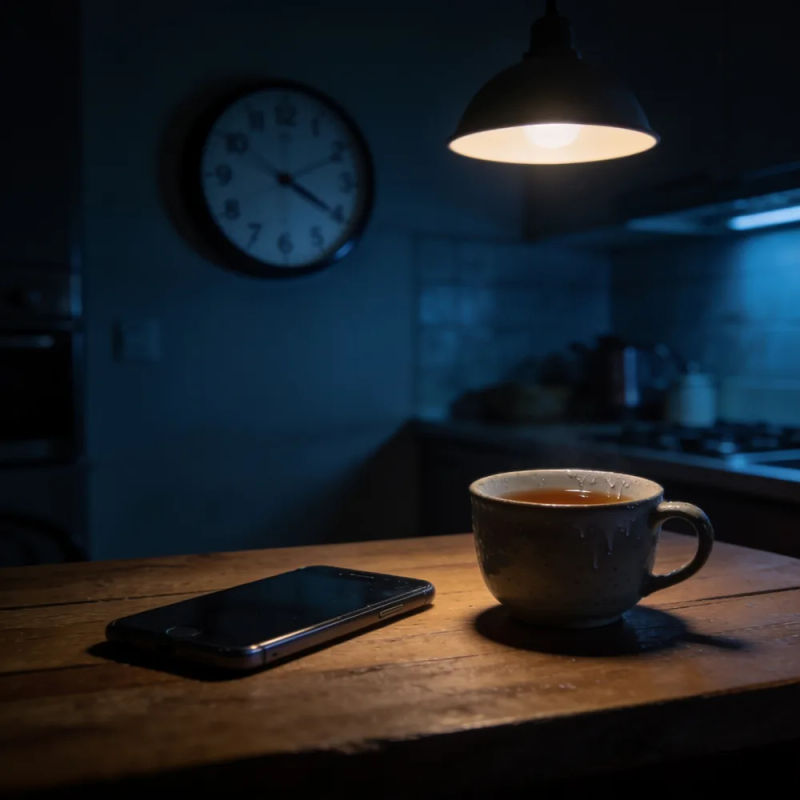
Cozinha na penumbra à noite, com um relógio de parede, um celular virado para baixo e uma xícara de chá frio
Drama curto
[Kitchen, late evening, a clock ticks, soft piano.] Mother (quiet, hurt): "You didn't call." Son (defensive, then soft): "I was busy, Mom, I... I know. I'm sorry."
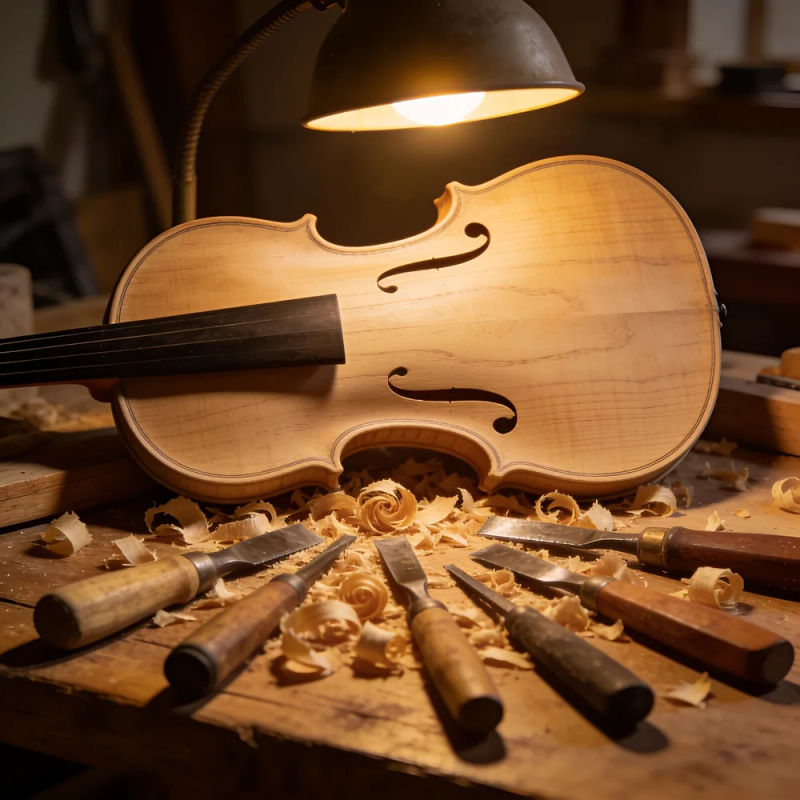
Corpo de violino inacabado sobre uma bancada, com ferramentas de entalhe e aparas de madeira
Documentário artesanal
[Workshop at night, a lamp hums, a chisel shaves wood, a solo violin far off.] Narrator (warm, hushed): "Every violin starts as a block of spruce... and a lot of patience."
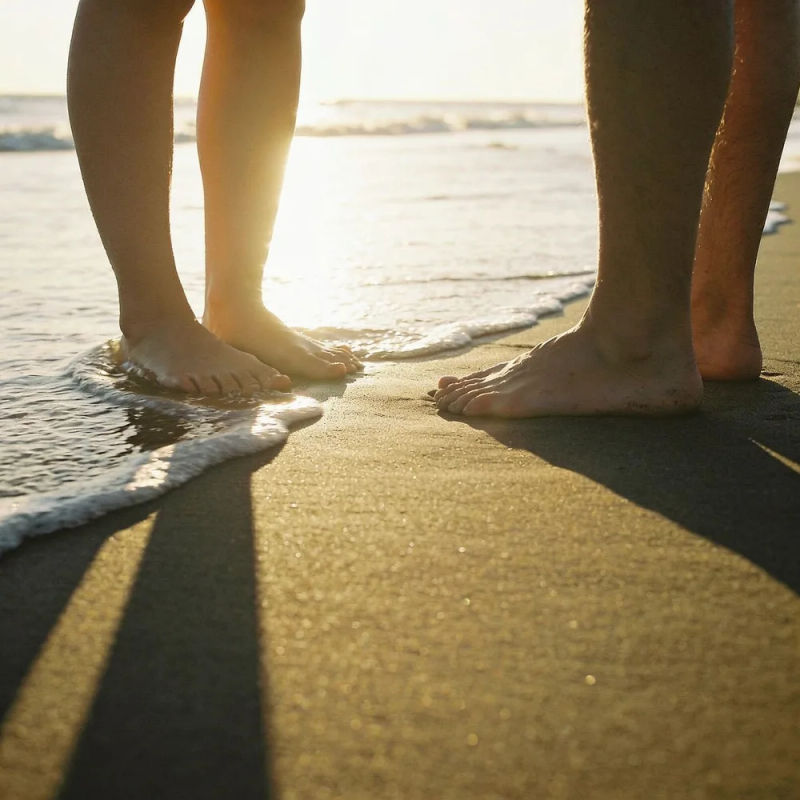
Dois pares de pés descalços na areia molhada enquanto uma onda recua ao pôr do sol
Português brasileiro
[Beach at sunset, gentle waves, soft bossa nova guitar.] Narrator (relaxed, warm, Brazilian Portuguese): "O sol já está indo embora... fica mais um pouco."

Principais recursos

Crie o áudio de uma cena em três passos

  1. 01

    Abra o Morphic

    Cadastre-se e comece a criar em um Canvas visual infinito e livre.

  2. 02

    Escreva a cena

    Descreva o lugar, escolha as vozes e escreva as falas. Se tiver vozes de referência ou um vídeo, anexe também.

  3. 03

    Gere e edite por faixa

    Diálogo, ambiência, efeitos e música voltam separados, então você ajusta uma camada e mantém o resto.

O que o Seed Audio 1.5 gera

Uma cena inteira a partir de um prompt

Vozes, som do ambiente, efeitos e trilha chegam juntos e já equilibrados. Um café, uma tempestade ou um estádio soa como um lugar, não como uma voz sobre o silêncio.
Três ondas sonoras translúcidas em âmbar, prata e verde-azulado se fundindo em uma só forma

Dublagens que acompanham a imagem

Envie um corte finalizado e o Seed Audio 1.5 escreve a dublagem, a trilha e os efeitos de acordo com a ação. Traduza o diálogo e mantenha a música e os efeitos originais.
Uma moldura retangular de luz brilhante, com ondas se espalhando a partir da borda inferior

Faixas separadas para a edição

Diálogo, ambiência, efeitos e música voltam em faixas próprias. Abaixe a música, silencie um efeito ou troque uma fala sem mexer no resto.
Quatro tiras de vidro luminosas em âmbar, verde-azulado, prata e rosa flutuando separadas na névoa

Cenas de seis minutos

Uma cena de drama, um trecho de podcast ou um capítulo narrado cabe em uma única geração, com até seis vozes definidas por clipes de referência.
Uma longa linha de horizonte de luz suave que se estende em profundidade, como uma onda sonora lenta

Tudo no Morphic

Sua central completa de áudio

Preços simples

Comece grátis hoje mesmo, com a opção de fazer upgrade ou cancelar quando quiser.

Basic

$19/ mês
cobrado como $228 por ano

2400 mensal créditos

1 apenas usuário

Todos os modelos

Workflows

Standard

$24/ mês
cobrado como $288 por ano

3625 mensal créditos

1 apenas usuário

Todos os modelos

Workflows

Pro

$45/ mês
cobrado como $540 por ano

6350 compartilhado mensal créditos

1 usuário

+ até 4 mais com custo adicional

Todos os modelos

Workflows

Max

$170/ mês
cobrado como $2040 por ano

24650 compartilhado mensal créditos

1 usuário

+ até 9 mais com custo adicional

Todos os modelos

Workflows

Enterprise

Para limites maiores

Personalizado

termos de preços e cobrança

Créditos de alto volume
Limites de vagas personalizados
Todos os modelos
Workflows
Pricing Gradient

Free

Para experimentar

$0

grátis para sempre

Até 20 créditos
apenas 1 usuário
Modelos limitados
Workflows

Perguntas frequentes

O que é o gerador de áudio com IA Seed Audio 1.5?
É o modelo Seed Audio 1.5, da ByteDance, para áudio de cena completa. Um prompt devolve diálogo, música, ambiência e efeitos em faixas separadas, com até seis minutos. Com um vídeo de entrada, o som acompanha o corte pronto, para dublagem e design de som.
Quando o Seed Audio 1.5 chega ao Morphic?
A ByteDance lançou o Seed Audio 1.5 em 28 de outubro de 2026, e ele chega ao Morphic em breve. Até lá, o Seed Audio 1.0 já está no Morphic para cenas completas, ao lado do ElevenLabs e do Lyria. Os exemplos desta página foram feitos no Morphic com vozes e efeitos sonoros do ElevenLabs e música do Lyria, misturados em cenas.
O gerador de áudio com IA Seed Audio 1.5 é grátis?
O Morphic tem um plano grátis, então dá para começar a criar áudio sem pagar nada. Quando o Seed Audio 1.5 chegar ao Morphic, ele usa os mesmos créditos dos outros modelos de áudio. Os planos pagos trazem mais créditos para cenas mais longas.
Dá para usar o Seed Audio 1.5 em português brasileiro, inclusive para dublar?
Tudo roda no navegador, sem instalar nada. Para dublar em português, envie o vídeo e peça a tradução do diálogo: o modelo mantém os efeitos e a música originais. Os exemplos da página, incluindo o de português brasileiro, foram feitos no Morphic com ElevenLabs e Lyria. Os idiomas que o Seed Audio 1.5 cobre estão na página do modelo.
Como funcionam as faixas separadas?
O Seed Audio 1.5 devolve diálogo, ambiência, efeitos e música em faixas próprias, em vez de um arquivo misturado, e pode separar o diálogo por voz. Você abaixa uma camada, silencia ou troca uma única fala sem gerar o resto da cena de novo.
O Seed Audio 1.5 consegue dublar um vídeo?
Consegue. Envie um vídeo e o modelo escreve locução, música, efeitos e ambiência de acordo com a ação. Ele também pode traduzir o diálogo para outro idioma e manter os efeitos e a música originais. Peça a alguém fluente para revisar o resultado antes de publicar.
Qual a duração máxima de uma geração no Seed Audio 1.5?
Até seis minutos em uma única geração, três vezes o limite de dois minutos do Seed Audio 1.0. Cabe uma cena de drama completa, um trecho de podcast ou um capítulo narrado de uma só vez.
Dá para clonar uma voz com o Seed Audio 1.5?
Dá para anexar até seis clipes de referência para definir as vozes de uma cena, desde que você tenha os direitos sobre eles. Os limites da ByteDance bloqueiam a imitação da voz de uma pessoa real sem a permissão dela.

Você também pode gostar