Seed Audio 1.5 est le prochain modèle audio de scène complète de ByteDance, bientôt disponible sur Morphic. Un seul prompt renvoie dialogues, musique, ambiance et effets sonores sur des pistes séparées, jusqu'à six minutes. Ce guide explique comment écrire pour lui. Pour vous faire la main dès maintenant, ouvrez le générateur audio IA Seed Audio 1.5.
Comment est construit un prompt Seed Audio 1.5
Écrivez la scène dans l'ordre où l'auditeur l'entend : où l'on se trouve, qui parle, ce qui se dit, puis ce qui se passe autour. L'histoire d'abord, la liste des sons ensuite.
| Élément | Ce qu'il faut écrire | Exemple |
|---|---|---|
| Scène | Lieu, moment, météo, taille de la pièce | [Nuit. Un quai de gare désert, de la pluie sur le toit.] |
| Voix | Nom, âge, accent, émotion, débit | Mara (la trentaine, ton calme, voix lasse) |
| Réplique | Les mots exacts, entre guillemets | « Le dernier train est parti. » |
| Effets sonores | La source et la façon dont elle se déplace | [Des pas sur le béton mouillé, qui s'éloignent.] |
| Musique | Genre, instruments, ambiance, niveau | [Une nappe de synthé grave sous toute la scène.] |
| Minutage | Un timestamp là où ça compte | [0:06] Les pas commencent. |
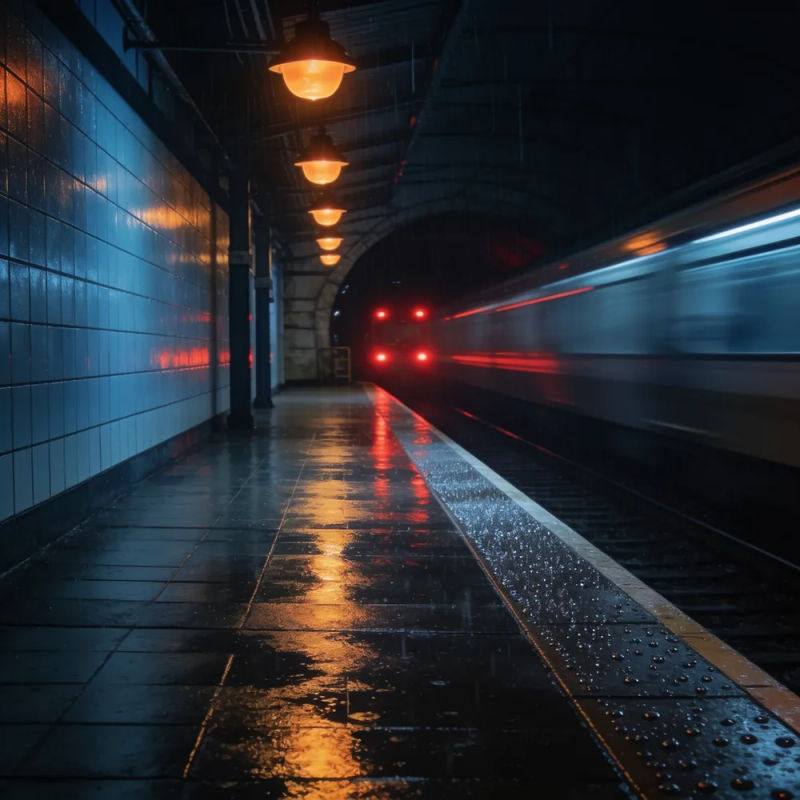
Seed Audio 1.5 n'est pas encore sorti. Ces échantillons ont donc été créés sur Morphic, avec des voix et des effets sonores ElevenLabs et de la musique Lyria, mixés pour correspondre à chaque prompt. Les répliques sont en anglais.
Les quatre modes d'entrée de Seed Audio 1.5
Chaque mode part d'un prompt texte. Ce que vous y ajoutez décide de la part que le modèle invente et de la part qu'il suit.
| Mode | Ce que vous ajoutez | Idéal pour |
|---|---|---|
| Texte | Rien d'autre : le prompt décrit chaque voix et chaque son | Premiers jets, publicités, nappes sonores |
| Texte + audio | Jusqu'à six extraits de référence pour les voix | Une distribution récurrente, une voix de narration que vous utilisez déjà |
| Texte + vidéo | Un clip vidéo que le modèle regarde | Doublage, mise en musique d'un montage, sound design calé sur l'image |
| Texte + audio + vidéo | La vidéo plus des voix de référence | Doublage avec une distribution fixe d'un épisode à l'autre |
Les timestamps dans Seed Audio 1.5
Seed Audio 1.0 acceptait une fenêtre de temps sur les dialogues, par exemple [5.5s:8.0s]. Seed Audio 1.5 étend les timestamps aux effets sonores et aux repères musicaux. Une porte, une pointe de musique ou une montée tombent là où vous les placez, et non là où le modèle les devine.
- Calez les moments qui doivent tomber sur l'image : une réplique sur une coupe, un impact sur un coup, une montée sur une révélation.
- Laissez le reste sans minutage. Le bruit de fond de la pièce et la musique d'ambiance sonnent plus naturels quand le modèle les place lui-même.
- Gardez les timestamps dans l'ordre et laissez un peu d'air entre les répliques, pour éviter que la parole se chevauche par accident.
[0:00] Murmures de la salle dans un petit théâtre. [0:04] Les lumières s'éteignent d'un clic. [0:05] Camille (voix chaleureuse, feutrée) : « Bienvenue à toutes et à tous. » [0:09] Un seul accord de piano.
Les voix de référence dans Seed Audio 1.5
Ajoutez jusqu'à six extraits de référence, un par personnage. Balisez chacun dans le prompt pour que le modèle sache quelle voix dit quelle réplique. La référence fixe le timbre. Le prompt fixe le jeu.
| Ce que vous dirigez | Comment l'écrire |
|---|---|
| Émotion | (référence 2 ; voix blessée, qui retient ses larmes) |
| Style | (référence 1 ; ton sec, sobre, légèrement amusé) |
| Débit | (référence 3 ; débit lent, longues pauses entre les phrases) |
| Sons sans parole | (référence 1 ; un soupir avant la réplique, un petit rire après) |
Utilisez des enregistrements propres d'une voix dont vous avez les droits. La voix d'une personne réelle demande son accord.
Doubler et traduire une vidéo avec Seed Audio 1.5
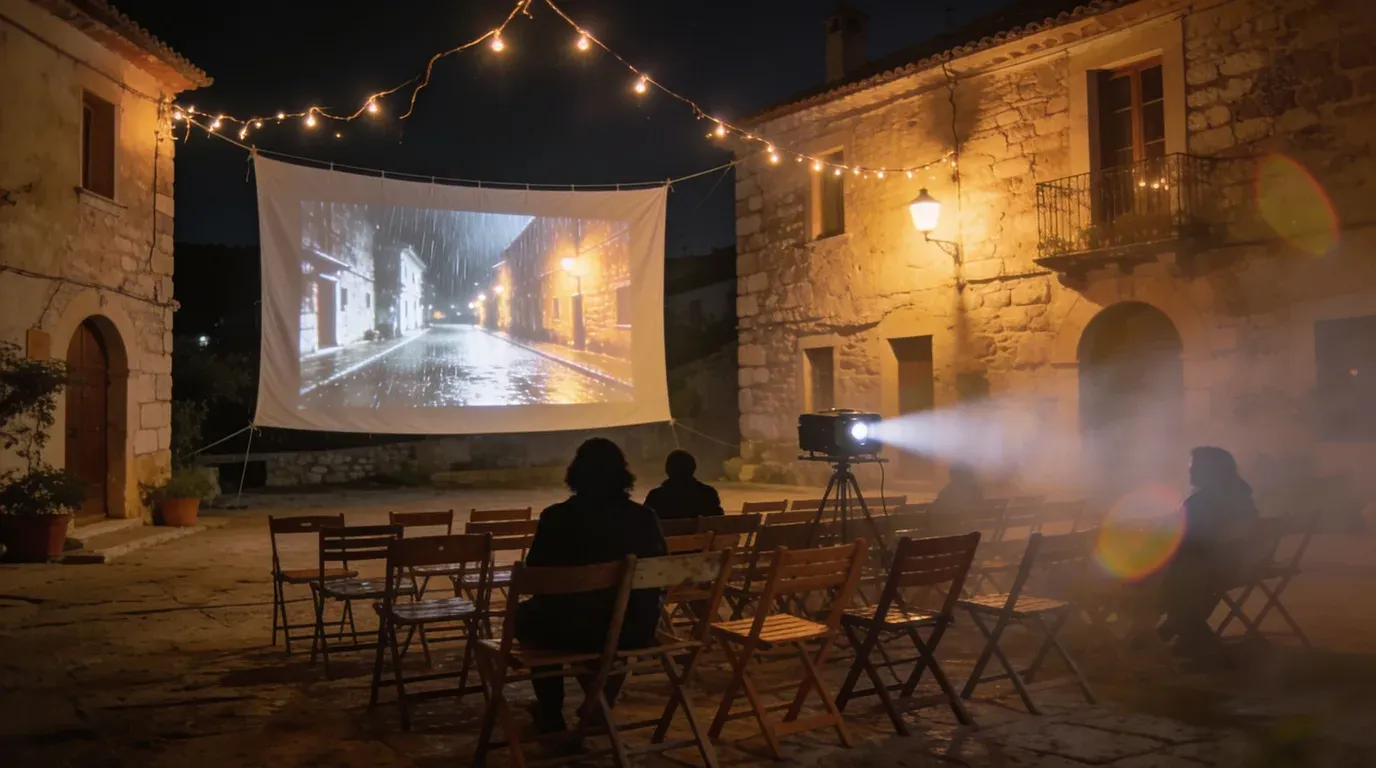
Donnez une vidéo à Seed Audio 1.5 : il écrit la voix off, la musique, les effets et l'ambiance en suivant l'action. Le contexte est tenu sur tout le clip. Pour une traduction, il remplace la langue parlée et garde les effets sonores et la musique d'origine. Pour une version française (VF), cela veut dire que la musique et les effets d'origine restent en place.
- Décrivez la voix de chaque intervenant, ou ajoutez une référence, pour que le doublage garde la même distribution dans toutes les langues.
- Dites ce qu'il faut garder : « gardez la musique et les effets d'origine, remplacez uniquement les dialogues ».
- Faites vérifier la prononciation, le sens et la formulation par une personne qui maîtrise la langue avant de publier.
Aujourd'hui sur Morphic, le doublage vidéo IA traduit un clip et lui donne une nouvelle voix. Le tutoriel doublage et localisation couvre les sous-titres, le lip sync et le montage final.
Traduisez les dialogues en français. Gardez la musique et les effets sonores d'origine. Narration : voix chaleureuse et détendue, même débit que la source.
Les pistes séparées de Seed Audio 1.5
Seed Audio 1.0 renvoyait un seul fichier mixé. Seed Audio 1.5 renvoie dialogues, ambiance, effets et musique sur des pistes séparées, et peut même séparer les dialogues voix par voix. Lancez la lecture pour écouter une scène d'orage, puis coupez ou isolez n'importe quelle piste pendant qu'elle tourne. Chaque voix a sa propre ligne.
| Au montage | Ce que permettent les pistes séparées |
|---|---|
| Niveau | Baisser la musique sous une réplique sans toucher aux voix |
| Coupure | Retirer les effets pour un montage plus calme, ou les dialogues pour un fond de bande-annonce |
| Remplacement | Changer la réplique d'un personnage ou un seul repère, et garder le reste de la scène |
| Réutilisation | Poser la même ambiance sous la scène suivante pour que le lieu sonne de façon continue |
Seed Audio 1.5 ou Seed Audio 1.0 : ce qui change
La page Seed Audio 1.0 de ByteDance citait comme prochaines étapes l'entrée vidéo, des audios plus longs et la sortie multipiste. Seed Audio 1.5 apporte les trois, d'après la fiche préliminaire listée sur Segmind.
| Seed Audio 1.0 | Seed Audio 1.5 | |
|---|---|---|
| Durée par génération | 2 minutes | 6 minutes |
| Voix de référence | 3 | 6 |
| Langues | 20 | 30 |
| Entrées | Texte, audios de référence, une image | Ajoute la vidéo |
| Sortie | Une piste mixée | Dialogues, ambiance, effets et musique séparés |
| Timestamps | Répliques | Répliques, effets et repères musicaux |
| Chansons avec paroles | Non | Oui |
La plupart des prompts Seed Audio 1.0 se transposent tels quels. Pour le détail complet des prompts 1.0, consultez le guide Seed Audio 1.0.
Questions fréquentes
Seed Audio 1.5 arrive bientôt. ByteDance a présenté ses fonctionnalités à des partenaires, mais n'a pas encore ouvert l'accès au public. En attendant, Seed Audio 1.0 est disponible sur Morphic.
Il arrive bientôt sur Morphic. Dès aujourd'hui, vous pouvez construire des scènes complètes avec Seed Audio 1.0, ainsi qu'avec ElevenLabs, Lyria et les autres modèles audio sur le même Canvas.
Oui. La structure scène, voix, réplique et effet reste la même. Pour profiter des nouveautés, ajoutez une vidéo, davantage de voix de référence, des timestamps sur les effets et la musique, ou demandez des pistes séparées.
Écrivez les répliques dans la langue à faire entendre, donc en français pour une VF. Les indications de scène et de voix peuvent rester en anglais si c'est plus simple. Gardez en revanche chaque réplique dans sa langue cible, et faites relire le résultat par une personne qui la maîtrise. Pour la traduction d'une vidéo, le modèle remplace la langue parlée et garde les effets et la musique d'origine.
Seulement avec son accord. Les limites de ByteDance bloquent l'imitation reconnaissable de la voix d'une personne réelle sans consentement, ainsi que les contenus protégés et les paroles existantes. Les extraits de référence doivent être des enregistrements que vous avez le droit d'utiliser.