Gemini Omni
par Google DeepMind
Le premier modèle IA any‑to‑any de Google.
Texte, images, audio et vidéo en entrée.
Texte, images, audio et vidéo en sortie.
Fonctionnalités clés
Spécifications techniques
Omni Flash
Premier modèle de la famille Gemini Omni de Google
Video
Sortie image et audio prévues dans la feuille de route Gemini Omni
Up to 10s
Plans Flash limités à 10 secondes au lancement pour élargir l'accès
720p
Gemini Omni Flash produit de la vidéo en 720p
Text, image, audio, video
Toute combinaison dans un seul prompt Gemini Omni
Natif
Audio synchronisé généré avec chaque clip ; voix via les Avatars
SynthID
Filigrane imperceptible de provenance IA sur chaque sortie Gemini Omni
Google DeepMind
Positionnement comme successeur de Veo pour la création vidéo any-to-any
Cas d'utilisation
Storyboard multi-entrées
Déposez une image de personnage, une photo de lieu, un repère musical et une ligne d'action ; le modèle assemble le plan en un coup.
Édition vidéo conversationnelle
Modifiez un clip en langage naturel : garde-robe, arrière-plan, éclairage, timing d'un beat. Le reste du plan reste stable.
Vidéo marketing
Montages pub qui respectent la marque, la forme du produit et le texte à l'écran. Combinez photo, voix off et brief décor.
Explicatifs éducatifs
Visualisez des concepts de science, d'histoire ou d'ingénierie avec physique et raisonnement intégrés, sans perdre en clarté.
Vidéos d'avatar et de présentateur
Portrait + référence vocale : un présentateur identique sur plusieurs shorts, idéal pour formations, walkthroughs et clips sociaux.
Shorts sociaux
Clips de 10 s calés pour YouTube Shorts, Reels et TikTok. Générez des variations par chat, publiez celle qui fonctionne.
Exemples de prompts
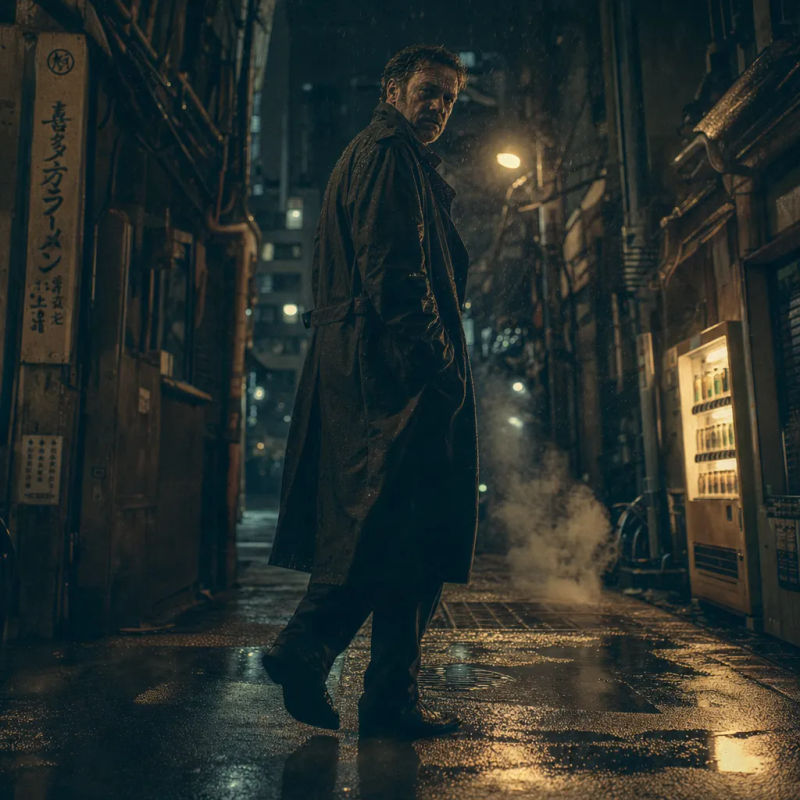
Noir cinématographique
Détective dans une ruelle de Tokyo détrempée, lampadaires au sodium, noir teal-ambre
Edit prompt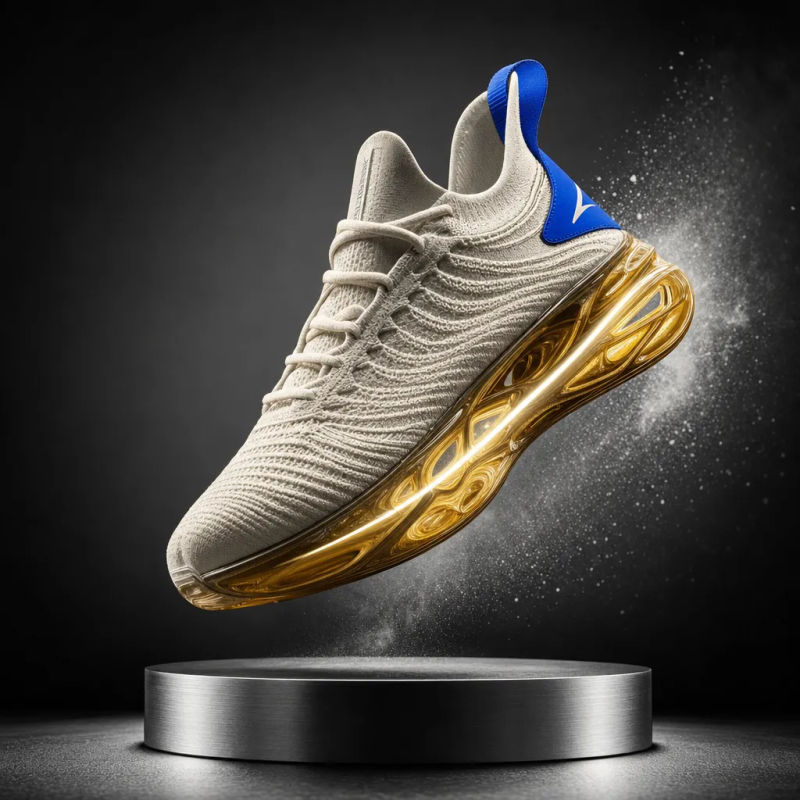
Lancement produit
Basket avant-gardiste au-dessus d'un socle en titane, lumière clé dure, ambiance de lancement
Edit prompt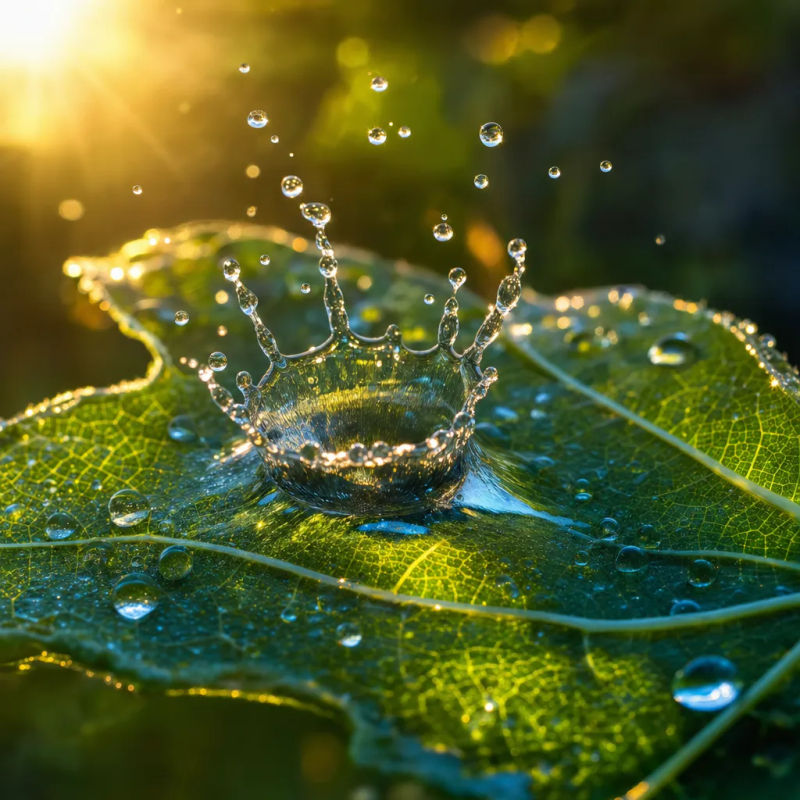
Explicatif nature
Goutte figée en couronne cristalline sur une feuille de rosée, macro à contre-jour
Edit prompt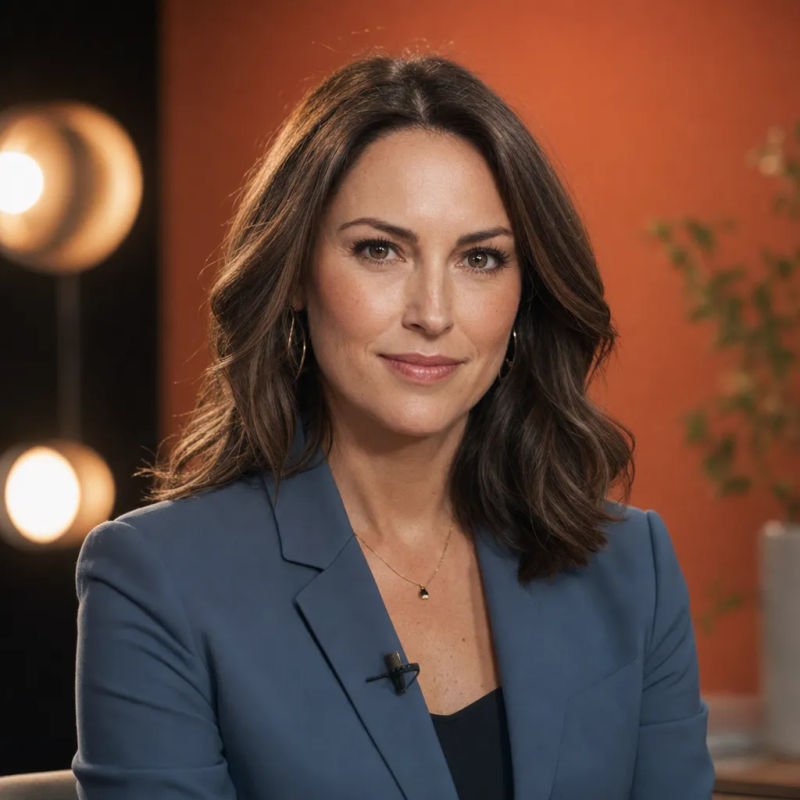
Présentateur avatar
Présentatrice posée face à l'objectif, éclairage trois points chaleureux, bokeh 85 mm
Edit prompt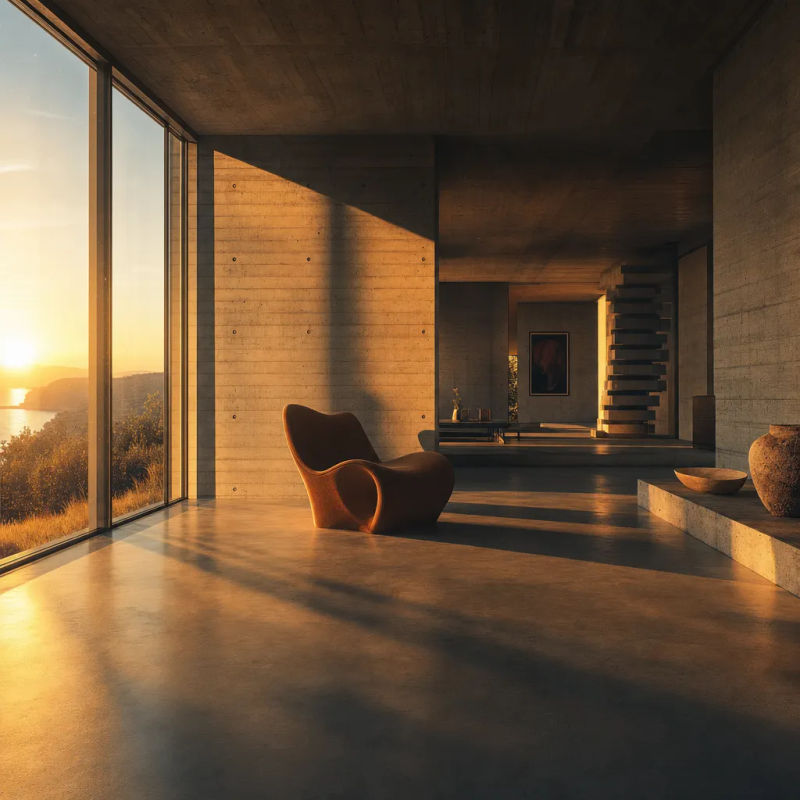
Visite architecturale
Lumière dorée dans une villa en béton brutaliste, longues ombres, poussières en suspension
Edit prompt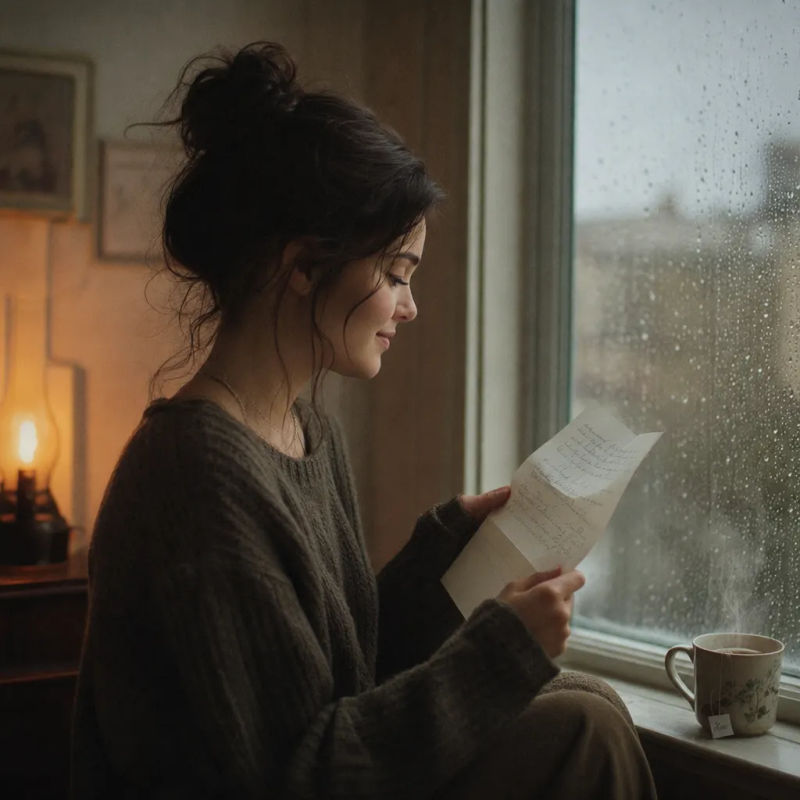
Beat narratif
Femme lisant une lettre près d'une fenêtre pluvieuse, l'inquiétude cédant au soulagement
Edit promptAperçu
Gemini Omni est le premier modèle multimodal any-to-any de Google, annoncé à Google I/O 2026 le 19 mai 2026. La première version, Gemini Omni Flash, accepte le texte, les images, l'audio et la vidéo dans un seul prompt et produit une seule vidéo, avec édition conversationnelle, cohérence des personnages, physique réaliste et filigrane SynthID sur chaque clip.
Ce qui distingue Gemini Omni
Plutôt que d'assembler les modalités, Gemini Omni raisonne à travers elles. Un prompt qui inclut une référence de portrait, une photo de lieu, un échantillon de voix et une ligne d'action donne un plan unique reflétant chaque entrée d'un seul coup. Les prompts de suivi modifient cette même scène, pas une nouvelle, de sorte que personnages, éclairage et continuité tiennent d'un tour à l'autre.
Gemini Omni sur Morphic
Sur Morphic, Gemini Omni se trouve dans le sélecteur de modèles vidéo, aux côtés de Veo 3.1, Seedance 2.0, Kling et du reste du catalogue vidéo. Passez la barre de prompt en mode Vidéo, choisissez Gemini Omni, joignez des références dans n'importe quelle combinaison, puis affinez la même scène à travers les prompts suivants.
Tarifs simples
Commencez gratuitement dès aujourd'hui, avec la possibilité de mettre à niveau ou d'annuler à tout moment.
Basic
1100 mensuel crédits
1 utilisateur uniquement
Tous les modèles
Workflows
Standard
3625 mensuel crédits
1 utilisateur uniquement
Tous les modèles
Workflows
Pro
6350 partagé mensuel crédits
1 utilisateur
Tous les modèles
Workflows
Pro Max
24650 partagé mensuel crédits
1 utilisateur
Tous les modèles
Workflows
Enterprise
Pour des limites plus élevées
Personnalisé
conditions de tarification et de facturation

Free
Pour expérimenter
$0
gratuit pour toujours
Questions fréquentes
ChatGPT Images 2.5
OpenAI
Le modèle d'image d'OpenAI, sorti en septembre 2026. Plus de détail, des retouches ciblées, plus de vitesse.
Lyria 3.5
Google DeepMind
Le meilleur modèle musical de Google. Des chansons entières, voix et paroles.
MiniMax H3 Max Turbo
fal.ai
Le palier rapide du H3 signé fal. Deux fois plus vite, rendu quasi égal.
Inworld TTS 2
Inworld
95 voix, plus de 100 langues. La voix part en moins d’une seconde.