Seed Audio 1.5는 ByteDance의 차세대 전체 장면 오디오 모델로, Morphic에는 곧 들어옵니다. 프롬프트 하나로 대사, 음악, 앰비언스, 음향 효과가 각각 별도 트랙으로 최대 6분까지 나옵니다. 유튜브 내레이션이나 숏폼 더빙처럼 소리를 나눠 다뤄야 하는 작업에 맞는 구성입니다. 이 가이드는 프롬프트 쓰는 법을 다룹니다. 장면 프롬프트를 지금 바로 써 보려면 Seed Audio 1.5 AI 오디오 생성기를 여세요.
Seed Audio 1.5 프롬프트의 구성
청취자가 듣는 순서대로 장면을 쓰세요. 어디에 있는지, 누가 말하는지, 무슨 말을 하는지, 주변에서 무슨 일이 일어나는지 순서입니다. 이야기를 먼저 쓰고 소리 목록은 뒤에 둡니다.
| 구성 | 쓸 내용 | 예시 |
|---|---|---|
| 장면 | 장소, 시간, 날씨, 공간 크기 | [밤. 텅 빈 기차역 승강장, 지붕에 떨어지는 빗소리.] |
| 목소리 | 이름, 나이, 억양, 감정, 속도 | 마라(30대, 차분하고 지친 목소리) |
| 대사 | 정확한 말, 따옴표 안에 | “막차가 끊겼어.” |
| 음향 효과 | 소리의 출처와 움직임 | [젖은 콘크리트 위의 발소리, 점점 멀어진다.] |
| 음악 | 장르, 악기, 분위기, 크기 | [낮은 신스 패드가 전체를 받친다.] |
| 타이밍 | 중요한 지점에 타임스탬프 | [0:06] 발소리가 시작된다. |
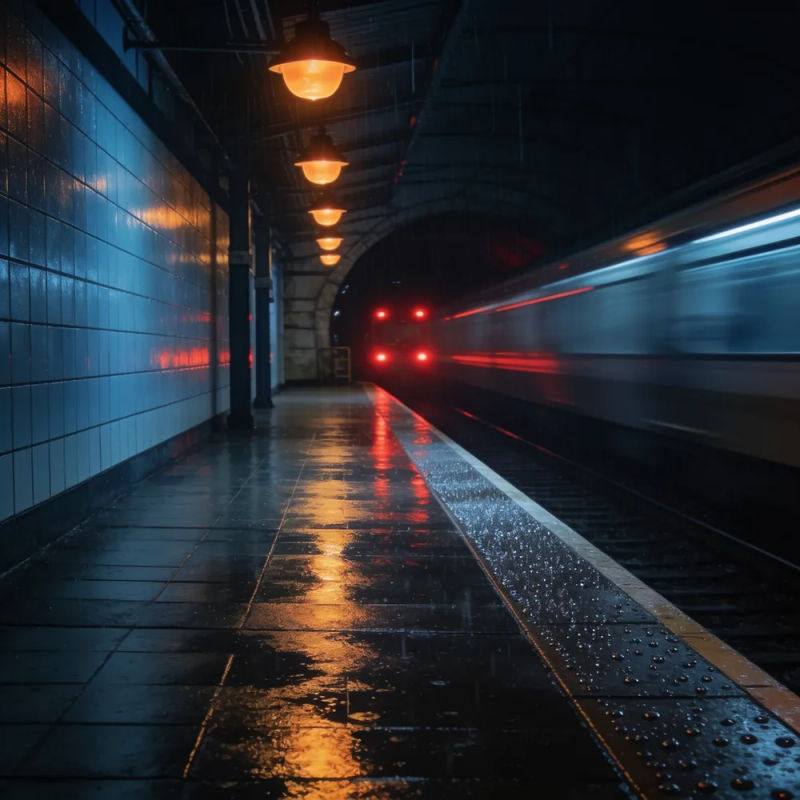
Seed Audio 1.5는 아직 나오지 않았습니다. 그래서 이 샘플은 Morphic에서 ElevenLabs의 목소리와 음향 효과, Lyria 음악으로 만들어 각 프롬프트에 맞게 믹싱했습니다.
Seed Audio 1.5 입력 모드 4가지
모든 모드는 텍스트 프롬프트에서 시작합니다. 여기에 무엇을 더하느냐에 따라 모델이 얼마나 지어내고 얼마나 따라가는지가 달라집니다.
| 모드 | 더하는 것 | 잘 맞는 용도 |
|---|---|---|
| 텍스트 | 없음. 프롬프트가 모든 목소리와 소리를 설명 | 첫 초안, 광고, 사운드 베드 |
| 텍스트 + 오디오 | 목소리용 참조 클립 최대 6개 | 고정 출연진, 이미 쓰는 내레이터 |
| 텍스트 + 영상 | 모델이 보는 영상 클립 | 더빙, 편집본에 음악 얹기, 화면에 맞춘 사운드 디자인 |
| 텍스트 + 오디오 + 영상 | 영상에 목소리 참조까지 | 에피소드가 이어져도 출연진을 고정한 더빙 |
Seed Audio 1.5 타임스탬프
Seed Audio 1.0은 [5.5s:8.0s]처럼 대사에 시간 구간을 줄 수 있었습니다. Seed Audio 1.5는 이를 음향 효과와 음악 큐까지 넓혔습니다. 문소리, 스팅, 고조되는 음악이 모델이 짐작한 곳이 아니라 지정한 곳에 떨어집니다.
- 화면에 맞아야 하는 순간만 시간을 지정하세요. 컷에 맞는 대사, 타격에 맞는 충격음, 공개 장면에 맞는 고조 같은 것들입니다.
- 나머지는 지정하지 마세요. 룸톤과 배경 음악은 모델이 배치할 때 더 자연스럽습니다.
- 타임스탬프는 순서대로 쓰고, 대사 사이에 여유를 두어 말이 우연히 겹치지 않게 하세요.
[0:00] 작은 극장 안, 관객의 웅성거림. [0:04] 조명이 딸깍 꺼진다. [0:05] 진행자(따뜻하고 낮은 목소리): “여러분, 환영합니다.” [0:09] 피아노 화음이 한 번 울린다.
Seed Audio 1.5 목소리 참조
인물마다 참조 클립을 하나씩, 최대 6개까지 올리고 프롬프트에서 각각 태그하세요. 어느 목소리가 어느 대사를 말하는지 모델이 알 수 있습니다. 참조는 목소리의 음색을 정하고, 프롬프트는 연기를 정합니다.
| 연출할 것 | 이렇게 쓰세요 |
|---|---|
| 감정 | (참조 2; 상처받아 눈물을 참는 목소리) |
| 스타일 | (참조 1; 건조하고 담담하게, 살짝 재미있다는 듯) |
| 속도 | (참조 3; 느리게, 문장 사이에 긴 쉼) |
| 말 이외의 소리 | (참조 1; 대사 전에 한숨, 대사 뒤에 짧은 웃음) |
잡음이 적은 깨끗한 녹음, 그리고 사용 권리가 있는 목소리만 쓰세요. 실존 인물의 목소리는 본인의 허락이 있어야 합니다.
Seed Audio 1.5로 영상 더빙하고 번역하기
Seed Audio 1.5에 영상을 주면 화면의 움직임을 따라가는 보이스오버, 음악, 효과음, 앰비언스를 써 줍니다. 클립 전체의 맥락도 유지합니다. 번역할 때는 말하는 언어만 바꾸고 원래의 효과음과 음악은 그대로 둡니다.
- 화자마다 목소리를 설명하거나 참조를 추가하세요. 어느 언어로 바꿔도 같은 출연진이 유지됩니다.
- 남길 것을 말하세요. “원래 음악과 효과음은 유지하고 대사만 교체”처럼 씁니다.
- 공개 전에 해당 언어를 잘하는 사람이 발음과 뜻, 말투를 확인하게 하세요.
지금 Morphic에서는 AI 영상 더빙으로 클립을 번역하고 새 목소리를 입힐 수 있습니다. 자막, Lip Sync, 최종 편집은 더빙과 현지화 가이드에서 다룹니다.
Seed Audio 1.5 개별 트랙
Seed Audio 1.0은 믹싱된 파일 하나를 돌려줬습니다. Seed Audio 1.5는 대사, 앰비언스, 효과음, 음악을 별도 트랙으로 돌려주고, 대사는 목소리별로도 나눌 수 있습니다. 재생을 누르면 폭풍 장면 하나를 들을 수 있습니다. 재생 중에 트랙을 음소거하거나 솔로로 들어 보세요. 목소리마다 자기 레인이 있습니다.
| 편집에서 | 트랙을 나누면 할 수 있는 일 |
|---|---|
| 음량 | 목소리는 건드리지 않고 대사 밑의 음악만 줄이기 |
| 음소거 | 조용한 컷을 위해 효과음을, 예고편 베드를 위해 대사를 빼기 |
| 교체 | 한 인물의 대사나 큐 하나만 바꾸고 장면의 나머지는 유지 |
| 재사용 | 같은 앰비언스를 다음 장면에 깔아 장소의 소리를 이어 가기 |
Seed Audio 1.5와 Seed Audio 1.0, 달라진 점
ByteDance의 Seed Audio 1.0 페이지는 영상 입력, 더 긴 오디오, 멀티트랙 출력을 다음 과제로 꼽았습니다. Segmind에 올라온 사전 공개 브리프에 따르면 Seed Audio 1.5는 이 세 가지를 모두 갖췄습니다.
| Seed Audio 1.0 | Seed Audio 1.5 | |
|---|---|---|
| 한 번에 생성하는 길이 | 2분 | 6분 |
| 목소리 참조 | 3개 | 6개 |
| 언어 | 20개 | 30개 |
| 입력 | 텍스트, 오디오 참조, 이미지 1장 | 영상 추가 |
| 출력 | 믹싱된 트랙 하나 | 대사, 앰비언스, 효과음, 음악을 각각 분리 |
| 타임스탬프 | 대사 | 대사, 효과음, 음악 큐 |
| 가사 있는 노래 | 불가 | 가능 |
Seed Audio 1.0 프롬프트는 대부분 그대로 쓸 수 있습니다. 1.0 프롬프트를 자세히 보려면 Seed Audio 1.0 가이드를 참고하세요.
자주 묻는 질문
곧 Morphic에 들어옵니다. 지금은 Seed Audio 1.0으로 전체 장면을 만들 수 있고, 같은 Canvas에서 ElevenLabs, Lyria 같은 다른 오디오 모델도 함께 쓸 수 있습니다.
곧 나옵니다. ByteDance가 파트너에게 기능 구성을 공유했지만 아직 일반 공개는 열지 않았습니다. 그동안 Morphic에서는 Seed Audio 1.0을 쓸 수 있습니다.
본인의 허락이 있을 때만 가능합니다. ByteDance의 제한은 동의 없이 실존 인물의 목소리를 알아볼 수 있게 흉내 내는 것을 막고, 저작물과 기존 가사도 막습니다. 참조 클립은 사용 권리가 있는 녹음이어야 합니다.
네. 장면, 목소리, 대사, 효과음의 구조는 같습니다. 새 기능을 쓰려면 영상, 더 많은 목소리 참조, 효과음과 음악의 타임스탬프를 더하거나 개별 트랙을 요청하세요.
말하게 할 언어로 대사를 쓰세요. 한국어로 말하게 하려면 대사를 한국어로 적습니다. 장면과 목소리 지시는 영어로 써도 되지만, 대사는 목표 언어 그대로 두고 그 언어를 잘하는 사람이 결과를 확인하게 하세요. 지원 언어는 출시 후 목록에서 확인하세요.