Seed Audio 1.5 AI 오디오 생성기

ByteDance의 장면 통합 오디오 모델. 대사, 음악, 효과음을 레이어별로.

모든 오디오 모델

하나의 작업 공간

목소리를 넘어 장면까지

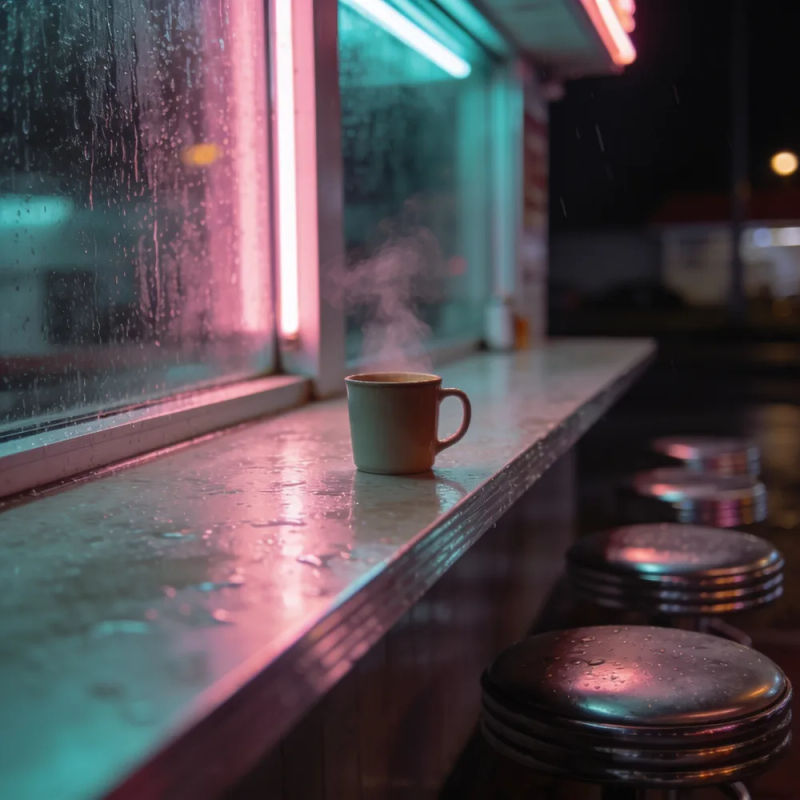
김이 오르는 머그잔 하나와 빗방울 맺힌 창이 있는 심야 식당 카운터
심야 식당
[Diner at 2 a.m., a fridge hums, rain outside.] Waitress (50s, kind): "Coffee's on the house tonight, hon." Driver (tired, grateful): "You're an angel. Long road tonight."
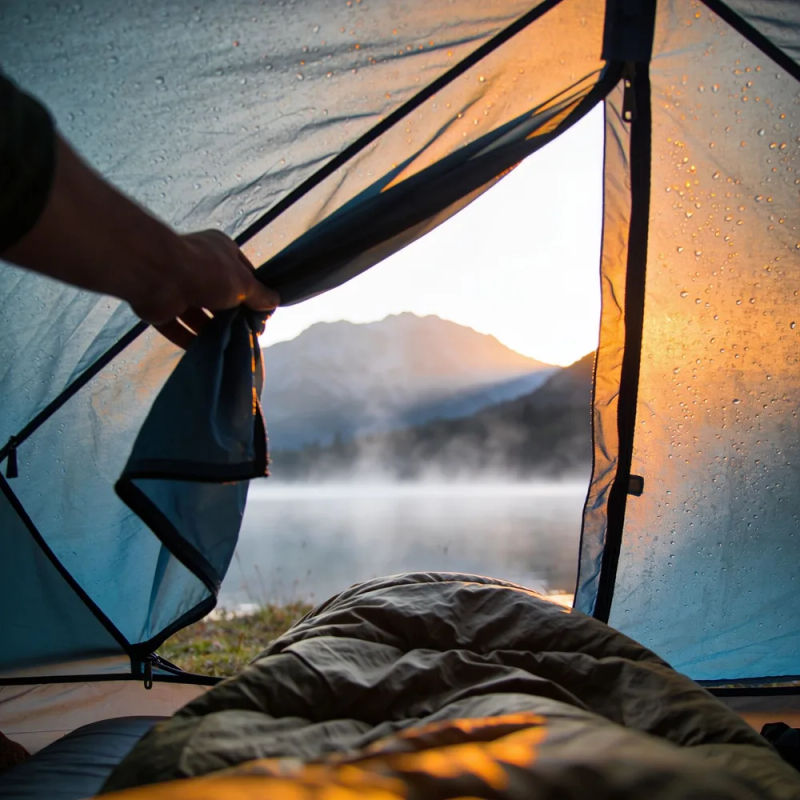
동틀 무렵, 안개 낀 산중 호수를 향해 텐트 문의 지퍼를 여는 손
캠핑 광고
[Warm acoustic guitar builds.] Narrator (warm, smiling): "Weekend plans? Pack light. We've got the tent." [0:08] The music swells and a tent zipper closes.
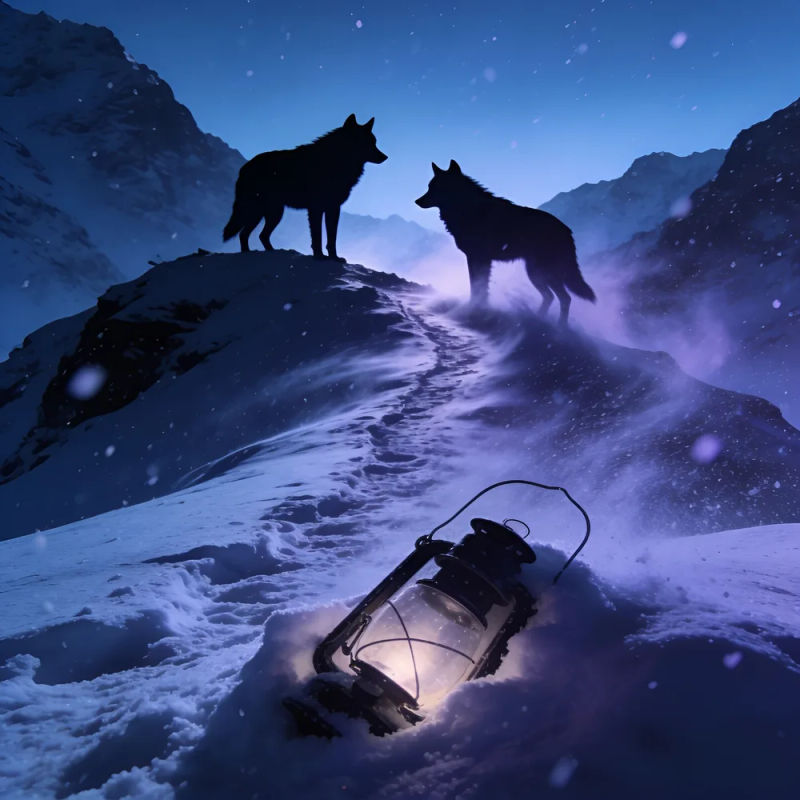
푸른 새벽빛이 감도는 눈 덮인 능선 위의 늑대 두 마리와 눈 속의 랜턴
게임 속 한 장면
[Snowy mountain pass, howling wind, tense low strings.] Scout (urgent whisper): "Wolves. Two of them. Don't move." [0:06] A low growl, close by.
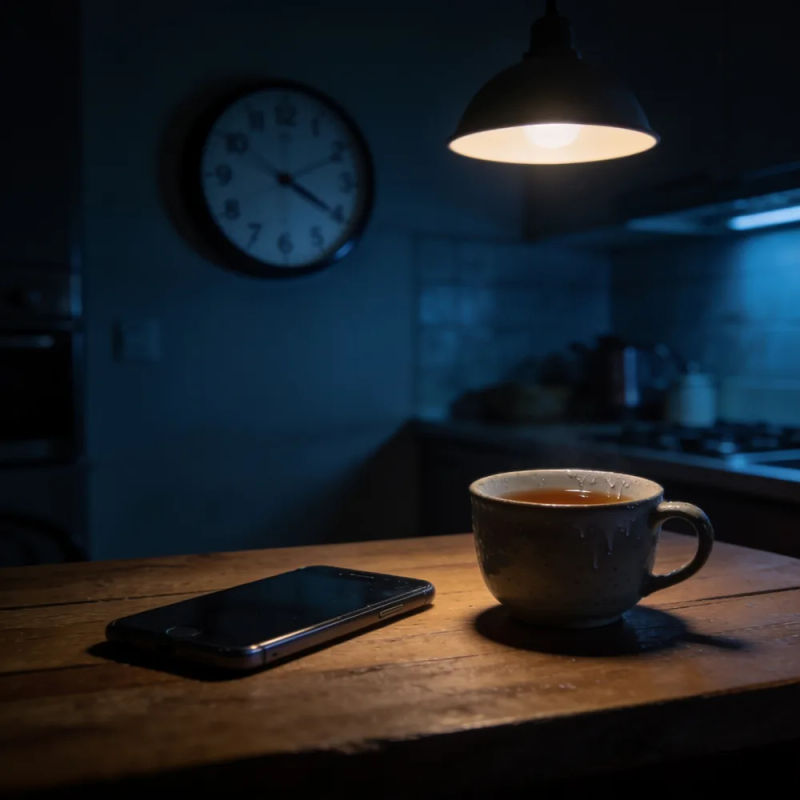
벽시계, 엎어 놓은 휴대폰, 식은 찻잔이 놓인 밤의 어두운 주방
단편 드라마
[Kitchen, late evening, a clock ticks, soft piano.] Mother (quiet, hurt): "You didn't call." Son (defensive, then soft): "I was busy, Mom, I... I know. I'm sorry."
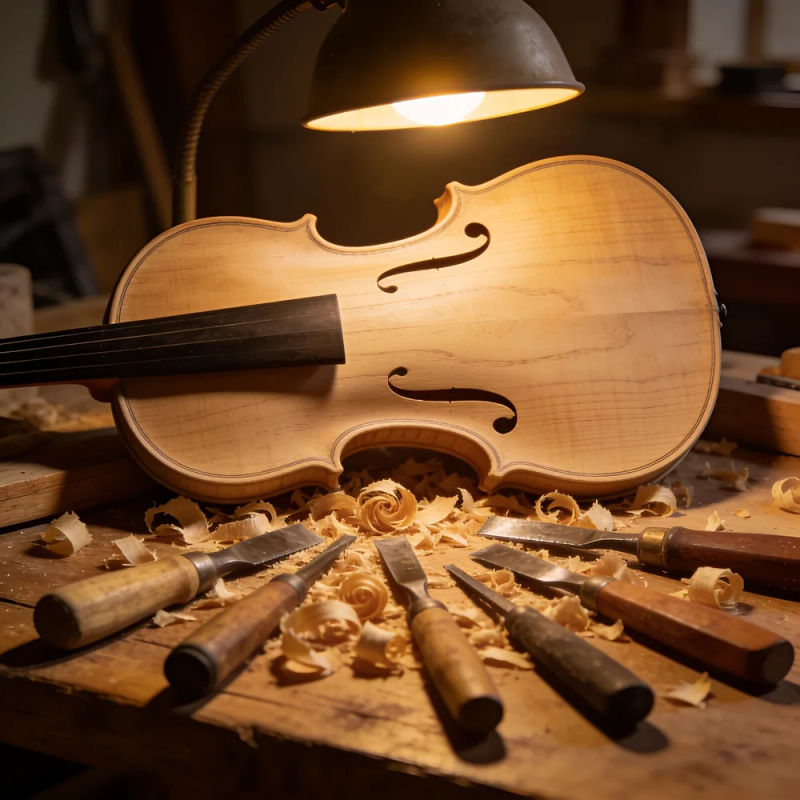
조각 도구와 대팻밥이 놓인 작업대 위의 다 만들지 못한 바이올린 몸통
공예 다큐멘터리
[Workshop at night, a lamp hums, a chisel shaves wood, a solo violin far off.] Narrator (warm, hushed): "Every violin starts as a block of spruce... and a lot of patience."
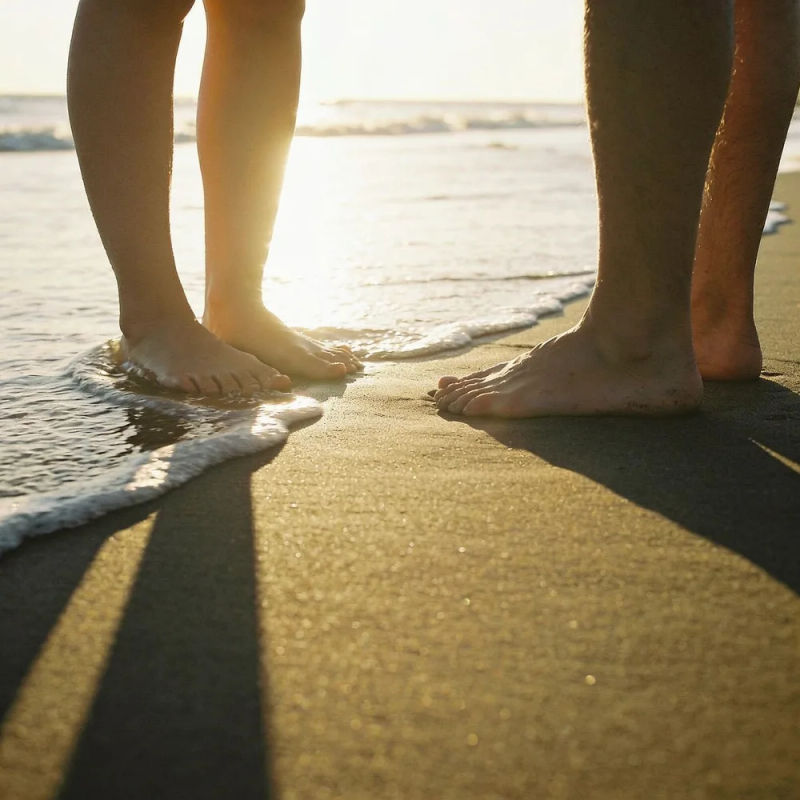
해 질 녘 파도가 빠져나가는 젖은 모래 위의 맨발 두 쌍
브라질 포르투갈어
[Beach at sunset, gentle waves, soft bossa nova guitar.] Narrator (relaxed, warm, Brazilian Portuguese): "O sol já está indo embora... fica mais um pouco."

주요 기능

3단계로 장면 오디오 만들기

  1. 01

    Morphic 열기

    가입하고 자유롭게 흐르는 무한 비주얼 Canvas에서 만들기를 시작하세요.

  2. 02

    장면 쓰기

    장소를 설명하고, 목소리를 정하고, 대사를 쓰세요. 음성 참조나 영상이 있으면 함께 더합니다.

  3. 03

    생성하고 트랙별로 다듬기

    대사, 앰비언스, 효과음, 음악이 따로 돌아옵니다. 한 레이어만 고치고 나머지는 그대로 두세요.

Seed Audio 1.5로 만드는 오디오

프롬프트 하나로 장면 전체

목소리, 공간음, 효과음, 배경 음악이 균형이 잡힌 채 한꺼번에 도착합니다. 카페, 폭풍, 경기장이 침묵 위의 목소리가 아니라 실제 공간처럼 들립니다.
호박색, 은색, 청록색의 반투명한 파형 세 줄이 하나로 합쳐지는 모습

화면을 따라가는 더빙

완성된 컷을 넣으면 Seed Audio 1.5가 움직임에 맞춰 더빙, 음악, 효과음을 씁니다. 대사를 번역하면서 원래의 음악과 효과음은 그대로 둘 수 있습니다.
아래쪽 가장자리에서 파문이 퍼져 나가는, 빛으로 된 직사각형 프레임

편집용 분리 트랙

대사, 앰비언스, 효과음, 음악이 각각 별도 트랙으로 돌아옵니다. 음악 볼륨을 낮추거나 효과음을 끄고, 대사 한 줄만 바꿔도 나머지는 건드리지 않습니다.
호박색, 청록색, 은색, 장밋빛의 빛나는 유리 띠 네 줄이 안개 속에서 따로 떠 있는 모습

6분짜리 장면

드라마 한 장면, 팟캐스트 한 코너, 낭독 한 챕터가 한 번의 생성에 담깁니다. 참조 클립으로 최대 6명의 목소리를 정할 수 있습니다.
느린 파형처럼 깊이 속으로 길게 뻗은 부드러운 빛의 수평선

모두 Morphic에서

완전한 오디오 스택

간단한 가격

오늘 무료로 시작하고 언제든지 업그레이드하거나 취소할 수 있습니다.

Basic

$19/ 월
청구 금액 $0 년

2400 월간 크레딧

1 명 전용

모든 모델

워크플로

Standard

$24/ 월
청구 금액 $0 년

3625 월간 크레딧

1 명 전용

모든 모델

워크플로

Pro

$45/ 월
청구 금액 $0 년

6350 공유 월간 크레딧

1 사용자

+ 최대 4 명 추가 비용으로 추가 가능

모든 모델

워크플로

Max

$170/ 월
청구 금액 $0 년

24650 공유 월간 크레딧

1 사용자

+ 최대 9 명 추가 비용으로 추가 가능

모든 모델

워크플로

Enterprise

더 높은 제한

사용자 정의

가격 및 청구 조건

대용량 크레딧
맞춤형 시트 제한
모든 모델
워크플로
Pricing Gradient

Free

가볍게 사용해보기

$0

영구 무료

최대 20 크레딧
1명 전용
일부 모델
워크플로

자주 묻는 질문

Seed Audio 1.5 AI 오디오 생성기란 무엇인가요?
ByteDance의 Seed Audio 1.5는 장면 전체를 만드는 오디오 모델입니다. 프롬프트 하나로 대사, 음악, 앰비언스, 효과음이 각각 별도 트랙으로 돌아오고, 길이는 최대 6분입니다. 영상을 넣으면 완성된 컷에 소리를 맞춰 더빙과 사운드 디자인까지 할 수 있습니다.
Seed Audio 1.5 AI 오디오 생성기는 무료인가요?
Morphic에는 무료 플랜이 있어 결제 없이 오디오 만들기를 시작할 수 있습니다. Seed Audio 1.5가 Morphic에 들어오면 다른 오디오 모델과 같은 크레딧으로 실행됩니다. 긴 장면에는 유료 플랜에서 크레딧을 더 쓰시면 됩니다.
Seed Audio 1.5는 Morphic에 언제 들어오나요?
Seed Audio 1.5는 곧 출시됩니다. 그전에는 Morphic에서 Seed Audio 1.0으로 장면 전체를 만들 수 있습니다. ElevenLabs와 Lyria도 함께 쓸 수 있습니다. 이 페이지의 샘플은 Morphic에서 ElevenLabs 음성과 효과음, Lyria 음악으로 만들어 장면으로 믹싱한 것입니다.
Seed Audio 1.5로 목소리를 복제할 수 있나요?
권리를 가진 참조 클립이라면 최대 6개까지 올려 장면 속 목소리를 정할 수 있습니다. 다만 ByteDance의 제한 때문에, 실존 인물의 목소리는 본인 허락 없이 흉내 낼 수 없습니다.
유튜브 영상이나 숏폼에 더빙과 효과음을 넣을 수 있나요?
네. 영상을 더하면 모델이 화면 속 움직임에 맞춰 내레이션, 음악, 효과음, 앰비언스를 만들어 줍니다. 대사를 다른 언어로 옮기면서 원래의 효과음과 음악은 그대로 둘 수도 있습니다. 게시하기 전에 그 언어를 잘하는 사람이 결과를 한 번 들어 보세요.
트랙 분리는 어떻게 쓰나요?
Seed Audio 1.5는 대사, 앰비언스, 효과음, 음악을 하나로 섞지 않고 각각의 트랙으로 돌려줍니다. 대사는 목소리별로 나눌 수도 있습니다. 한 레이어의 볼륨을 낮추거나 끄고, 대사 한 줄만 바꿔도 나머지 장면은 다시 만들지 않아도 됩니다.
Seed Audio 1.5는 한 번에 얼마나 길게 만들 수 있나요?
한 번의 생성으로 최대 6분입니다. Seed Audio 1.0의 2분 제한보다 세 배 깁니다. 드라마 한 장면, 팟캐스트 한 코너, 낭독 한 챕터를 한 번에 끝낼 수 있습니다.
Seed Audio 1.5를 온라인으로 쓸 수 있나요?
네. 모든 작업이 Morphic의 브라우저에서 돌아가고 설치할 것이 없습니다. 장면을 쓰고 생성하면 오디오가 이미지, 영상과 나란히 Canvas에 올라옵니다.

이런 것도 좋아하실 거예요