OmniHuman 2.0
ByteDance 제공
ByteDance의 오디오 기반 인물 영상 모델.
사진 한 장, 음성 하나, 5분 원테이크.
주요 기능
사양은 BytePlus가 2026년 10월 15일 출시 글에서 밝힌 수치입니다. OmniHuman 2.0은 아직 Morphic에 없어서, 이 페이지의 클립은 사진 한 장과 오디오 하나로 최대 5분짜리 토킹 영상을 지금 만들 수 있는 Veed Fabric으로 Morphic에서 제작했습니다.
기술 사양
5분
끊김 없는 한 번의 샷, BytePlus 기준
60초
2.0 이전의 단일 샷 상한
사진 + 오디오
출연자 이미지 1장과 트랙 1개
모든 트랙
음성, 음악, 대화
활용 사례
강의와 수업
수업 한 편을 한 번에 만듭니다. 강사의 모습이 4분째에도 1분째와 같아서 이어 붙일 일이 없습니다.
설명 영상과 사용법 영상
내레이션을 먼저 녹음하거나 생성한 뒤 사진 한 장이 전달하게 하세요. 시청자를 붙잡는 쉼과 강조가 살아 있습니다.
음악 공연 클립
노래 트랙을 넣으면 얼굴이 가사만이 아니라 긴 음과 숨, 노래의 감정까지 담아냅니다.
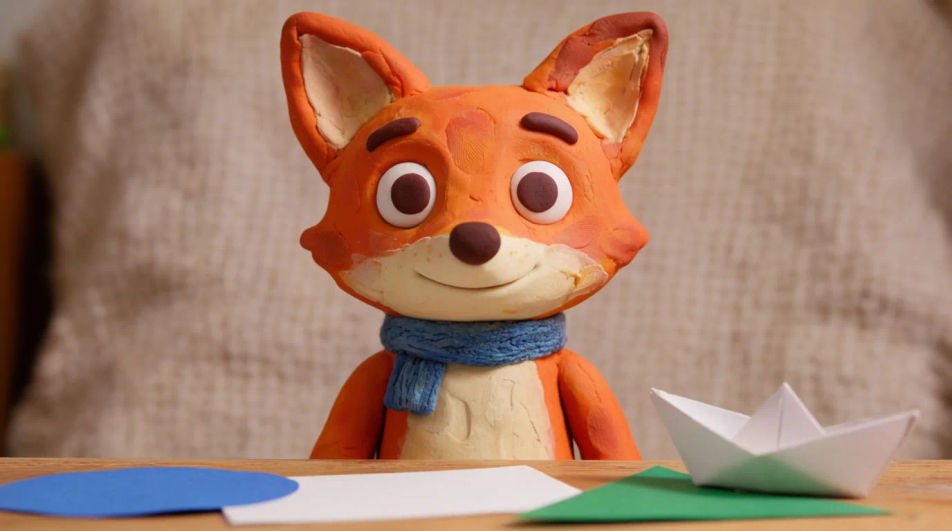
마스코트와 캐릭터
브랜드 마스코트, 클레이 캐릭터, 일러스트 주인공에 목소리를 입혀 광고, 어린이 콘텐츠, 채널 인트로에 쓰세요.
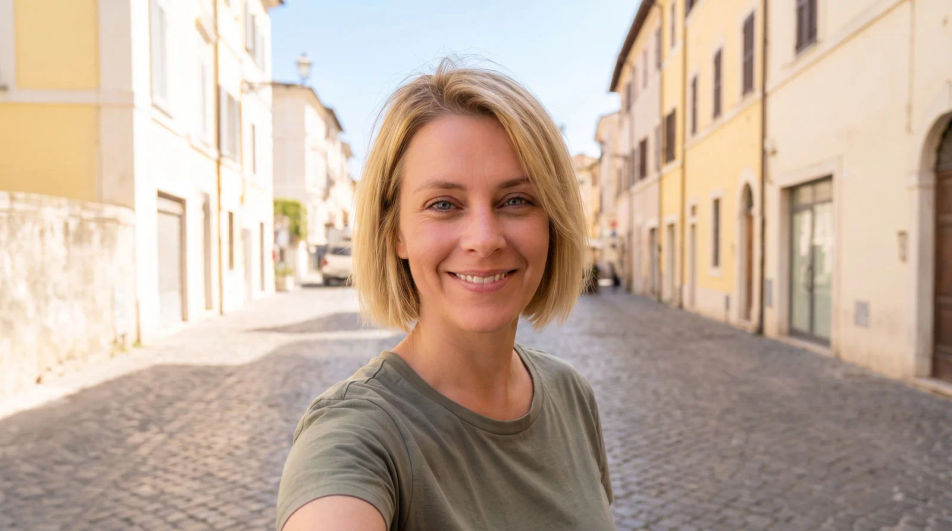
크리에이터와 SNS 영상
셀카 느낌의 사진 한 장과 음성 트랙으로 릴스와 쇼츠용 세로 영상을 만들어 바로 올릴 수 있습니다.
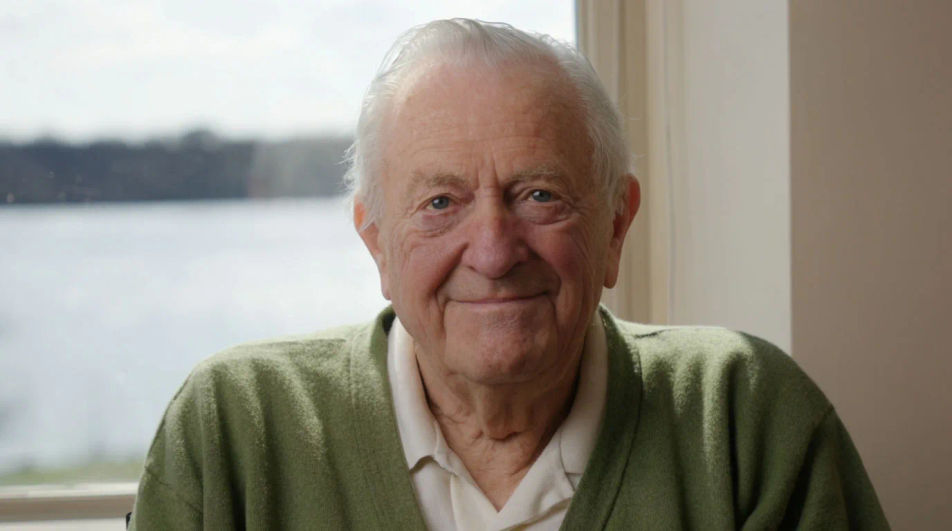
이야기와 팟캐스트
긴 이야기도 조용한 전개부터 마지막 한마디까지 리듬이 유지되며, 출연자가 1분마다 처음 상태로 돌아가지 않습니다.
개요
OmniHuman 2.0은 2026년 10월 15일 BytePlus를 통해 공개된 ByteDance의 오디오 기반 인물 영상 모델입니다. 사진 한 장과 오디오 트랙 하나를 넣으면 그 사람이 트랙을 연기하는 영상이 나옵니다. 입 모양만 맞추지 않고 오디오의 톤, 감정, 단어를 읽습니다. 한 번의 샷은 기존 60초에서 최대 5분으로 늘었고, 이어 붙일 필요도 없습니다 (출처). 유튜브 강의, 릴스와 쇼츠 같은 숏폼, 직접 만든 노래 영상처럼 길게 말하고 노래하는 콘텐츠에 맞는 모델입니다.
OmniHuman 2.0이 다른 점
말하는 사진 모델 대부분은 소리에 맞춰 입만 움직입니다. OmniHuman 2.0은 말하는 방식을 듣습니다. 속삭이는 동화, 코치의 힘찬 구령, 노래에서 길게 끄는 한 음이 같은 종류의 입력에서도 서로 다른 연기로 나옵니다.
한 번에 길게 가는 테이크도 중요합니다. 강의, 이야기, 노래 한 곡이 하나의 샷으로 이어지므로 얼굴, 조명, 배경이 바뀌는 이음매가 없습니다.
Morphic에서 쓰는 OmniHuman 2.0
OmniHuman 2.0은 곧 Morphic에 추가될 예정입니다. 그 전까지는 Veed Fabric이 같은 작업을 합니다. Copilot을 열고 사진과 오디오 트랙을 첨부한 뒤 토킹 영상을 요청하세요. 이 페이지의 모든 클립을 그렇게 만들었습니다. 좋은 결과를 얻는 방법은 OmniHuman 2.0 가이드를 참고하세요.
간단한 가격
오늘 무료로 시작하고 언제든지 업그레이드하거나 취소할 수 있습니다.
Basic
2400 월간 크레딧
1 명 전용
모든 모델
워크플로
Standard
3625 월간 크레딧
1 명 전용
모든 모델
워크플로
Pro
6350 공유 월간 크레딧
1 사용자
모든 모델
워크플로
Max
24650 공유 월간 크레딧
1 사용자
모든 모델
워크플로
Enterprise
더 높은 제한
사용자 정의
가격 및 청구 조건

Free
가볍게 사용해보기
$0
영구 무료
자주 묻는 질문
OmniHuman 2.0 더 알아보기
OmniHuman 2.0의 가이드, 프롬프트, 비교.
다른 모델
Morphic 모델 카탈로그를 더 둘러보세요.
Mirelo SFX 2.0
Mirelo AI
Mirelo의 영상 기반 사운드 모델. 대사는 그대로, 소리는 새로.
Fish Audio Drama 3
Fish Audio
Fish Audio에서 가장 표현력이 풍부한 음성 모델. 단어 하나까지 연기를 지시합니다.
Vidu Q4
Shengshu Technology
Shengshu의 최신 영상 모델. 레퍼런스 이미지 12장과 음성 3개를 한 클립 안에서 일관되게 유지하고, 540p~4K 영상에 오디오까지 만듭니다.
Nano Banana 2.1
Google DeepMind
Google DeepMind의 새 Flash 이미지 모델. 더 나은 디자인, 깔끔한 편집, 안정적인 캐릭터.