Gemini Omni
由 Google DeepMind 提供
Google首款any‑to‑any AI模型。
输入文本、图像、音频、视频,输出文本、图像、音频、视频。
核心功能
技术规格
Omni Flash
Google Gemini Omni系列的首款模型
Video
图像和音频输出已列入Gemini Omni路线图
Up to 10s
Flash片段在发布时上限为10秒,以便扩大可用范围
720p
Gemini Omni Flash 输出 720p 视频
Text, image, audio, video
任意组合可同时出现在一个Gemini Omni Prompt中
原生
每段片段都会生成同步音频;声音通过 Avatars 实现。
SynthID
Gemini Omni每段输出都带有不可见的AI来源水印
Google DeepMind
面向any-to-any视频创作的Veo继任者定位
应用场景
多输入分镜创作
上传一张角色参考图、一张场景照片、一段音乐线索,再加一句剧情概要,让Gemini Omni整合出镜头。通过后续对话在同一个场景上反复迭代。
对话式视频编辑
用自然语言描述要修改的内容,即可对已有片段进行编辑。换装、替换背景、调整光线、调整动作时机。Gemini Omni都会保留镜头其余部分不变。
营销视频
生成贴合品牌色、产品造型与画面文字的广告剪辑。一个Prompt中组合产品照片、配音参考和场景简报,直接产出成片。
教学解说
借助物理与现实世界推理,可视化呈现科学、历史和工程概念。模型在保证科学准确的同时,输出干净、可直接呈现的画面。
虚拟形象与主持人视频
结合一张人物肖像和一段声音参考,Gemini Omni可在多支短视频中输出形象一致的镜前主持人。适用于课程、产品演示和短视频。
社交短视频
10秒以内的片段契合YouTube Shorts、Reels和TikTok节奏。通过对话生成多种变体,不必反复重写Prompt,直接发布效果最好的那一版。
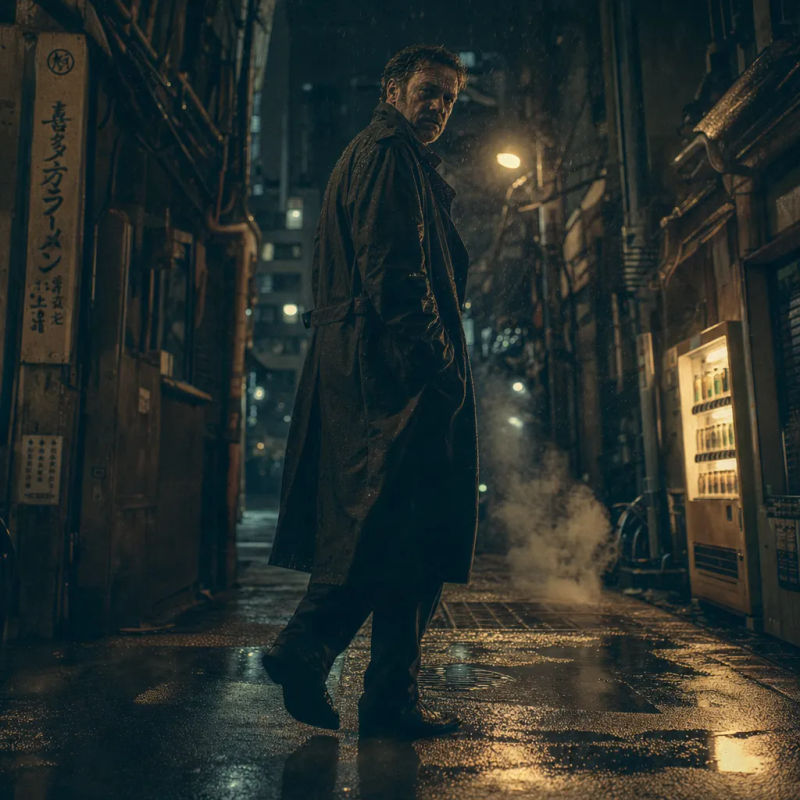
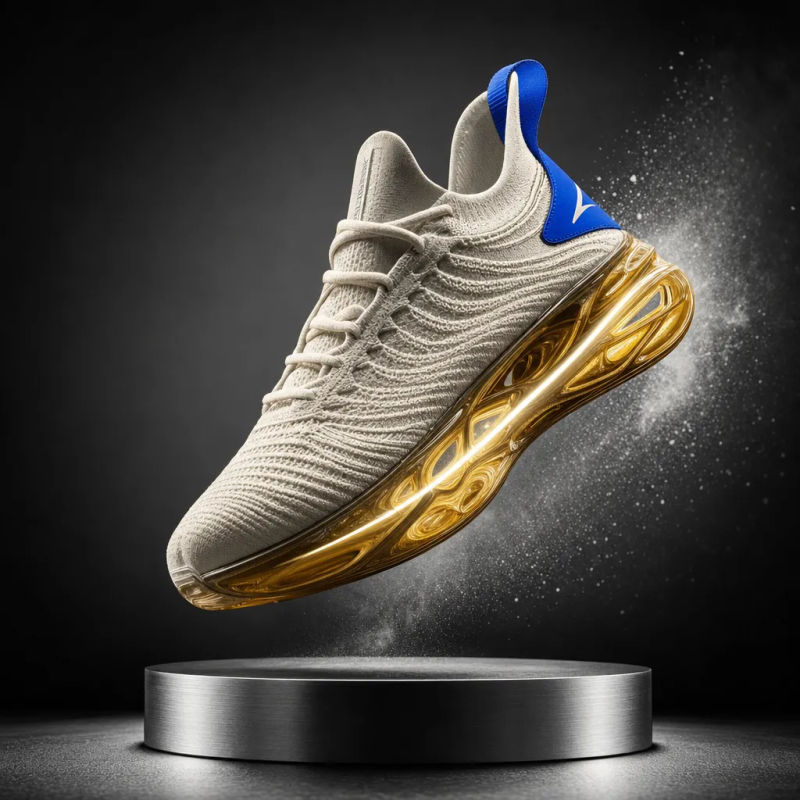
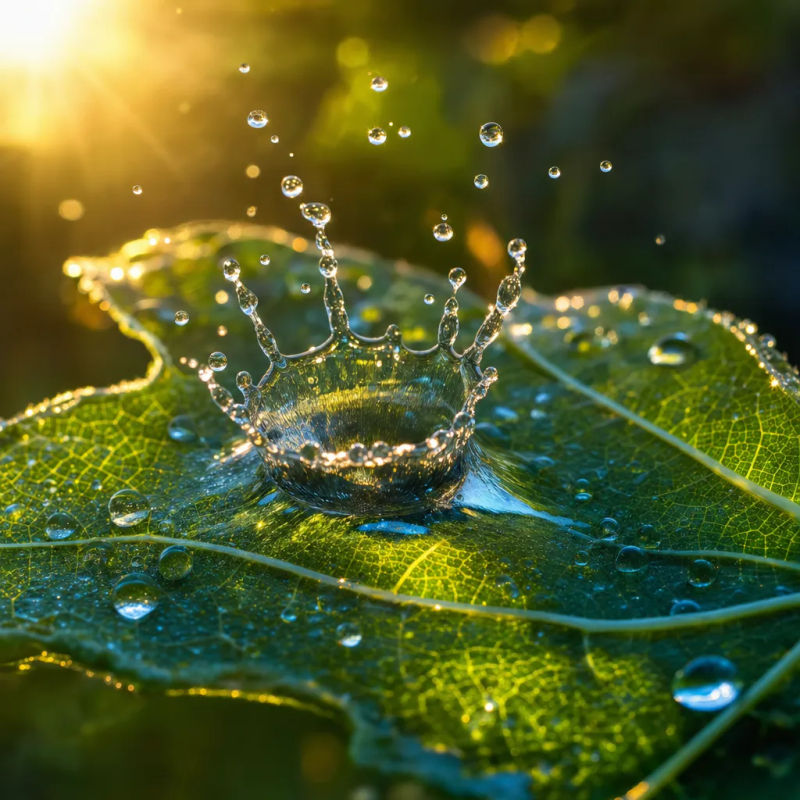
提示词示例
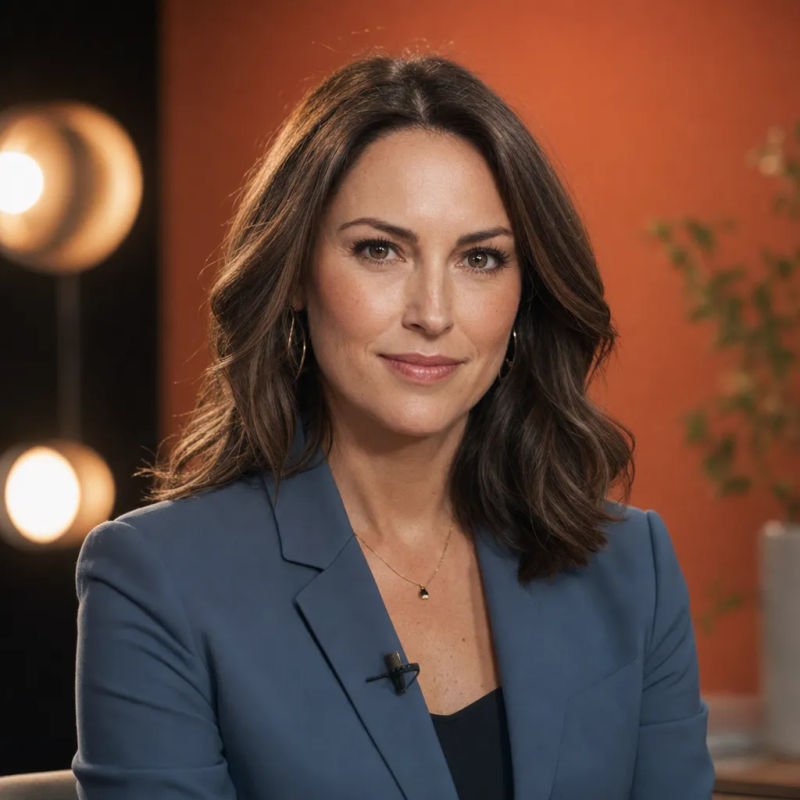
概述
Gemini Omni是Google首款any-to-any多模态模型,于2026年5月19日的Google I/O 2026上发布。首批发布的Gemini Omni Flash在同一个Prompt中接收文本、图像、音频和视频,生成一段视频,并对每段片段提供对话式编辑、角色一致性、精确物理和SynthID水印。
Gemini Omni的不同之处
Gemini Omni不是把不同模态拼接在一起,而是对它们进行整体推理。一个包含人物参考、场景照片、声音样本和一句剧情概要的Prompt,会输出一段同时呈现所有输入要素的镜头。后续Prompt编辑的是同一个场景,而不是新生成一个,因此角色、光线和一致性可以跨多轮稳定保持。
Morphic上的Gemini Omni
在Morphic上,Gemini Omni位于视频模型选择器中,与Veo 3.1、Seedance 2.0、Kling以及完整的视频目录并列。将提示栏切换到视频模式,选择Gemini Omni,按任意组合附加参考素材,并通过后续Prompt持续编辑同一场景。
简单定价
今天就免费开始,随时可以升级或取消。
Basic
1100 每月 信用
1 个用户
所有模型
工作流
Standard
3625 每月 信用
1 个用户
所有模型
工作流
Pro
6350 共享 每月 信用
1 用户
所有模型
工作流
Pro Max
24650 共享 每月 信用
1 用户
所有模型
工作流
Enterprise
更高的限制
自定义
定价和账单条款

Free
供随意体验
$0
永久免费