Seed Audio 1.5
由 ByteDance 提供
字节跳动的全场景音频模型。
即将上线:对白、音乐与音效,分轨输出。
核心功能
Seed Audio 1.5 即将上线 Morphic。本页介绍目前已知的信息,开放后会更新。使用场景图片仅为示意,示例音频由 Morphic 上的其他音频模型制作。
聆听声音的广度
两个人声、走廊的嗡鸣和一层紧张的铺底音色。
一声警告,水滴声,然后大门打开。
一段短小的开场曲,主持人开口时自动压低。
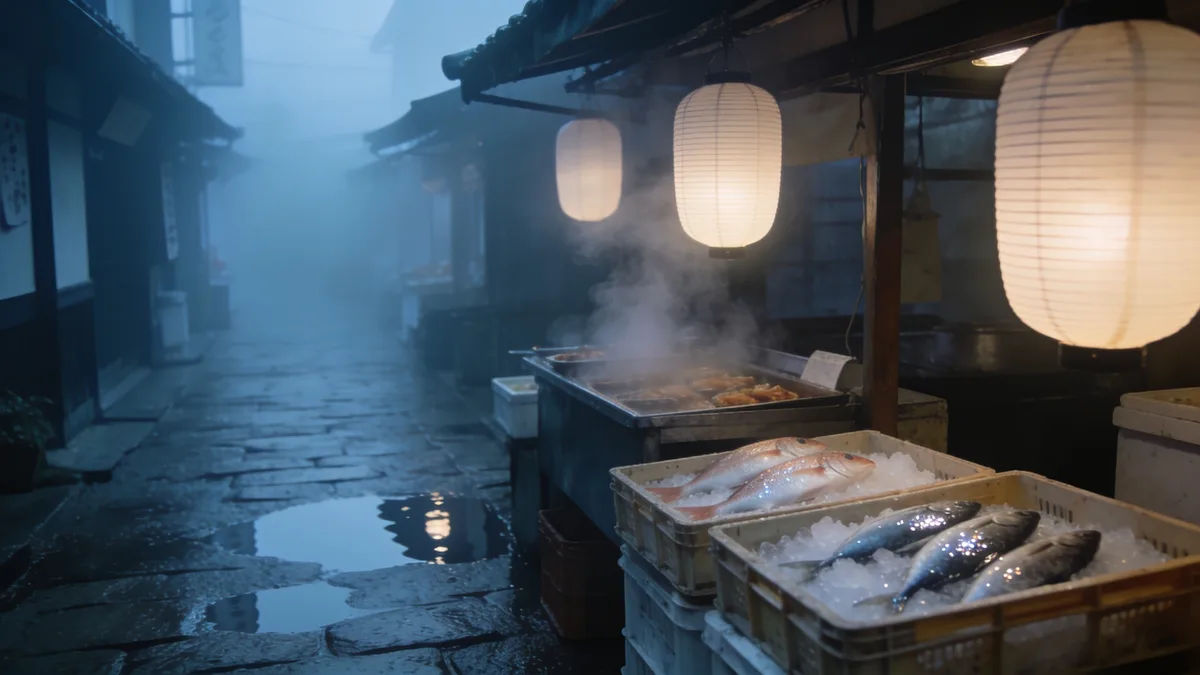
清晨集市上的日语旁白。
技术规格
6 分钟
单次生成长度,Seed Audio 1.0 为 2 分钟
6 段
每次生成可用的参考录音,此前为 3 段
30 种
含西班牙语和葡萄牙语的地区变体
5 种
文本生成音频、参考声音、视频生成音频、视频配音和音轨分离
应用场景
视频出海配音
放入成片,得到贴合画面的配音,原有音效和音乐照常保留。
短剧与系列剧
六分钟足够装下一整场戏,分轨之后改一句台词也不必重新生成。
有声书与广播剧
旁白、角色声音和环境音一起出,一整章里的演员阵容保持不变。
广告与宣传片
口播、音乐起势和音效一次出齐。客户要改,只重生成那一层。
游戏过场
过场动画和预告片需要的角色台词、环境底噪与定时音效,精确到秒。
播客
片头音乐、两位主持人和真实的房间声,每个声音单独成轨,方便剪辑。
提示词示例
概览
Seed Audio 1.5 是字节跳动的全场景音频模型,也是 Seed Audio 1.0 的下一个版本,即将上线 Morphic。一条提示词就能生成对白、音乐、环境音和音效,单次最长六分钟。视频、参考声音和时间码都可以作为指令。
Seed Audio 1.5 有什么不同
整场戏分层返回。对白、环境音、音效和音乐各自成轨,哪句台词不对、哪个音效太响,只改那一层就行。短剧和出海视频常要反复改词,这一点尤其省事。
它还能读取视频,让声音贴合成片的画面。配音和翻译都需要这项能力。
Seed Audio 1.5 上线时间
Seed Audio 1.5 即将上线 Morphic,目前还没有日期。服务方的早期访问因模型更新而暂停,所以它暂时不在 Morphic 的模型列表里。上面列出的是已知功能,开放时间和价格要等正式上线时公布。
现在就能用的 Seed Audio 1.5 替代方案
- **Seed Audio 1.0:**一条提示词同时生成对白、音乐和音效,所有套餐包括免费版都能用。
- **ElevenLabs v4:**富有表现力的语音和多人对白。
- **Lyria:**音乐铺底和短音效。
- **Mirelo SFX 2.0:**给成片配上音效和环境音,并保留原有对白,付费套餐可用。
它们共用一块 Canvas,今天就能分层搭出整场戏。提示词怎么写,请看 Seed Audio 1.5 提示词指南。
简单定价
今天就免费开始,随时可以升级或取消。
Basic
2400 每月 信用
1 个用户
所有模型
工作流
Standard
原为 3625, 现为 4713 每月 信用
1 个用户
所有模型
工作流
Pro
原为 6350, 现为 8255 共享 每月 信用
1 用户
所有模型
工作流
Max
原为 24650, 现为 32045 共享 每月 信用
1 用户
所有模型
工作流
Enterprise
更高的限制
自定义
定价和账单条款

Free
供随意体验
$0
永久免费
常见问题
进一步了解 Seed Audio 1.5
Ideogram 4.6
Ideogram
Ideogram 最新图像模型,2026 年 11 月发布。 文字精准,改图精确,质感真实。
Seedance 2.5 Flash
ByteDance
ByteDance 推出的更快、成本更低的 Seedance 2.5 版本。 草稿更快,可多试几版,480p 和 720p。
Seedream 5.5
ByteDance
ByteDance 的 Seedream 图像模型,2026 年 11 月发布。 多轮编辑干净,画面更真实,文字更清晰。
Gemini Omni Flash 1.2
Google DeepMind
Google 的视频模型,单次长达 15 秒。 整段镜头都能改,每秒还便宜 30%。