Gemini Omni Flash 1.2
von Google DeepMind
Googles Videomodell, jetzt mit 15 Sekunden Länge.
Den ganzen Take bearbeiten, für rund 30 % weniger pro Sekunde.
Hauptfunktionen
Technische Spezifikationen
Gemini Omni
Dritte Omni-Flash-Version; Modell-ID gemini-omni-1.2-flash
3 bis 15 s
Volle Sekunden, standardmäßig 10 s; Verlängerungen reichen bis 30 s
Bis 4K
360p und 720p nativ, 1080p und 4K hochskaliert
0,07 $ pro Sekunde
In 720p; etwa 30 % unter Omni Flash 1.1
6 Bilder
Drei pro Charakter für bis zu zwei Charaktere, dazu Clips von 3 s
Nativ
Dialog, Effekte und Musik im selben Durchgang
16:9, 9:16
Bei einem fertigen Take per Folgeprompt umschaltbar
SynthID
Unsichtbare Herkunftsmarkierung in jedem generierten Clip
Anwendungsfälle
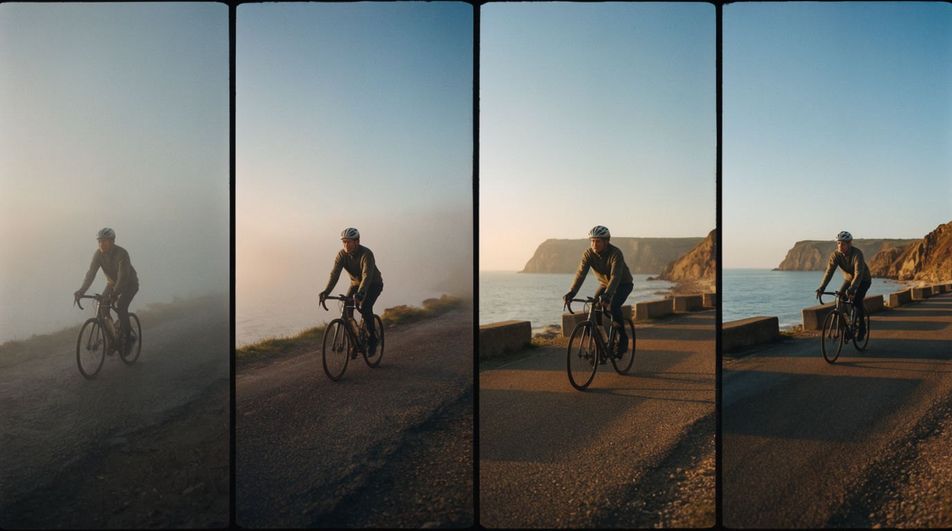
Takes mit 15 Sekunden
Ein ganzer Handlungsbogen in einer Generierung: Anfahrt, Wendung, Ankunft. Das 10-Sekunden-Fragment, das Sie erst verlängern müssen, entfällt.
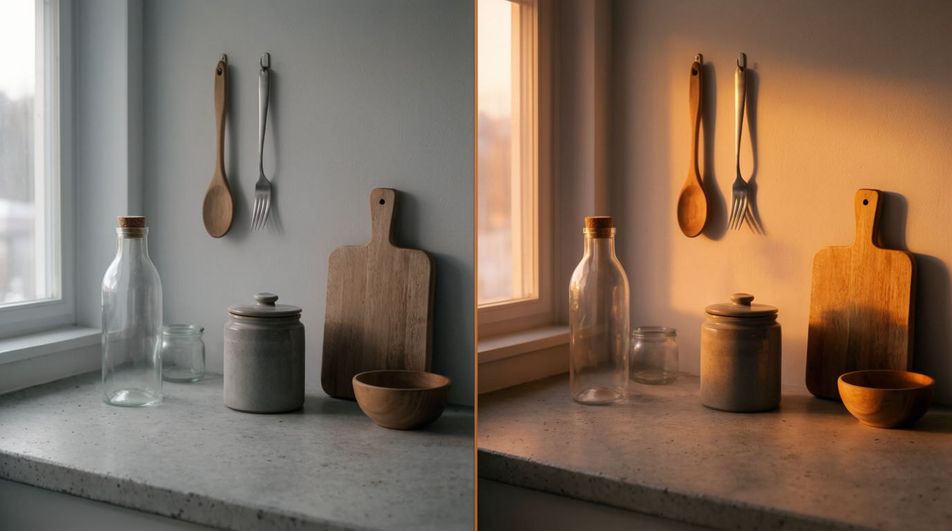
Edits per Texteingabe
Sie geben dem Modell den Take und nennen die Änderung: Raum neu beleuchten, das Glas tauschen, das Etikett umschreiben. Der übrige Bildinhalt bleibt erhalten.
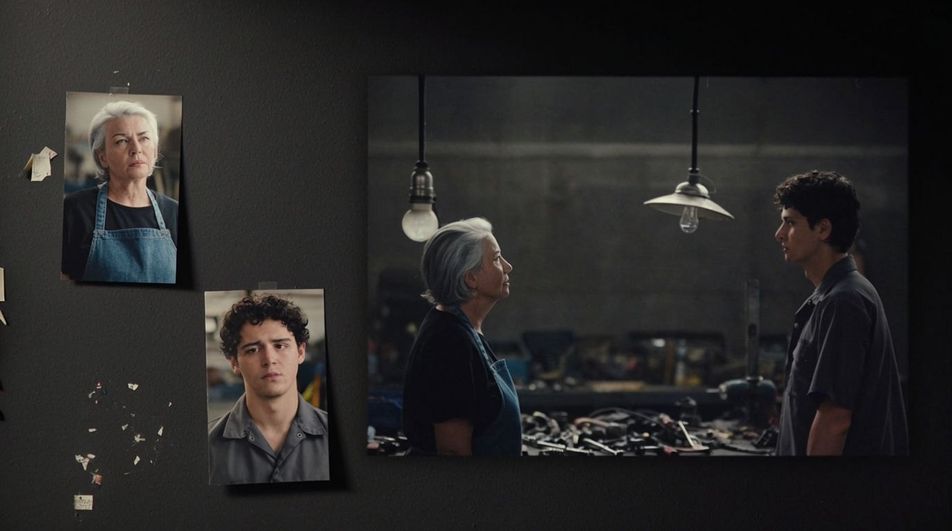
Zwei Charaktere, beide stabil
Je drei Fotos von zwei Personen legen Gesichter und Kleidung fest. So bleibt ein Zwiegespräch vom ersten Take bis zum letzten Edit wiedererkennbar.
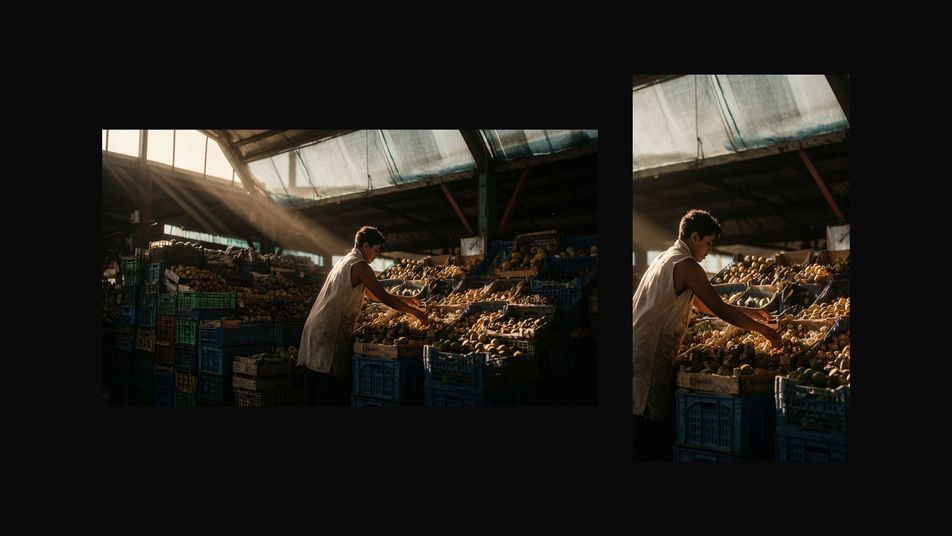
Ein Take, beide Formate
Den Hochkant-Schnitt bestellen Sie, sobald die Querformat-Fassung freigegeben ist. Das Format ist ein Folgeprompt und keine zweite Generierung.
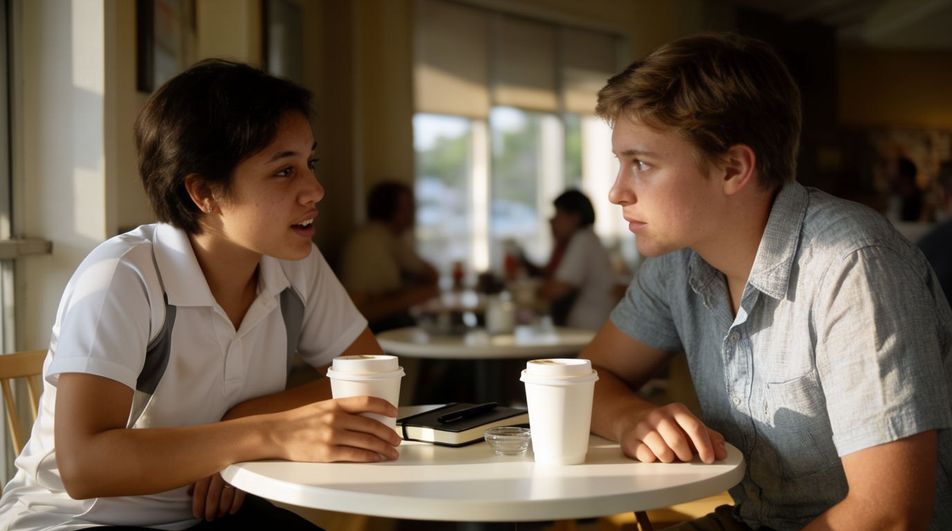
Szenen mit zwei Stimmen
Sie schreiben beide Rollen aus, und die Zeilen kommen lippensynchron aus den richtigen Mündern. Die Stimmen bleiben auch bei späteren Edits erhalten.
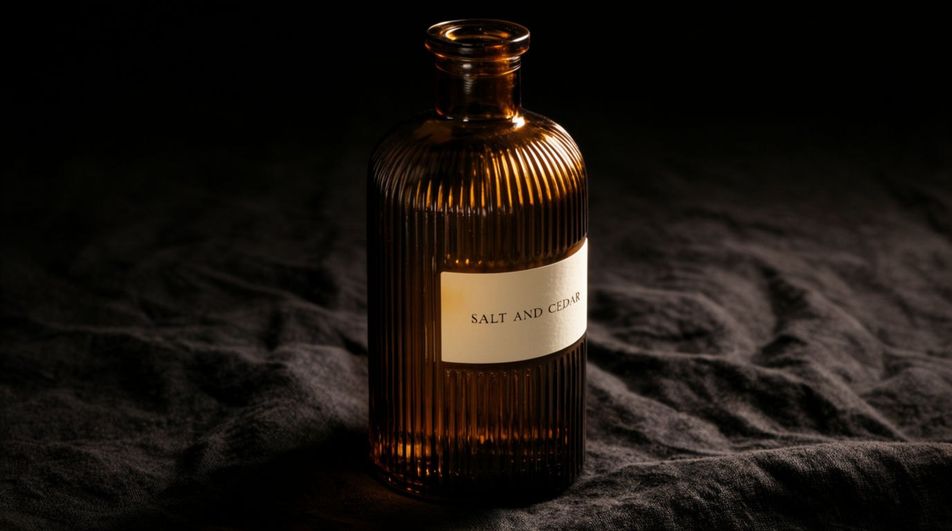
Verpackung, die hält
Der eigene Karton geht als Referenz hinein. Seine Typografie übersteht die Kamerabewegung, statt in ähnlich aussehende Buchstaben zu zerfallen.
Prompt-Beispiele
Handlungsbogen in 15 Sekunden
Fünfzehn Sekunden in einer Einstellung: Ein Laternenanzünder geht in der Dämmerung am Fleet entlang, Backsteinspeicher im Abendlicht
Edit promptZwei Sprecher
Zwei Kolleginnen streiten in einer warmen Küche über das richtige Streuselkuchen-Rezept, überlappende Dialogzeilen
Edit promptKamerabewegung
Eine ununterbrochene Kranfahrt von der regennassen Pflasterstraße hinauf zu einem erleuchteten Fenster
Edit promptText im Bild
Ein handgemaltes Schild mit der Aufschrift COLD BREW, Buchstabe für Buchstabe
Edit promptTon im Mittelpunkt
Nahaufnahme eines Wasserkochers kurz vor dem Sieden, jedes Ticken und Klappern hörbar
Edit promptÜberblick
Gemini Omni Flash 1.2 schreibt Google als Gemini Omni 1.2 Flash. Es ist die dritte Version von Google DeepMinds multimodalem Videomodell, angekündigt am 5. November 2026. Das Grundprinzip ist gleich geblieben: Ein Prompt, Bilder oder kurze Clips gehen hinein, Video mit synchronem Ton kommt heraus. Folgeprompts arbeiten anschließend am selben Take weiter. Neu ist, wie viel Szene in eine Generierung passt und wie wenig sie kostet.
Was ist neu in Gemini Omni Flash 1.2?
Eine Generierung dauert jetzt bis zu 15 Sekunden, einstellbar in vollen Sekunden ab drei. Bei 1.1 war nach zehn Schluss. Die Bearbeitung per Gespräch gilt für den ganzen Clip. Produkt tauschen, Wetter ändern oder die Hochkant-Fassung bestellen sind damit Folgeprompts auf einem freigegebenen Take. Referenzen sind um Personen organisiert: sechs Bilder pro Anfrage, davon bis zu drei für jeden von zwei Charakteren. Google nennt für 720p etwa 0,07 $ pro Sekunde, rund 30 % unter dem Satz von 1.1. 360p-Entwürfe sind noch günstiger.
Die leiseren Fortschritte betreffen das, was stehen bleibt. Laut Google halten Gesichter, Kleidung, Verpackungsschrift und Farben besser durch einen Shot. Innerhalb einer durchgehenden Kamerafahrt gibt es weniger ungewollte Schnitte. Der Dialog wirkt natürlicher, die Lippensynchronisation klarer, und mehrere Sprecher werden berücksichtigt. Drei Bereiche gelten als unfertig: schnelle Sportaktion, Skripte mit raschen Richtungswechseln und komplexe Physik.
Warum 15 Sekunden anders schreiben lassen
Zehn Sekunden sind ein Fragment. Ein Prompt für 1.1 beschrieb deshalb meist eine einzelne Geste und verließ sich für den Rest auf die Verlängerung. Fünfzehn Sekunden reichen für einen Handlungsbogen mit Anfang und Ende. Der Prompt kann daher eine kleine Struktur tragen: Anfahrt, Wendung, Ankunft. Die Verlängerung gibt es weiterhin für längere Szenen. Sie arbeitet in Schritten von drei bis zehn Sekunden bis zu insgesamt 30 und liest die letzten zehn Sekunden des Clips als Kontext. Der praktische Unterschied liegt darin, wie selten Sie sie brauchen.
Gemini Omni Flash 1.2 und Morphic
Gemini Omni Flash 1.2 ist noch nicht im Morphic-Katalog. Gemini Omni Flash 1.1 ist es dagegen, im Videomodell-Auswahlmenü neben Veo 3.1, Seedance 2.5, Kling und den übrigen Modellen. Prompt-Aufbau und nativer Ton der Familie können Sie also schon heute nutzen. Dasselbe Briefing lässt sich durch mehrere Modelle schicken und landet nebeneinander auf dem Canvas. Das ist praktisch für Agenturen und Teams, die Ergebnisse vor der Freigabe vergleichen müssen. Wer Kundenmaterial einsetzt, klärt Datenschutz und Auftragsverarbeitung vorab mit dem jeweiligen Anbieter; auf Morphic gelten die Bedingungen von Morphic.
Jedes Beispiel auf dieser Seite entstand auf Morphic mit dem nächstliegenden verfügbaren Modell, nicht mit 1.2. Google hat angekündigt, Anfragen an 1.1 in der eigenen API ab dem 3. Dezember 2026 auf 1.2 umzuleiten. Die Prompt-Mechanik erklärt der Gemini-Omni-Flash-1.2-Leitfaden. Startpunkte zum Kopieren finden Sie in der Gemini-Omni-Flash-1.2-Prompt-Bibliothek. Was sich geändert hat, zeigt der Vergleich von 1.2 und 1.1. Oder öffnen Sie direkt den Gemini Omni Flash 1.2 KI-Videogenerator.
Einfache Preise
Starten Sie noch heute kostenlos, mit der Option, jederzeit zu upgraden oder zu kündigen.
Basic
2400 monatliche Credits
1 Nutzer
Alle Modelle
Workflows
Standard
3625 monatliche Credits
1 Nutzer
Alle Modelle
Workflows
Pro
6350 gemeinsame monatliche Credits
1 Nutzer
Alle Modelle
Workflows
Max
24650 gemeinsame monatliche Credits
1 Nutzer
Alle Modelle
Workflows
Enterprise
Für höhere Limits
Individuell
Preis- und Abrechnungsbedingungen

Free
Zum Ausprobieren
$0
dauerhaft kostenlos
Häufig gestellte Fragen
ChatGPT Images 2.6
OpenAI
Das Bildmodell von OpenAI, November 2026. GIF-Loops, SVG-Export, schnellere Entwürfe.
SAM 3.1
Meta
Metas Segment-Anything-Modell. Jedes Motiv tracken, als Maske, die ihm folgt.
Seed Audio 1.5
ByteDance
ByteDances Szenen-Audiomodell. Dialog, Musik und Effekte als getrennte Spuren.
FLUX Video Upscale
Black Forest Labs
Der Video-Upscaler von Black Forest Labs. Bis 4K, mit neu aufgebauten Details und erhaltenem Ton.