OmniHuman 2.0
von ByteDance
ByteDances Modell für audiogesteuerte Personenvideos.
Ein Foto, eine Tonspur, fünf Minuten in einem Take.
Hauptfunktionen
Die Angaben stammen von BytePlus selbst, aus dem Launch-Beitrag vom 15. Oktober 2026. Die Clips auf dieser Seite entstanden auf Morphic, bevor OmniHuman 2.0 dort startete, mit Veed Fabric, das ebenfalls aus einem Foto und einer Tonspur ein sprechendes Video von bis zu 5 Minuten erzeugt.
Technische Spezifikationen
5 Min.
Eine durchgehende Einstellung, laut BytePlus
60 Sek.
Obergrenze für eine Einstellung vor 2.0
Foto + Audio
Ein Bild der Person und eine Tonspur
Jede Spur
Sprache, Musik oder Dialog
Anwendungsfälle
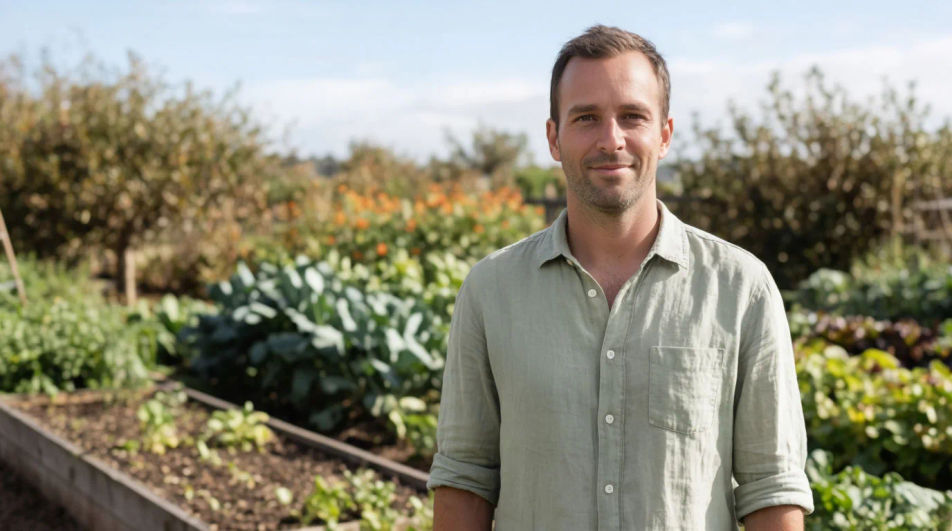
Kurse und Lektionen
Eine ganze Lektion in einem Take: Der Dozent sieht in Minute vier genauso aus wie in Minute eins, und nichts muss zusammengeschnitten werden.
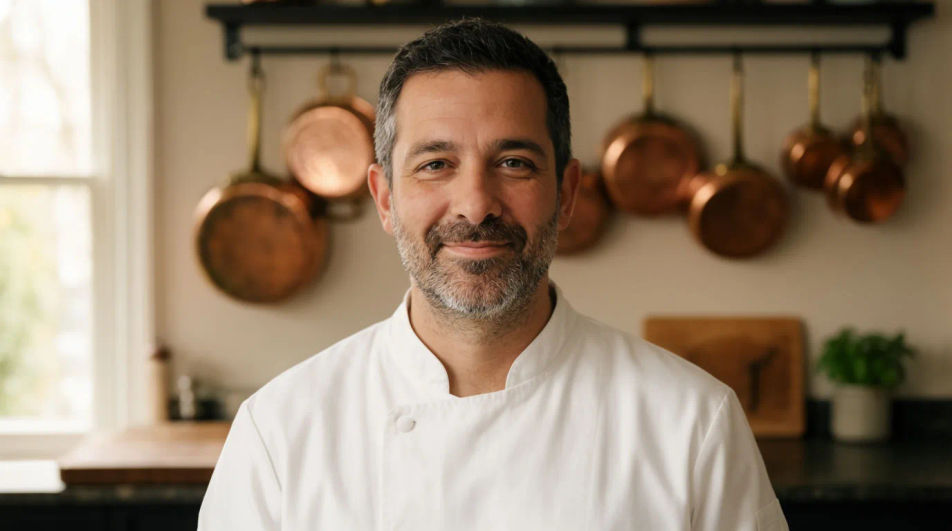
Erklär- und Anleitungsvideos
Nehmen Sie das Voiceover zuerst auf oder erzeugen Sie es, dann trägt ein Foto es vor, mit den Pausen und Betonungen, die Zuschauer dranbleiben lassen.
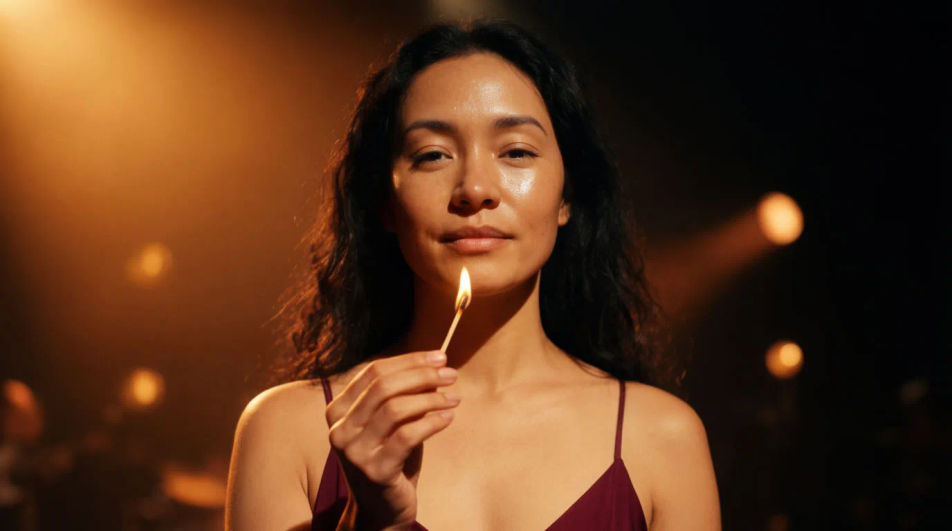
Musikalische Auftritte
Geben Sie ihm einen gesungenen Titel, und das Gesicht trägt die langen Töne, die Atemzüge und das Gefühl des Songs, nicht nur den Text.
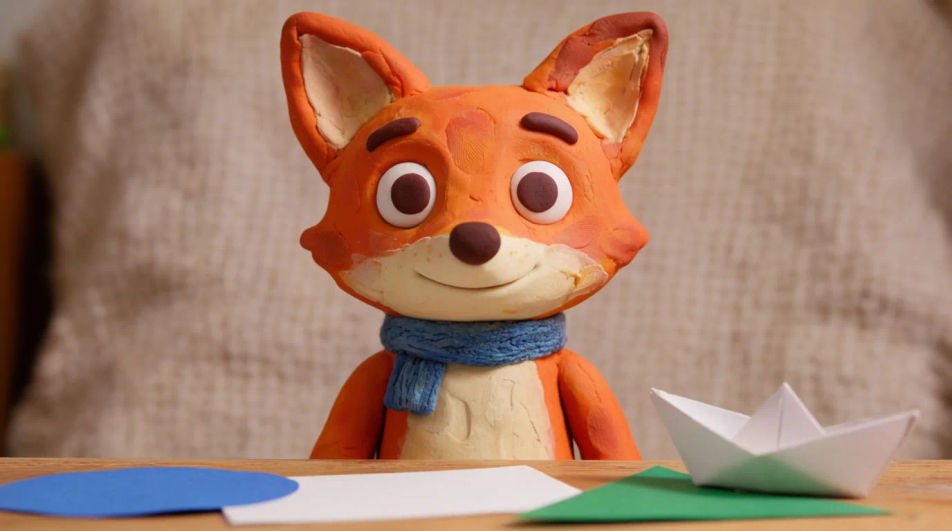
Maskottchen und Figuren
Leihen Sie einem Marken-Maskottchen, einer Clay-Figur oder einer gezeichneten Heldin eine Stimme, für Werbung, Kinderinhalte und Kanalintros.
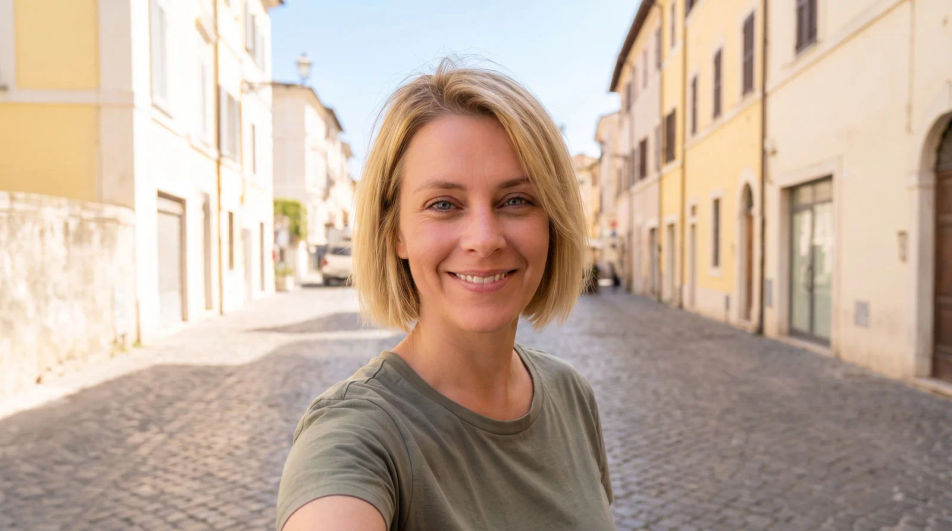
Videos für Creator und Social Media
Vertikale Sprechclips für Reels und Shorts entstehen aus einem einzigen Selfie-Foto und einer Stimmspur und sind direkt bereit zum Posten.
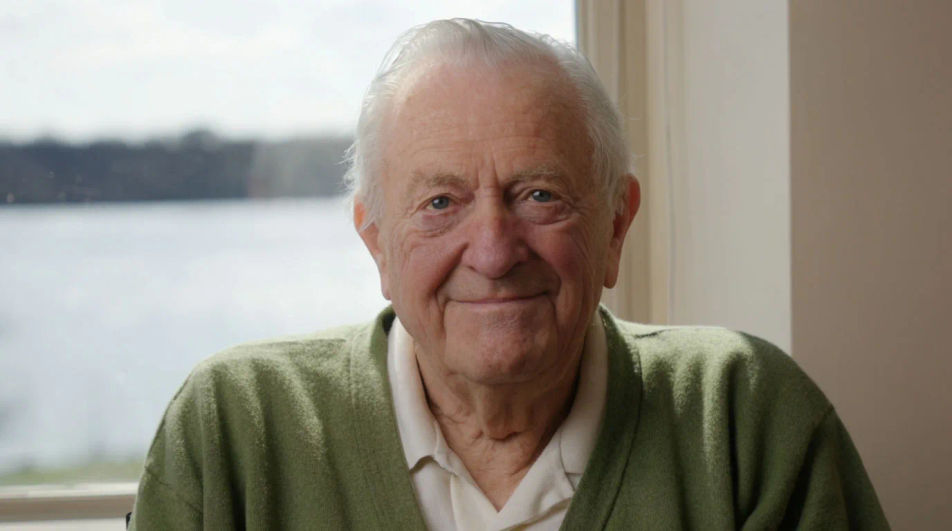
Geschichten und Podcasts
Lange gesprochene Geschichten behalten ihren Rhythmus, vom leisen Aufbau bis zur Pointe, ohne dass die Person jede Minute neu ansetzt.
Überblick
OmniHuman 2.0 ist ByteDances Modell für audiogesteuerte Personenvideos und erschien am 15. Oktober 2026 über BytePlus. Aus einem Foto und einer Tonspur macht es ein Video, in dem die Person die Spur vorträgt. Dabei liest es Tonfall, Emotion und Worte der Audiodatei und passt nicht nur die Mundform an. Eine einzelne Einstellung darf jetzt bis zu 5 Minuten dauern, bisher waren es 60 Sekunden, und es wird nichts zusammengeschnitten (Quelle).
Was OmniHuman 2.0 anders macht
Die meisten Modelle für sprechende Fotos bewegen den Mund passend zum Ton. OmniHuman 2.0 hört darauf, wie ein Satz gesagt wird. Eine geflüsterte Gutenachtgeschichte, ein gerufenes Kommando vom Trainer und ein gehaltener Ton im Lied werden so zu drei verschiedenen Darbietungen, obwohl die Eingabe jedes Mal ein Foto und eine Spur ist.
Für Teams mit Schulungen, Onboarding-Videos oder Erklärfilmen zählt vor allem die Länge. Eine Lektion, eine Geschichte oder ein ganzer Song läuft als eine Einstellung. Damit entfällt die Nahtstelle, an der sich Gesicht, Licht oder Hintergrund ändern könnten.
OmniHuman 2.0 auf Morphic
OmniHuman 2.0 ist auf Morphic verfügbar: Öffnen Sie Copilot, hängen Sie ein Foto und eine Tonspur an und bitten Sie um ein sprechendes Video mit OmniHuman 2.0. Die Clips auf dieser Seite entstanden auf dieselbe Weise mit Veed Fabric, noch vor dem Start von OmniHuman 2.0. Wie Sie das beste Ergebnis erzielen, lesen Sie im OmniHuman-2.0-Guide.
Einfache Preise
Starten Sie noch heute kostenlos, mit der Option, jederzeit zu upgraden oder zu kündigen.
Basic
2400 monatliche Credits
1 Nutzer
Alle Modelle
Workflows
Standard
3625 monatliche Credits
1 Nutzer
Alle Modelle
Workflows
Pro
6350 gemeinsame monatliche Credits
1 Nutzer
Alle Modelle
Workflows
Max
24650 gemeinsame monatliche Credits
1 Nutzer
Alle Modelle
Workflows
Enterprise
Für höhere Limits
Individuell
Preis- und Abrechnungsbedingungen

Free
Zum Ausprobieren
$0
dauerhaft kostenlos
Häufig gestellte Fragen
Mehr über OmniHuman 2.0
Anleitungen, Prompts und Vergleiche zu OmniHuman 2.0.
Weitere Modelle
Entdecken Sie den Rest des Morphic-Modellkatalogs.
Gemini Omni Flash 1.2
Google DeepMind
Googles Videomodell, jetzt mit 15 Sekunden Länge. Den ganzen Take bearbeiten, für rund 30 % weniger pro Sekunde.
ChatGPT Images 2.6
OpenAI
Das Bildmodell von OpenAI, November 2026. GIF-Loops, SVG-Export, schnellere Entwürfe.
SAM 3.1
Meta
Metas Segment-Anything-Modell. Jedes Motiv tracken, als Maske, die ihm folgt.
Seed Audio 1.5
ByteDance
ByteDances Szenen-Audiomodell. Dialog, Musik und Effekte als getrennte Spuren.