OmniHuman 2.0
par ByteDance
Le modèle vidéo de ByteDance piloté par l’audio.
Une photo, une piste, cinq minutes en un seul plan.
Fonctionnalités clés
Les spécifications viennent de BytePlus, dans son annonce de lancement du 15 octobre 2026. Les clips de cette page ont été réalisés sur Morphic avant l’arrivée d’OmniHuman 2.0 sur la plateforme, avec Veed Fabric, qui transforme lui aussi une photo et une piste audio en vidéo parlante pouvant atteindre 5 minutes.
Spécifications techniques
5 min
Un seul plan continu, selon BytePlus
60 s
Le plafond d’un plan unique avant la version 2.0
Photo + audio
Une image de l’interprète et une piste
Toute piste
Voix, musique ou dialogue
Cas d'utilisation
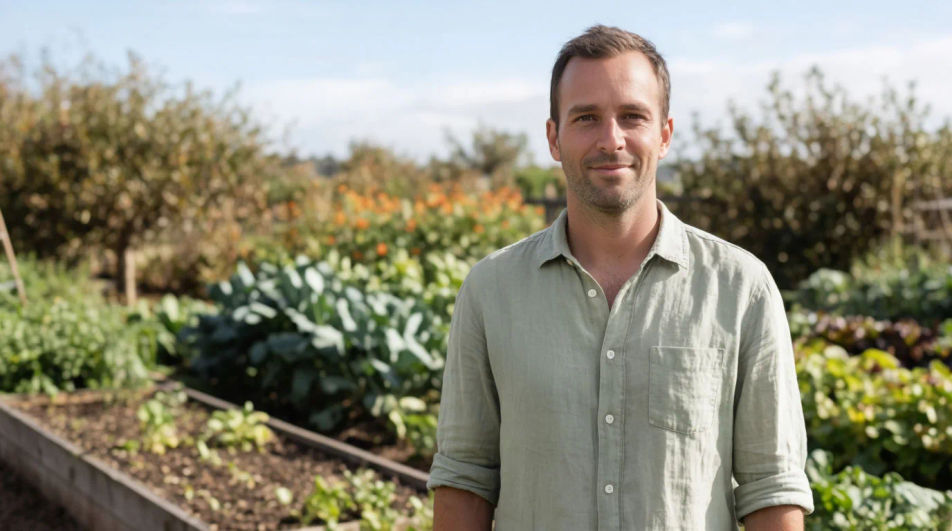
Cours et formations en ligne
Une leçon entière en un seul plan : le formateur a le même visage à la quatrième minute qu’à la première, et rien n’est à monter.
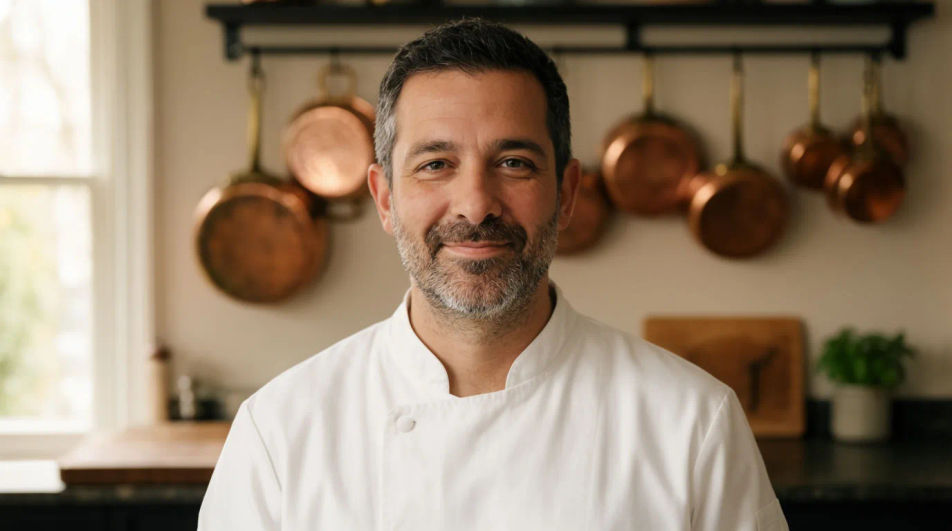
Explications et tutoriels vidéo
Enregistrez ou générez d’abord la voix off, puis laissez une seule photo la porter, avec les pauses et les accents qui retiennent le spectateur.
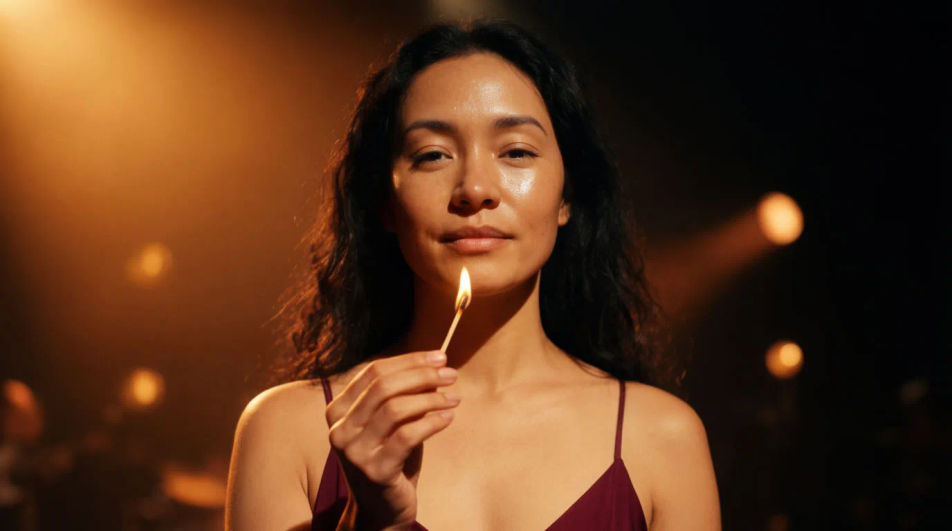
Clips musicaux
Donnez-lui un morceau chanté : le visage porte les notes longues, les respirations et l’émotion du chant, pas seulement les paroles.
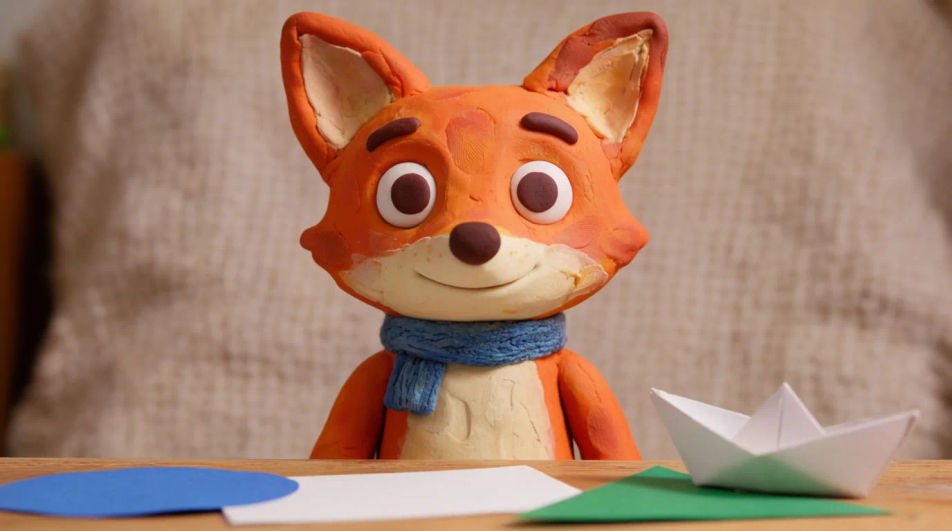
Mascottes et personnages
Prêtez une voix à une mascotte de marque, à un personnage en pâte à modeler ou à un héros illustré, pour une pub, un contenu jeunesse ou une intro de chaîne.
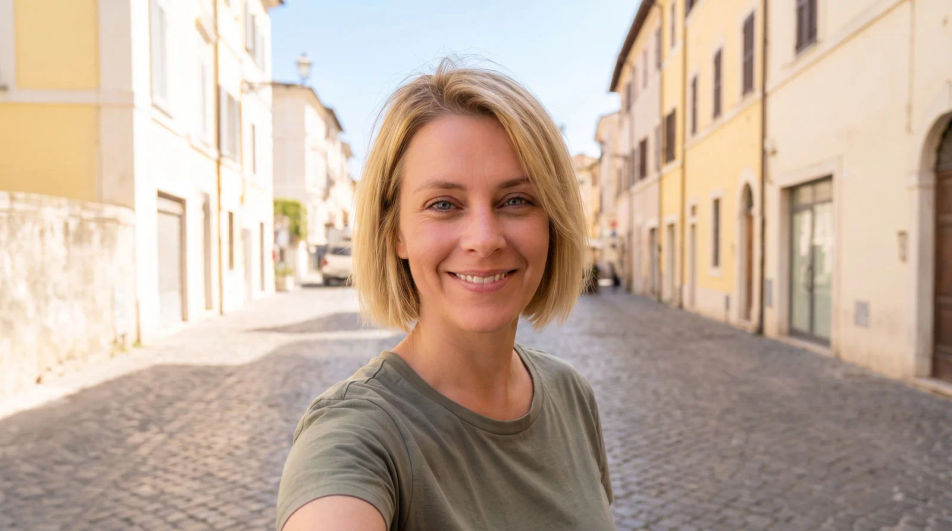
Vidéos de créateurs et réseaux sociaux
Des clips verticaux parlants pour Reels et Shorts, à partir d’un selfie et d’une piste vocale, prêts à publier.
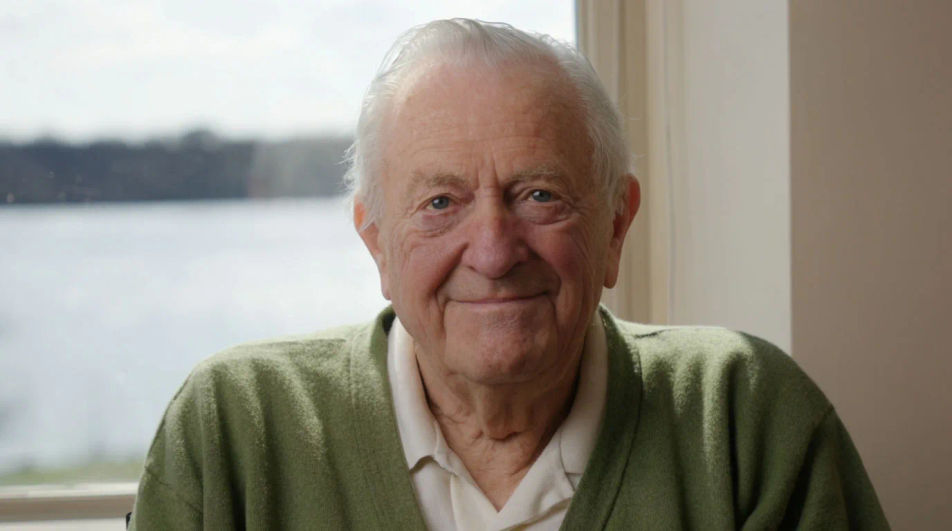
Récits et podcasts
Les longs récits gardent leur rythme, de la montée discrète à la chute, sans que l’interprète reparte de zéro chaque minute.
Aperçu
OmniHuman 2.0 est le modèle vidéo de ByteDance piloté par l’audio, lancé via BytePlus le 15 octobre 2026. À partir d’une photo et d’une piste audio, il génère la vidéo de cette personne qui joue la piste. Il lit le ton, l’émotion et les mots, au lieu de seulement caler les lèvres. Un plan unique peut désormais durer jusqu’à 5 minutes, contre 60 secondes avant, sans raccord (source).
Ce qu’OmniHuman 2.0 fait différemment
La plupart des modèles de photo parlante font bouger la bouche au rythme du son. OmniHuman 2.0 écoute la façon dont la phrase est dite. Une histoire murmurée, une consigne criée par un coach et une note tenue donnent trois interprétations différentes, avec le même type d’entrée.
La prise longue compte autant. Une leçon, un récit ou une chanson entière tient en un seul plan, donc sans jointure où le visage, la lumière ou le décor pourraient changer. Pour une formation en ligne, un cours complet se génère ainsi d’un seul tenant.
OmniHuman 2.0 sur Morphic
OmniHuman 2.0 est disponible sur Morphic : ouvrez Copilot, joignez une photo et une piste audio, puis demandez une vidéo parlante avec OmniHuman 2.0. Les clips de cette page ont été réalisés de la même façon avec Veed Fabric, avant le lancement d’OmniHuman 2.0, avec des voix en anglais. Pour obtenir le meilleur résultat, consultez le guide OmniHuman 2.0.
Tarifs simples
Commencez gratuitement dès aujourd'hui, avec la possibilité de mettre à niveau ou d'annuler à tout moment.
Basic
2400 mensuel crédits
1 utilisateur uniquement
Tous les modèles
Workflows
Standard
3625 mensuel crédits
1 utilisateur uniquement
Tous les modèles
Workflows
Pro
6350 partagé mensuel crédits
1 utilisateur
Tous les modèles
Workflows
Max
24650 partagé mensuel crédits
1 utilisateur
Tous les modèles
Workflows
Enterprise
Pour des limites plus élevées
Personnalisé
conditions de tarification et de facturation

Free
Pour expérimenter
$0
gratuit pour toujours
Questions fréquentes
En savoir plus sur OmniHuman 2.0
Guides, prompts et comparatifs pour OmniHuman 2.0.
Autres modèles
Explorez le reste du catalogue de modèles Morphic.
Seedream 5.5
ByteDance
Le modèle d’images Seedream de ByteDance, sorti en novembre 2026. Retouche multi-tours propre, réalisme et textes plus nets.
Gemini Omni Flash 1.2
Google DeepMind
Le modèle vidéo de Google, désormais à quinze secondes. Retouchez toute la prise pour 30 % de moins la seconde.
ChatGPT Images 2.6
OpenAI
Le modèle d’image d’OpenAI, sorti en novembre 2026. GIF animés, export SVG, brouillons plus rapides.
SAM 3.1
Meta
Le modèle Segment Anything de Meta. Un masque qui suit n’importe quel sujet.