Generator audio AI Seed Audio 1.5

Model audio satu adegan dari ByteDance. Suara, musik, efek di track terpisah.

Semua model audio

Satu ruang kerja

Adegan, bukan sekadar suara

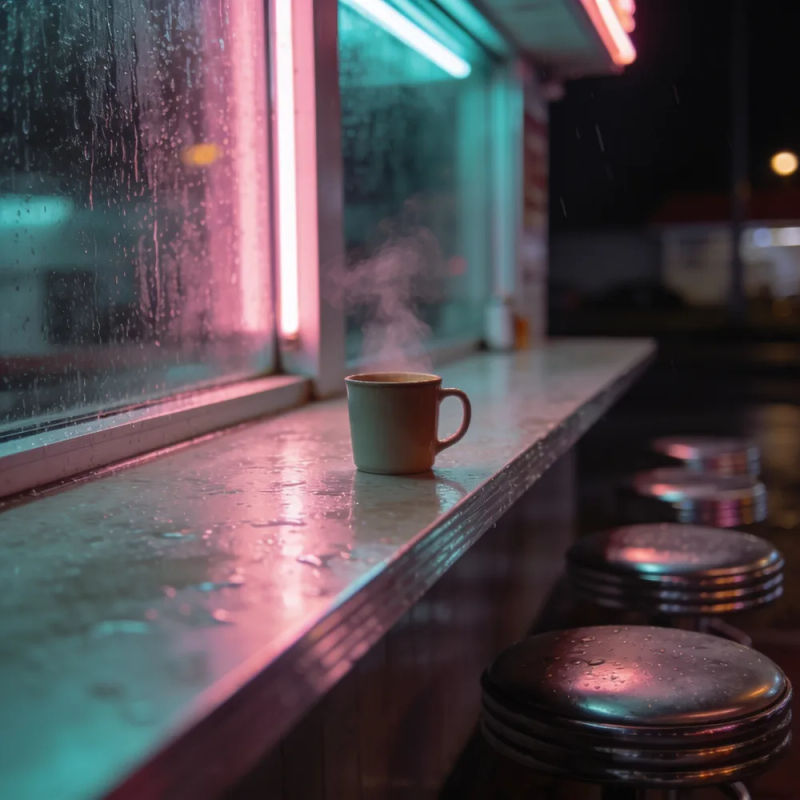
Meja kedai makan larut malam dengan satu cangkir mengepul dan hujan di jendela
Kedai makan larut malam
[Diner at 2 a.m., a fridge hums, rain outside.] Waitress (50s, kind): "Coffee's on the house tonight, hon." Driver (tired, grateful): "You're an angel. Long road tonight."
0:00
0:12
Edit prompt
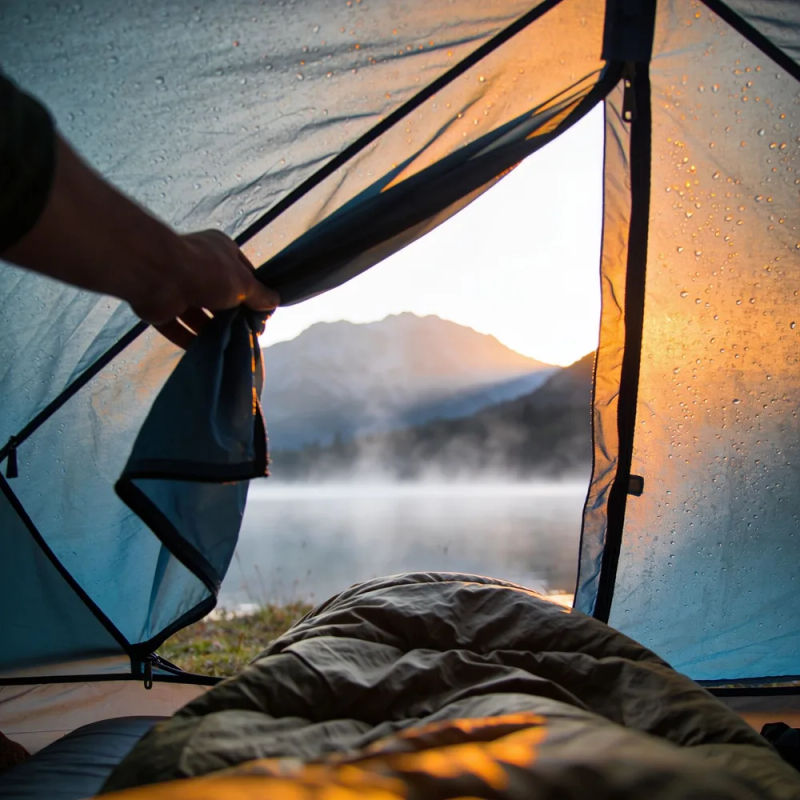
Tangan membuka resleting pintu tenda saat fajar, menghadap danau pegunungan yang berkabut
Iklan berkemah
[Warm acoustic guitar builds.] Narrator (warm, smiling): "Weekend plans? Pack light. We've got the tent." [0:08] The music swells and a tent zipper closes.
0:00
0:12
Edit prompt
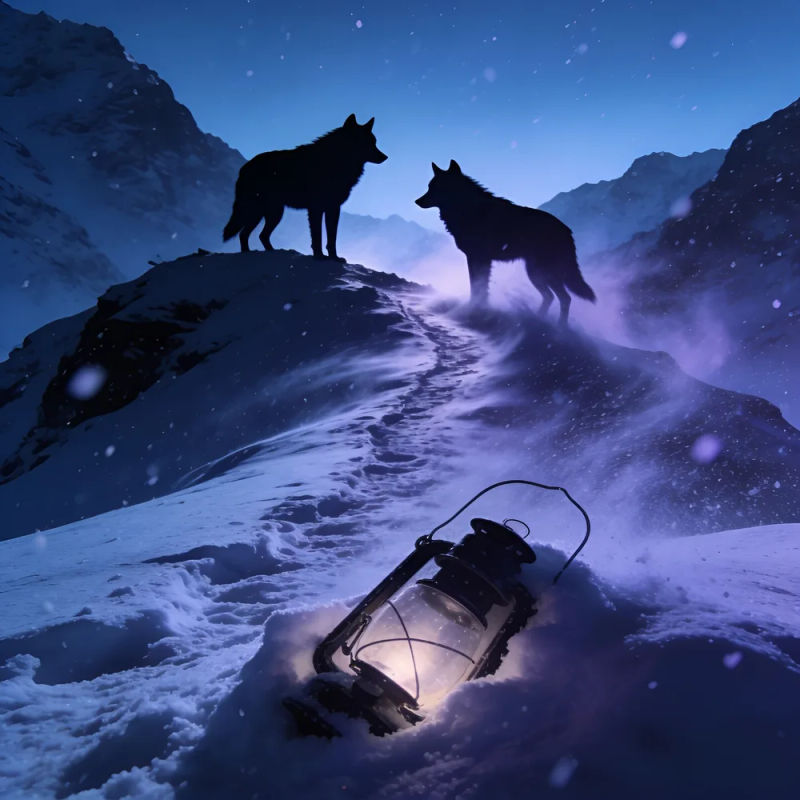
Dua serigala di punggungan bersalju saat senja kebiruan, dengan lentera di atas salju
Momen gim
[Snowy mountain pass, howling wind, tense low strings.] Scout (urgent whisper): "Wolves. Two of them. Don't move." [0:06] A low growl, close by.
0:00
0:12
Edit prompt
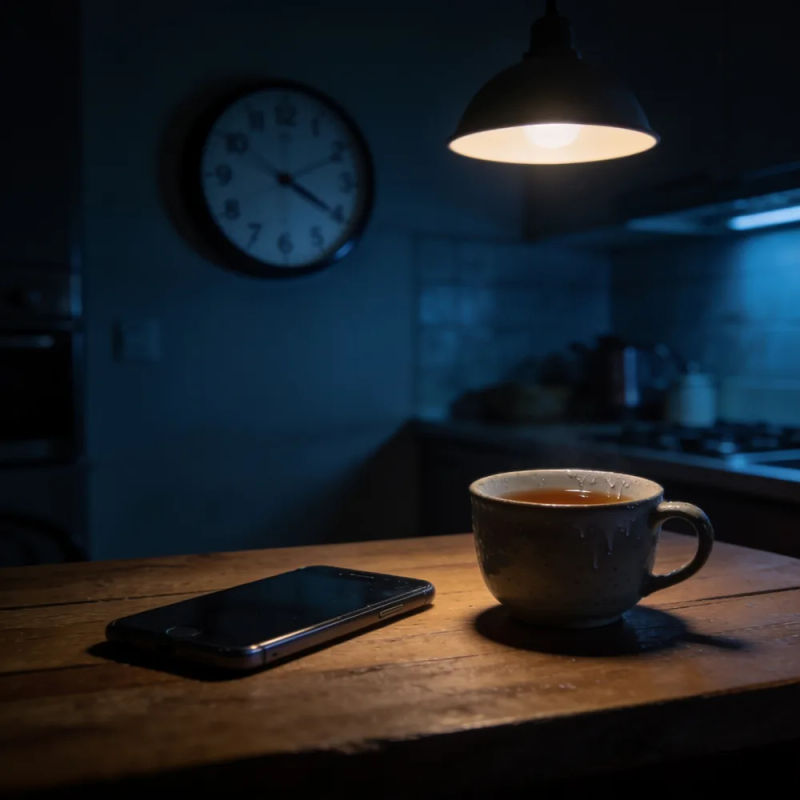
Dapur remang di malam hari dengan jam dinding, ponsel tertelungkup, dan secangkir teh dingin
Drama pendek
[Kitchen, late evening, a clock ticks, soft piano.] Mother (quiet, hurt): "You didn't call." Son (defensive, then soft): "I was busy, Mom, I... I know. I'm sorry."
0:00
0:12
Edit prompt
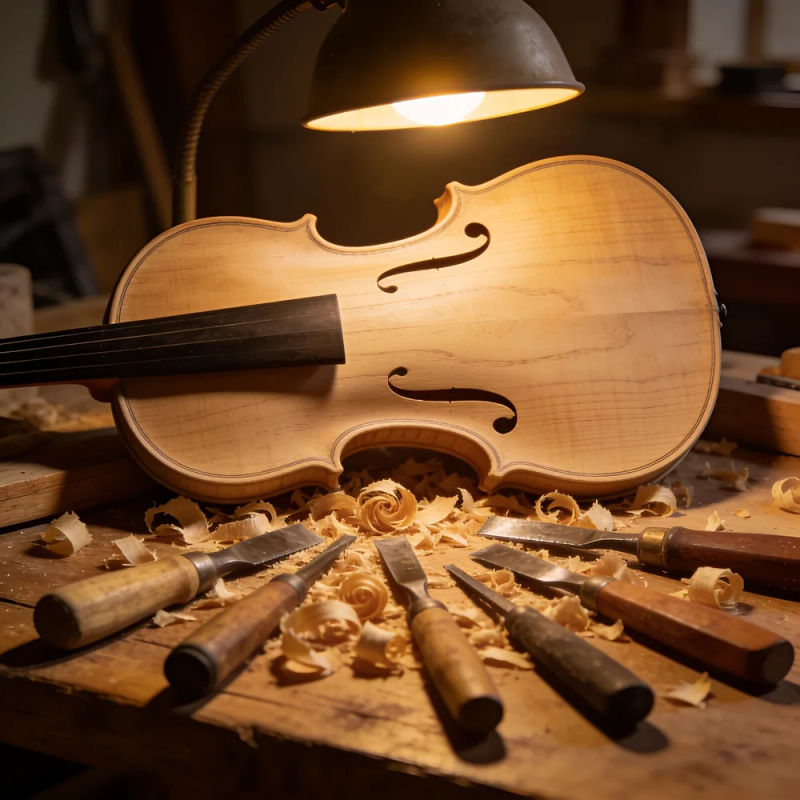
Badan biola yang belum selesai di meja kerja, dengan alat ukir dan serutan kayu
Dokumenter kriya
[Workshop at night, a lamp hums, a chisel shaves wood, a solo violin far off.] Narrator (warm, hushed): "Every violin starts as a block of spruce... and a lot of patience."
0:00
0:12
Edit prompt
Dua pasang kaki telanjang di pasir basah saat ombak surut ketika matahari terbenam
Portugis Brasil
[Beach at sunset, gentle waves, soft bossa nova guitar.] Narrator (relaxed, warm, Brazilian Portuguese): "O sol já está indo embora... fica mais um pouco."
0:00
0:12
Edit prompt

Fitur utama

Buat audio adegan dalam tiga langkah

  1. 01

    Buka Morphic

    Daftar, lalu mulai berkarya di Canvas visual tanpa batas yang bebas Anda isi.

  2. 02

    Tulis adegannya

    Jelaskan tempatnya, tentukan suara tiap tokoh, lalu tulis dialognya. Punya referensi suara atau video? Tambahkan juga. Untuk konten TikTok atau iklan UMKM, mulai dari satu adegan pendek.

  3. 03

    Buat, lalu edit per track

    Dialog, ambience, efek, dan musik kembali terpisah. Perbaiki satu lapisan, sisanya tetap.

Hasil dari Seed Audio 1.5

Satu adegan utuh dari satu prompt

Suara, bunyi ruangan, efek, dan musik datang sekaligus dengan keseimbangan yang sudah pas. Kafe, badai, atau stadion terdengar seperti tempat nyata, bukan suara di atas keheningan.
Tiga gelombang suara tembus pandang berwarna amber, perak, dan teal menyatu menjadi satu bentuk

Dubbing yang mengikuti gambar

Tambahkan video yang sudah jadi, dan Seed Audio 1.5 menulis dubbing, musik, dan efek sesuai aksinya. Dialog bisa diterjemahkan, sementara musik dan efek aslinya tetap.
Bingkai persegi panjang bercahaya dengan riak gelombang dari tepi bawahnya

Track terpisah untuk proses edit

Dialog, ambience, efek, dan musik kembali sebagai track sendiri-sendiri. Kecilkan musik, bisukan satu efek, atau ganti satu baris tanpa menyentuh sisanya.
Empat lembar kaca bercahaya berwarna amber, teal, perak, dan mawar melayang terpisah di dalam kabut

Adegan enam menit

Satu adegan drama, satu segmen podcast, atau satu bab narasi muat dalam sekali proses, dengan hingga enam suara dari klip referensi.
Garis cakrawala panjang dari cahaya lembut yang memanjang ke kedalaman seperti gelombang suara yang pelan

Semua di Morphic

Stack audio lengkap Anda

Harga sederhana

Mulai gratis hari ini, dengan opsi untuk upgrade atau membatalkan kapan saja.

Basic

$19/ bulan
ditagih sebagai $228 per tahun

2400 bulanan kredit

1 pengguna saja

Semua model

Workflows

Standard

$24/ bulan
ditagih sebagai $288 per tahun

3625 bulanan kredit

1 pengguna saja

Semua model

Workflows

Pro

$45/ bulan
ditagih sebagai $540 per tahun

6350 bersama bulanan kredit

1 pengguna

+ hingga 4 lainnya dengan biaya tambahan

Semua model

Workflows

Max

$170/ bulan
ditagih sebagai $2040 per tahun

24650 bersama bulanan kredit

1 pengguna

+ hingga 9 lainnya dengan biaya tambahan

Semua model

Workflows

Enterprise

Untuk batas yang lebih tinggi

Khusus

ketentuan harga dan penagihan

Kredit volume tinggi
Batas kursi khusus
Semua model
Workflows
Pricing Gradient

Free

Untuk bereksperimen

$0

gratis selamanya

Hingga 20 kredit
Hanya 1 pengguna
Model terbatas
Workflows

FAQ

Apa itu generator audio AI Seed Audio 1.5?
Seed Audio 1.5 adalah model audio satu adegan dari ByteDance. Satu prompt menghasilkan dialog, musik, ambience, dan efek suara sebagai track terpisah, hingga enam menit. Itu tiga kali batas dua menit Seed Audio 1.0. Dengan input video, suaranya bisa mengikuti hasil edit akhir untuk dubbing dan sound design.
Apakah generator audio AI Seed Audio 1.5 gratis?
Morphic punya paket gratis, jadi Anda bisa mulai membuat audio tanpa bayar. Saat Seed Audio 1.5 hadir di Morphic, modelnya memakai kredit yang sama dengan model audio lain. Paket berbayar menambah kredit untuk adegan yang lebih panjang.
Bisakah saya memakai Seed Audio 1.5 online?
Bisa. Semuanya berjalan di browser lewat Morphic, tanpa instalasi apa pun. Seed Audio 1.5 sendiri segera hadir, seperti dijelaskan di bawah. Tulis adegannya, buat, dan audionya muncul di Canvas, berdampingan dengan gambar dan video Anda.
Kapan Seed Audio 1.5 hadir di Morphic?
ByteDance merilis Seed Audio 1.5 pada 28 Oktober 2026, dan segera hadir di Morphic. Sampai saat itu, Seed Audio 1.0 sudah aktif di Morphic untuk adegan utuh, berdampingan dengan ElevenLabs dan Lyria. Contoh di halaman ini dibuat di Morphic dengan suara dan efek suara dari ElevenLabs serta musik dari Lyria, lalu dicampur menjadi adegan.
Apakah audio Seed Audio 1.5 aman dipakai untuk komersial?
Ketentuan penggunaan komersial bergantung pada syarat model dan paket yang Anda pakai. Baca syaratnya sebelum audio dipakai untuk iklan atau jualan. Pastikan juga Anda berhak atas klip referensi yang diunggah.
Bisakah Seed Audio 1.5 dipakai untuk dubbing video konten dan iklan?
Bisa. Tambahkan video, dan modelnya menulis voice-over, musik, efek, dan ambience yang mengikuti aksi di layar. Dialognya juga bisa diterjemahkan ke bahasa lain, dengan musik dan efek aslinya tetap. Minta penutur yang fasih memeriksa hasilnya sebelum Anda mengunggah ke TikTok, Reels, atau toko online.
Bagaimana cara kerja track terpisah?
Seed Audio 1.5 mengembalikan dialog, ambience, efek, dan musik sebagai track sendiri-sendiri, bukan satu berkas yang sudah dicampur. Dialog juga bisa dipisah per suara. Anda bisa menurunkan volume satu lapisan, membisukannya, atau mengganti satu baris tanpa membuat ulang seluruh adegan.
Bisakah saya meniru suara dengan Seed Audio 1.5?
Anda bisa menambahkan hingga enam klip referensi untuk menentukan suara dalam adegan, selama Anda punya haknya. Batasan dari ByteDance memblokir peniruan suara orang sungguhan tanpa izin mereka.

Anda mungkin juga suka