Seed Audio 1.5 は、ByteDance のフルシーン音声モデルで、2026年10月28日にリリースされました。Morphic には近日登場予定です。1つのプロンプトから、セリフ、音楽、環境音、効果音が別々のトラックで返ります。長さは最長6分です。ナレーションの差し替えや吹き替えなど、声と音を別々に扱いたい制作向けの書き方を、このガイドでまとめました。すぐにシーンプロンプトを試したい方は、Seed Audio 1.5 AI音声生成ツールをご覧ください。
Seed Audio 1.5 のプロンプトの組み立て方
シーンは、聞き手に聞こえる順に書きます。まず場所、次に話す人、その人のセリフ、最後に周囲で起きること。物語を先に書き、音のリストは後に置きます。
| 要素 | 書く内容 | 例 |
|---|---|---|
| シーン | 場所、時間、天気、部屋の広さ | [夜。誰もいない駅のホーム、屋根を打つ雨。] |
| 声 | 名前、年齢、なまり、感情、速さ | ミサキ(30代、落ち着いた、疲れた声) |
| セリフ | 正確な言葉を、かぎ括弧の中に | 「終電、もう行っちゃったね。」 |
| 効果音 | 音の出どころと、動き方 | [濡れたコンクリートを歩く足音が、遠ざかる。] |
| 音楽 | ジャンル、楽器、雰囲気、音量 | [全体の下で、低いシンセパッドが鳴る。] |
| タイミング | 必要な箇所にタイムスタンプ | [0:06] 足音が始まる。 |
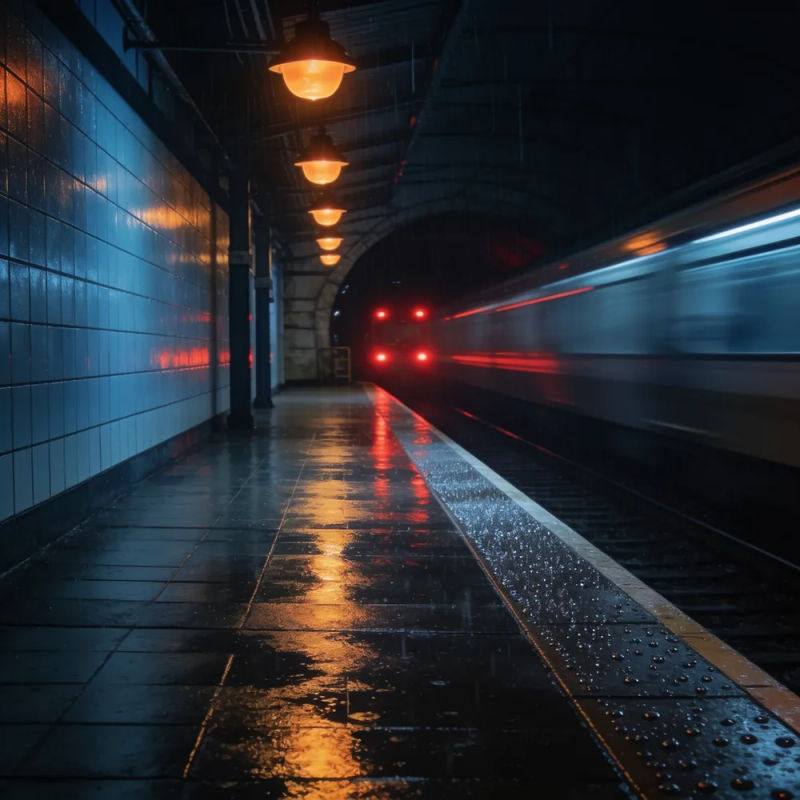
Seed Audio 1.5 はまだ Morphic には届いていません。このため、サンプルは Morphic 上で作りました。ElevenLabs の音声と効果音、Lyria の音楽を、各プロンプトに合わせてミックスしています。再生される音声は英語です。
Seed Audio 1.5 の5つの入力モード
どのモードも、テキストプロンプトから始まります。何を足すかで、モデルが自分で作る部分と、従う部分の割合が決まります。
| モード | 追加するもの | 向いている用途 |
|---|---|---|
| テキストから音声 | プロンプトと、雰囲気を決めるオプションの参照画像 | 最初の下書き、広告、サウンドベッド |
| 参照音声 | 声の参照クリップを最大6本(各2〜30秒) | 固定のキャスト、すでに使っているナレーター |
| 動画から音声 | 動画クリップ、オプションで声の参照も | カットへの音付け、映像に合わせたサウンドデザイン |
| 動画の吹き替え | 動画とターゲット言語、オプションの用語集 | 30言語への対話の翻訳 |
| ステム分離 | 1つの音声ファイル(最長6分) | ミックスをボーカル、効果音、音楽に分離 |
Seed Audio 1.5 のタイムスタンプ
Seed Audio 1.0 では、セリフに [5.5s:8.0s] のような時間枠を指定できました。Seed Audio 1.5 では、効果音と音楽のキューにも使えます。ドアの音、短い強調音、盛り上がりが、モデルの推測ではなく、指定した位置に入ります。
- 映像に合わせたい箇所に、時間を付けます。カットに合わせたセリフ、打撃に合わせた衝撃音、見せ場に合わせた盛り上がりなどです。
- ほかは、時間を付けずに任せます。ルームトーンやBGMは、モデルに配置させたほうが自然に聞こえます。
- タイムスタンプは順番に並べます。セリフ同士が偶然重ならないよう、少し間を空けてください。
[0:00] 小さな劇場で、観客がざわめく。[0:04] 照明が「カチッ」と落ちる。[0:05] 司会(温かく、声をひそめて):「みなさま、ようこそお越しくださいました。」[0:09] ピアノの和音がひとつ。
Seed Audio 1.5 の声の参照
参照クリップを、キャラクター1人につき1本、最大6本まで追加します。プロンプトで各クリップにタグを付け、どの声がどのセリフを話すかをモデルに伝えます。参照が声の音色を決め、プロンプトが演技を決めます。
| 指示する内容 | 書き方 |
|---|---|
| 感情 | (参照2:傷ついて、涙をこらえている) |
| スタイル | (参照1:淡々と、控えめに、少し楽しげ) |
| ペース | (参照3:ゆっくり、文と文の間に長い間) |
| 言葉以外の音 | (参照1:セリフの前にため息、後に短い笑い) |
使うのは、権利を持っている声の、きれいな録音です。実在の人物の声には、本人の許可が必要です。公開や商用に使う作品では、権利の確認を先に済ませてください。
Seed Audio 1.5 で動画を吹き替え・翻訳する
Seed Audio 1.5 に動画を渡すと、動きに合わせた声と音を書き出します。ナレーション、音楽、効果音、環境音です。クリップ全体の文脈も保ちます。翻訳では、話されている言語を置き換え、元の効果音と音楽は残します。
- 話者ごとの声を説明するか、参照を追加します。どの言語でも同じキャストで吹き替えられます。
- 残すものを伝えます。たとえば「元の音楽と効果音は残し、セリフだけ差し替える」です。
- 公開前に、その言語が堪能な人に、発音、意味、言い回しを確認してもらいます。
今の Morphic では、AI動画吹き替えでクリップを翻訳し、声を差し替えられます。字幕や口の動きの調整、最終編集までの手順は、吹き替えとローカライズの解説にまとめています。
Seed Audio 1.5 の別トラック出力
Seed Audio 1.0 が返すのは、ミックス済みの1ファイルでした。Seed Audio 1.5 は、セリフ、環境音、効果音、音楽を別々のトラックで返します。セリフは声ごとに分けることもできます。再生すると、嵐のシーンが聞こえます。再生中に、各トラックをミュートしたり、単独で聴いたりできます。声ごとに専用のレーンがあります。
| 編集で | 別トラックでできること |
|---|---|
| 音量 | 声には触れずに、セリフの下で音楽を下げる |
| ミュート | 効果音を外して静かなカットに。セリフを外して予告編のベッドに |
| 差し替え | ひとりのセリフや1つのキューだけ入れ替え、シーンのほかの部分はそのまま |
| 再利用 | 同じ環境音を次のシーンに敷き、場所が続いているように聞かせる |
Seed Audio 1.5 と Seed Audio 1.0 の違い
ByteDance の Seed Audio 1.0 のページは、次のステップとして3つを挙げていました。動画入力、長尺の音声、マルチトラック出力です。Seed Audio 1.5 はこの3つをすべて備えており、2026年10月28日から BytePlus ModelArk を通じて公式APIが利用可能です。
| Seed Audio 1.0 | Seed Audio 1.5 | |
|---|---|---|
| 1回の生成の長さ | 2分 | 6分 |
| 声の参照 | 3本 | 6本 |
| 言語 | 20言語 | 30言語 |
| 入力 | テキスト、音声の参照、画像1枚 | 動画が加わる |
| 出力 | ミックス済みの1トラック | セリフ、環境音、効果音、音楽の別トラック |
| タイムスタンプ | セリフ | セリフ、効果音、音楽のキュー |
| 歌詞付きの曲 | 非対応 | 対応 |
Seed Audio 1.0 のプロンプトの多くは、そのまま使えます。1.0 のプロンプトの詳細は、Seed Audio 1.0 ガイドをご覧ください。
よくある質問
ByteDance は2026年10月28日に Seed Audio 1.5 をリリースしました。公式APIは ModelArk から利用可能です。Morphic では現在 Seed Audio 1.0 が使え、Seed Audio 1.5 も近日登場予定です。
Seed Audio 1.5 はリリース済みで、Morphic にも近日登場予定です。今日からでも、Seed Audio 1.0 でフルシーンを作れます。同じ Canvas 上の ElevenLabs、Lyria などの音声モデルも使えます。
本人の許可がある場合のみです。ByteDance の制限により、本人の同意なしに、実在の人物と分かる声をまねることはできません。著作物や既存の歌詞も、同様に制限されています。参照クリップには、利用する権利のある録音を使ってください。
使えます。シーン、声、セリフ、効果音の構成は同じです。新しい機能を使うには、動画、増えた声の参照、効果音や音楽へのタイムスタンプを加えます。別トラックでの出力を頼むこともできます。
セリフは、話させたい言語で書きます。日本語で聞かせたいときも同じで、セリフは日本語で書きます。シーンや声の指示は、書きやすければ英語のままでも構いません。ただし各セリフは目的の言語に保ち、その言語が堪能な人に結果を確認してもらってください。Seed Audio 1.5 の対応言語は、公開時の情報で確認しましょう。