Seed Audio 1.5 音声生成AI

ByteDanceの場面音声モデル 対話と音楽、効果音を別トラックで

あらゆる音声モデル

ひとつのワークスペースで

声だけでなく、場面ごと作る

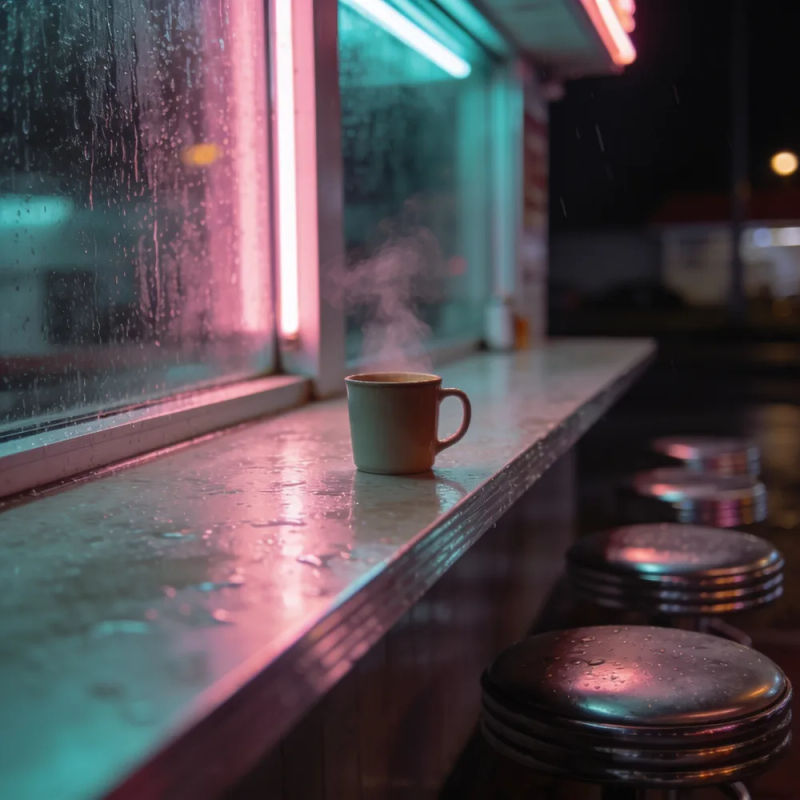
湯気の立つマグカップがひとつだけ置かれた深夜のダイナーのカウンター。窓には雨
深夜のダイナー
[Diner at 2 a.m., a fridge hums, rain outside.] Waitress (50s, kind): "Coffee's on the house tonight, hon." Driver (tired, grateful): "You're an angel. Long road tonight."
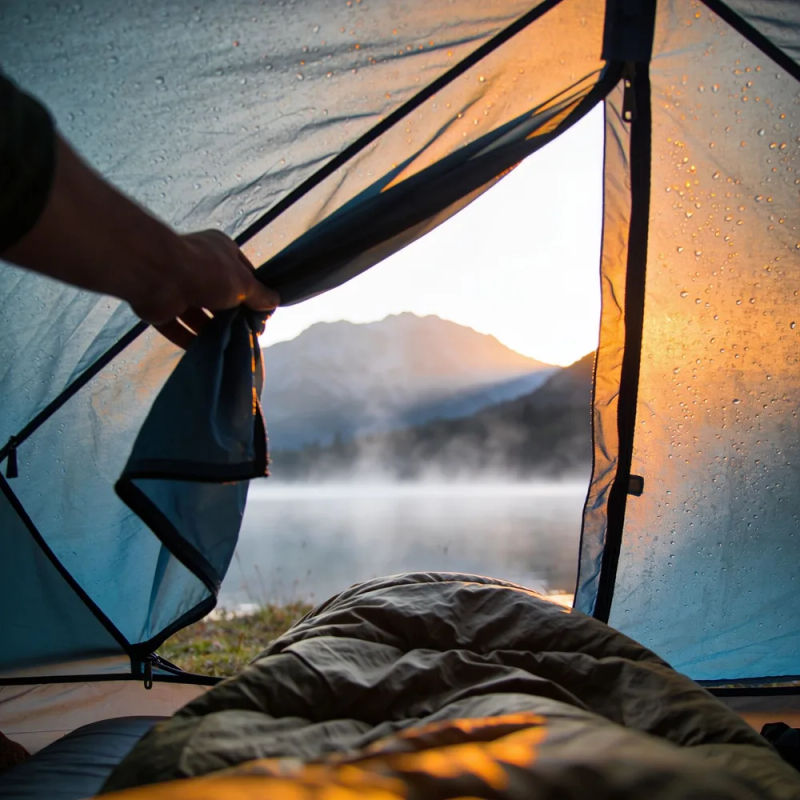
夜明けの光の中、霧のかかった山の湖に向けてテントの入口を開ける手
キャンプの広告
[Warm acoustic guitar builds.] Narrator (warm, smiling): "Weekend plans? Pack light. We've got the tent." [0:08] The music swells and a tent zipper closes.
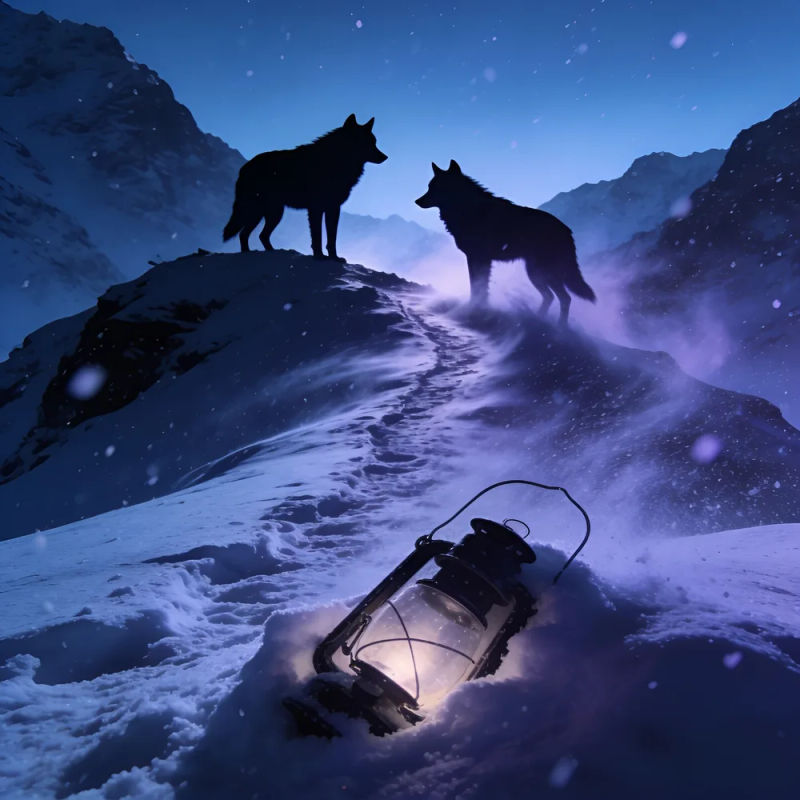
ブルーアワーの雪の尾根に立つ2頭の狼。雪の上にはランタン
ゲームの一場面
[Snowy mountain pass, howling wind, tense low strings.] Scout (urgent whisper): "Wolves. Two of them. Don't move." [0:06] A low growl, close by.
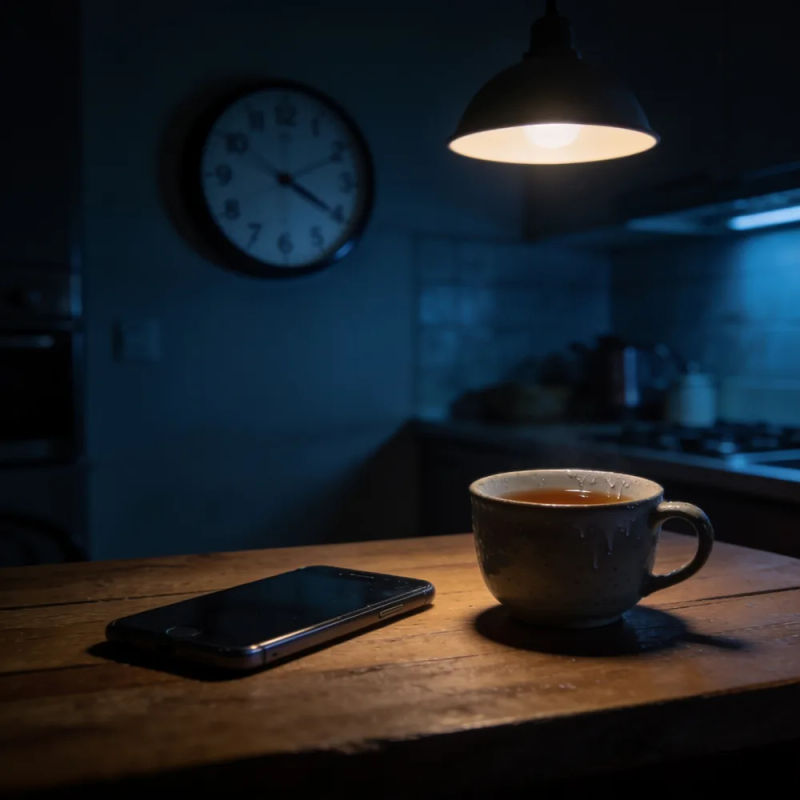
夜の薄暗いキッチン。壁掛け時計、伏せたスマートフォン、冷めたお茶
ショートドラマ
[Kitchen, late evening, a clock ticks, soft piano.] Mother (quiet, hurt): "You didn't call." Son (defensive, then soft): "I was busy, Mom, I... I know. I'm sorry."
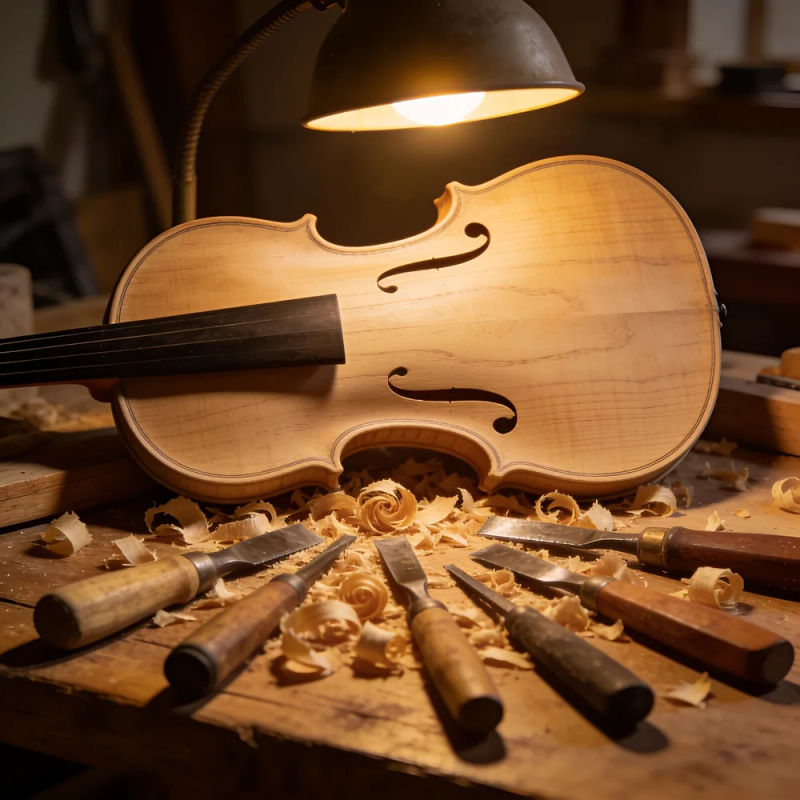
作業台の上の、未完成のバイオリンの胴。彫刻の道具と木くずが並ぶ
職人ドキュメンタリー
[Workshop at night, a lamp hums, a chisel shaves wood, a solo violin far off.] Narrator (warm, hushed): "Every violin starts as a block of spruce... and a lot of patience."
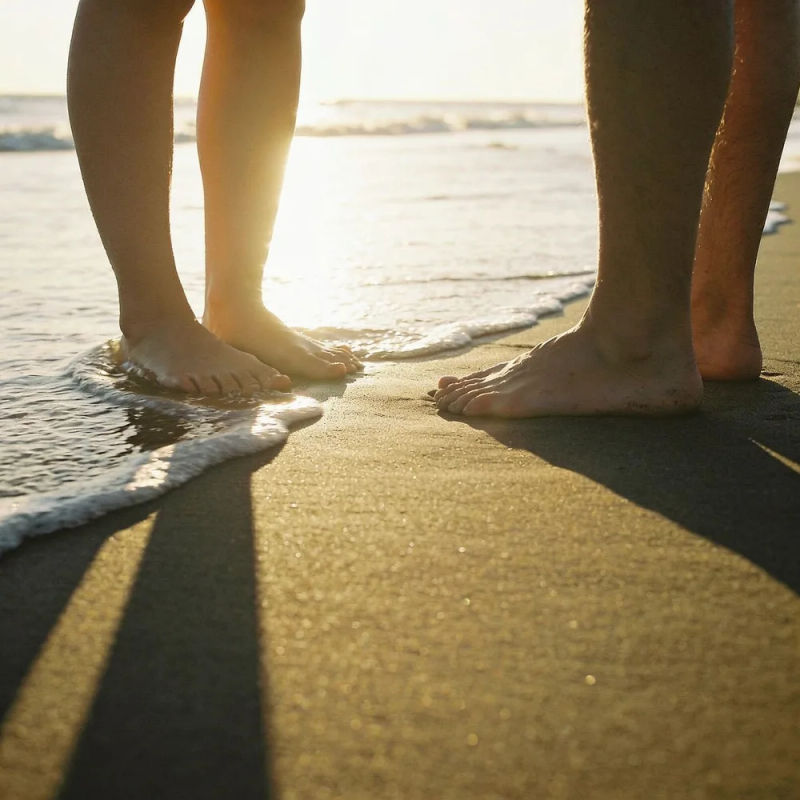
夕暮れ、引いていく波の中で濡れた砂に残る、2組の素足
ブラジルポルトガル語
[Beach at sunset, gentle waves, soft bossa nova guitar.] Narrator (relaxed, warm, Brazilian Portuguese): "O sol já está indo embora... fica mais um pouco."

主な機能

3ステップで場面の音声を生成

  1. 01

    Morphicを開く

    サインアップすると、無限に広がるビジュアルCanvasで制作を始められます。

  2. 02

    場面を書く

    場所を描き、声を決めて、セリフを書きます。ボイスドラマやショート動画の場面でも同じです。声の参照や動画があれば、ここで加えます。

  3. 03

    生成して、トラックごとに直す

    対話、環境音、効果音、音楽が別々に届きます。直したい層だけを直し、ほかはそのまま残せます。

Seed Audio 1.5で作れるもの

1つのプロンプトで場面まるごと

声、部屋の響き、効果音、音楽が、バランスの取れた状態で一度に届きます。カフェも嵐もスタジアムも、無音の上に声を乗せたのではなく、その場所の音になります。
琥珀色、銀色、青緑色の3つの半透明の波形が、ひとつの形に溶け合う

映像に合わせる吹き替え

完成した映像を加えると、Seed Audio 1.5が動きに合わせて、吹き替えと音楽、効果音を生成します。対話を翻訳しても、元の音楽と効果音は残せます。
光る長方形のフレーム。下の縁から波紋が広がっている

編集向けの別トラック

対話、環境音、効果音、音楽が、それぞれ別のトラックで届きます。音楽を下げる、効果音をミュートする、1行を差し替える。ほかには手を付けずに済みます。
琥珀色、青緑色、銀色、薔薇色の4枚の光るガラスの帯が、霞の中で離れて浮かんでいる

6分の場面

ドラマの1場面、ポッドキャストの1コーナー、朗読の1章が、1回の生成に収まります。参照クリップから、最大6人の声も決められます。
ゆるやかな波形のように、奥へ伸びていく長い地平線のやわらかな光

すべてMorphicで

音声制作がひと通り揃う

シンプルな料金体系

今すぐ無料で始めて、いつでもアップグレードまたはキャンセルできます。

Basic

$19/ 月
請求額は $0 年

2400 月 クレジット

1 ユーザーのみ

すべてのモデル

ワークフロー

Standard

$24/ 月
請求額は $0 年

3625 月 クレジット

1 ユーザーのみ

すべてのモデル

ワークフロー

Pro

$45/ 月
請求額は $0 年

6350 共有 月 クレジット

1 ユーザー

+ 最大 4 名まで追加費用

すべてのモデル

ワークフロー

Max

$170/ 月
請求額は $0 年

24650 共有 月 クレジット

1 ユーザー

+ 最大 9 名まで追加費用

すべてのモデル

ワークフロー

Enterprise

より高い制限のために

カスタム

料金と請求条件

大容量クレジット
カスタムシート制限
すべてのモデル
ワークフロー
Pricing Gradient

Free

気軽に試したい方に

$0

ずっと無料

最大20クレジット
1ユーザーのみ
一部のモデル
ワークフロー

よくある質問

Seed Audio 1.5 音声生成AIとは何ですか?
ByteDanceの場面音声モデル、Seed Audio 1.5です。1つのプロンプトから、対話、音楽、環境音、効果音を別々のトラックで生成します。長さは最長6分です。動画を入力すると、完成した映像に音を合わせられます。吹き替えや音の設計にも使えます。
Seed Audio 1.5 音声生成AIは無料で使えますか?
Morphicには無料枠があり、支払いなしで音声制作を始められます。ブラウザ上で動くので、インストールは不要です。生成した音声は、画像や動画と並んでCanvasに届きます。Seed Audio 1.5がMorphicに登場したら、ほかの音声モデルと同じクレジットで動きます。長い場面には、クレジットが増える有料プランが向いています。
Seed Audio 1.5で作った音声は商用利用できますか?
商用利用の可否は、使う声や素材の権利と、提供元の規約によって決まります。参照クリップは、権利を持つ音声だけを加えてください。公開する前に、Morphicとモデル提供元の最新の規約を確認することをおすすめします。
Seed Audio 1.5はいつMorphicで使えますか?
Seed Audio 1.5は近日公開です。公開されるまでは、Seed Audio 1.0がMorphicで使えます。ElevenLabsとLyriaも並んでいます。このページの音声サンプルは、Morphicで作りました。声と効果音にはElevenLabs、音楽にはLyriaを使い、場面にまとめています。
別トラックで出力すると、何が変わりますか?
Seed Audio 1.5は、対話、環境音、効果音、音楽を、1本にまとめずに返します。それぞれが別のトラックです。対話は、声ごとに分けることもできます。音楽だけ下げる、効果音をミュートする、1行だけ差し替える。そうした調整が、場面全体を作り直さずにできます。
Seed Audio 1.5で動画の吹き替えはできますか?
できます。動画を加えると、映像の動きに合わせて、ナレーションと音楽、効果音、環境音を生成します。対話を別の言語に訳し、元の効果音と音楽を残すこともできます。公開する前に、その言語が堪能な方に確認してもらってください。
Seed Audio 1.5は何分まで生成できますか?
1回の生成で最長6分です。Seed Audio 1.0の上限(2分)の3倍にあたります。ボイスドラマの1場面、ポッドキャストの1コーナー、朗読の1章を、1回で作れます。
Seed Audio 1.5で声を再現できますか?
場面の声を決めるために、参照クリップを最大6本まで加えられます。権利を持つ音声に限ります。ByteDanceの制限により、実在の人物の声を、本人の許可なく似せることはできません。

こちらもおすすめ