Mirelo SFX 2.0
Mirelo AI 提供
Mirelo AIの動画から音を作るモデル。
映像に新しい音を、セリフはそのままに。
主な機能
仕様とリスニングテストの数値はMirelo自身が2026年10月14日の発表で示したものです。このページのクリップは、同じ役割を今すぐ担えるSonilo SFXで、Morphic上で制作しました。
違いを聴き比べる
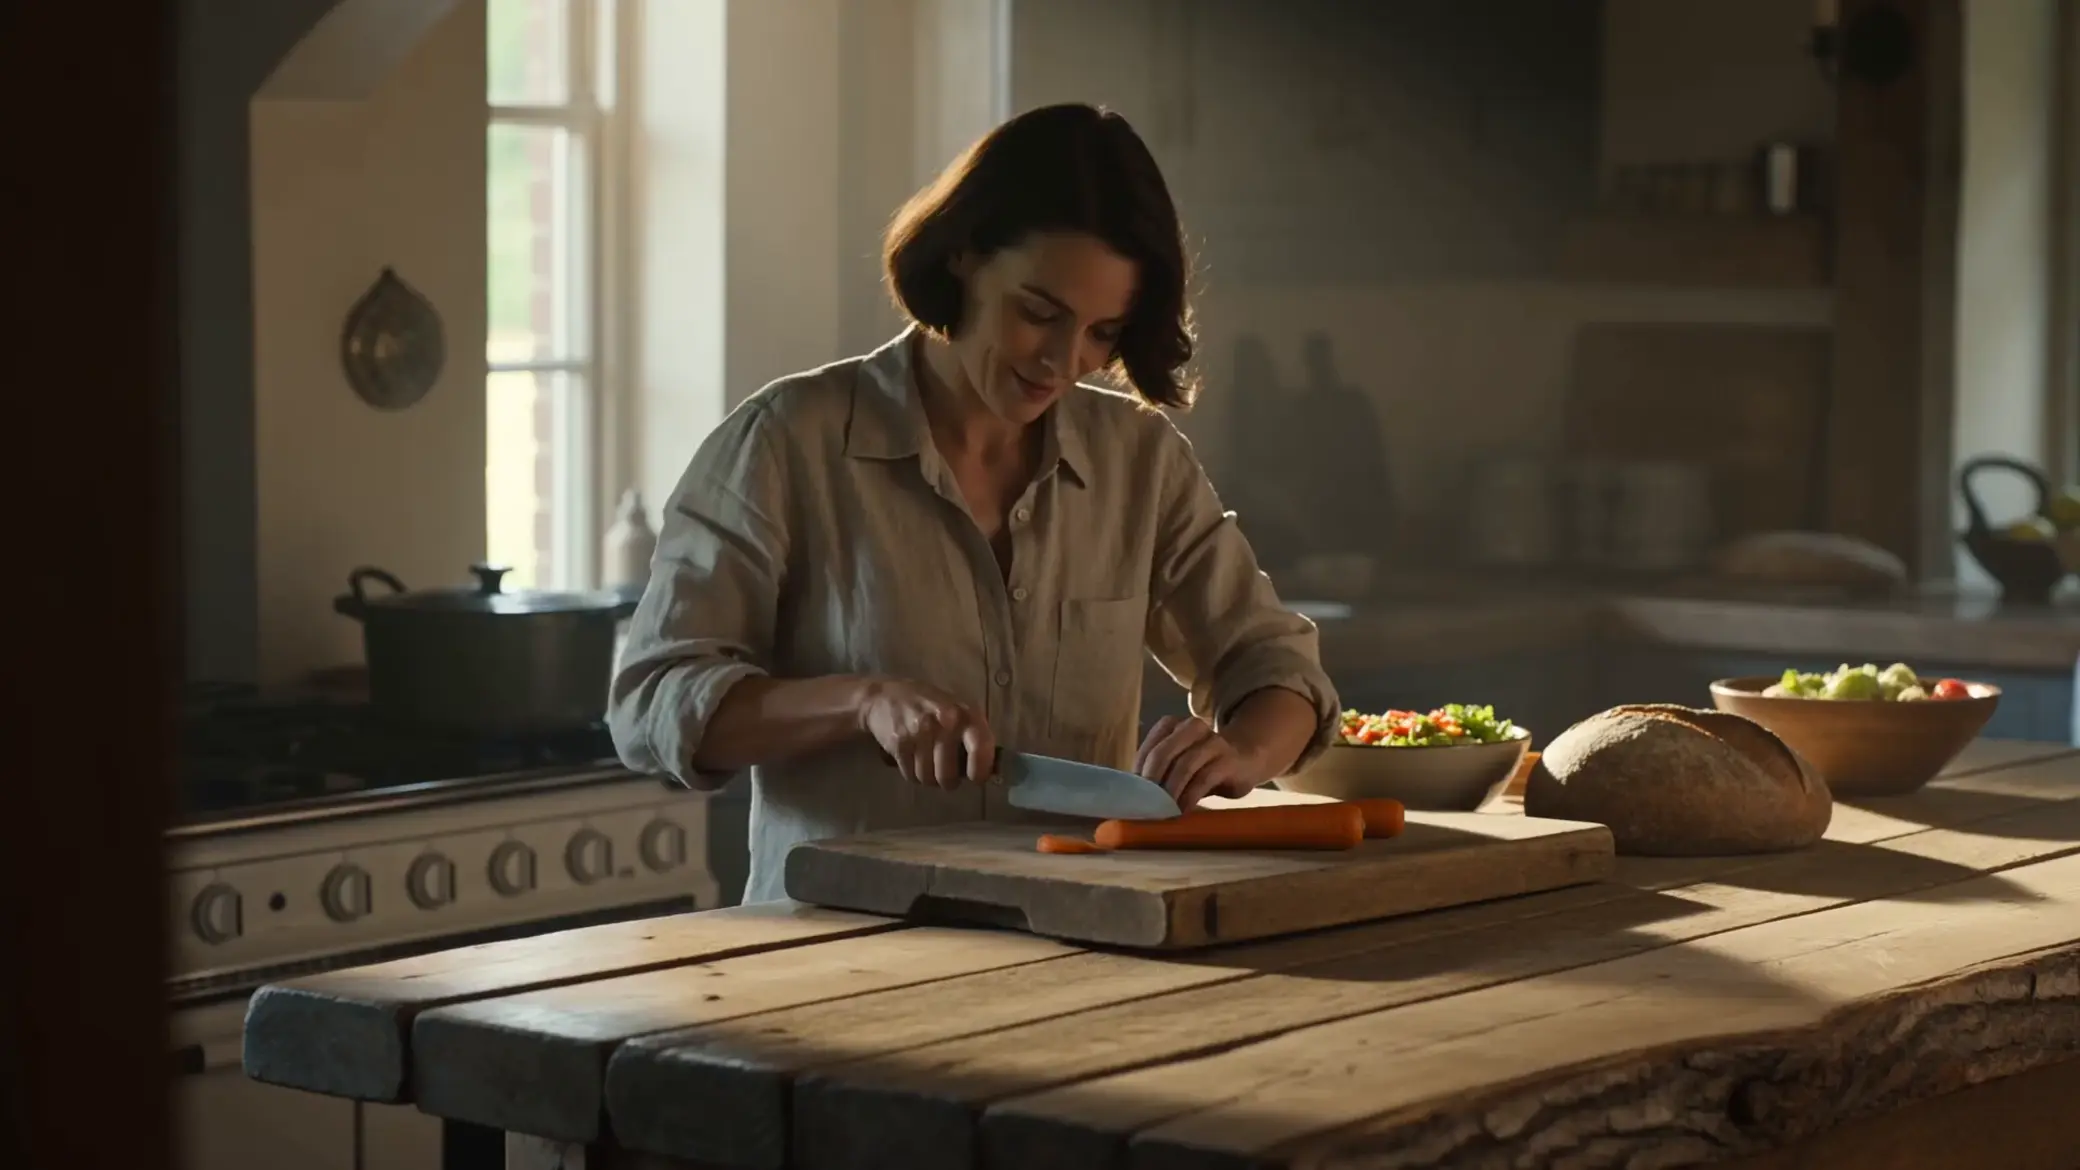
音楽を外してセリフは残す
元の動画では彼女のセリフの下にギターの曲が流れています。作り直した音ではセリフを残し、まな板で包丁を使う音を加えています。
スコアを街の音に差し替え
セリフの下にピアノの曲が流れています。作り直した音は、傘に当たる雨と街の音です。
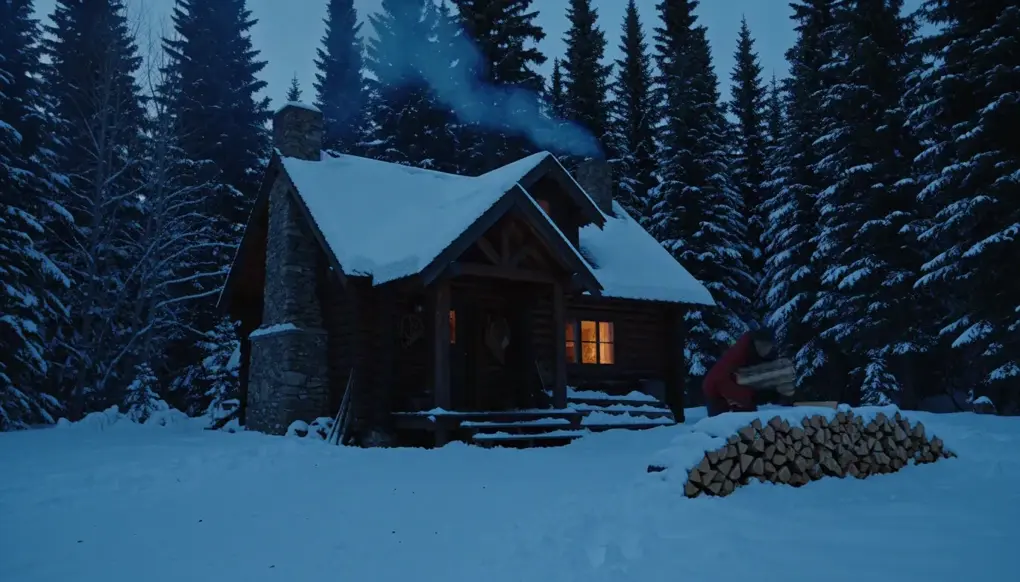
3つのショットをひとつの場所に
生成した3つのショットをつなぎました。1回の処理で、風と雪がひと続きの音になります。
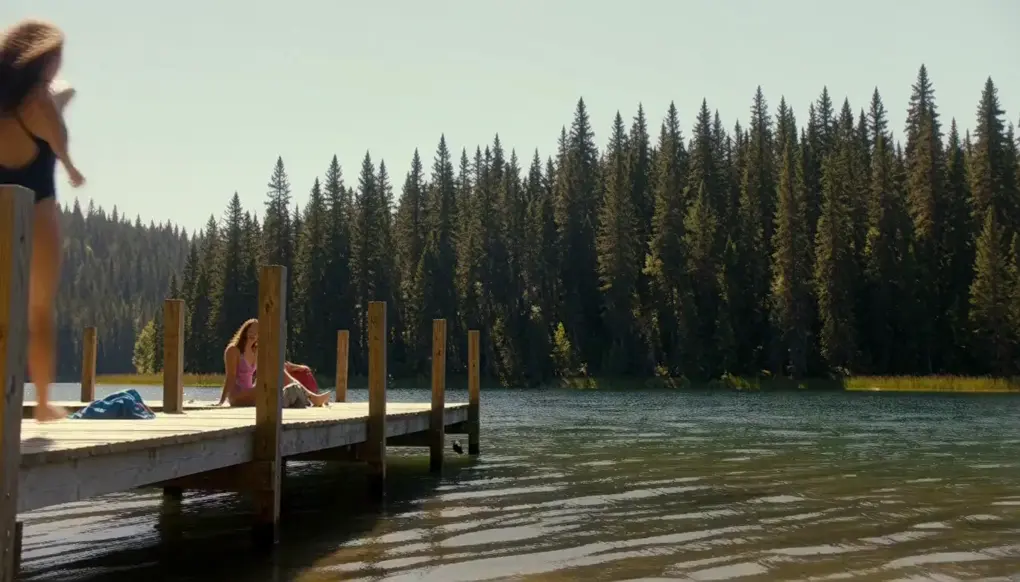
ポップな曲を外して水しぶきを入れる
ポップな曲が飛び込みの音をかき消しています。作り直した音には、板の上を走る足音、水しぶき、笑い声が入っています。
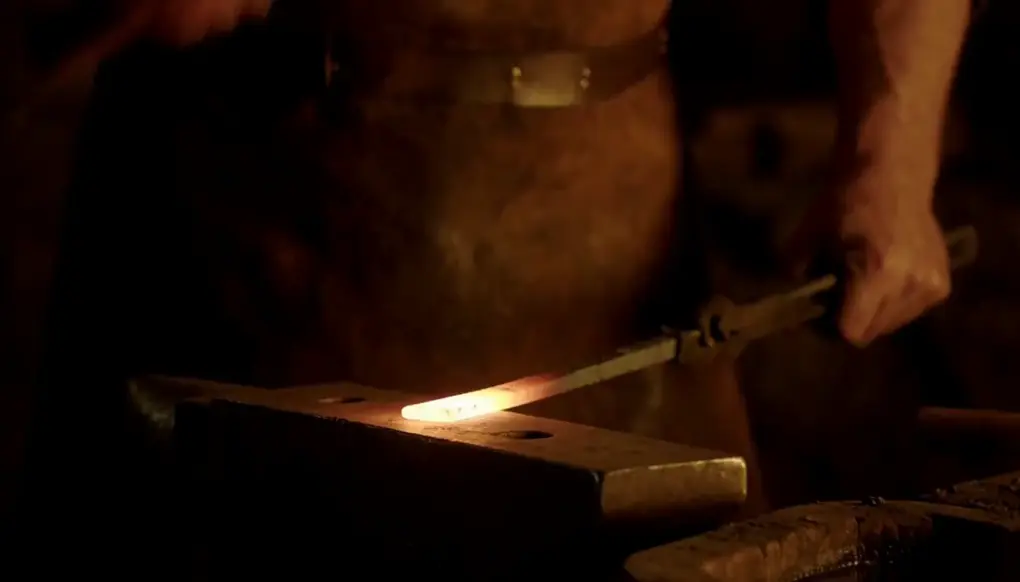
槌の音、炎、蒸気
プロンプトなしです。作り直した音は映像だけから生まれました。槌の一打ち一打ち、炎、蒸気のシューという音です。
技術仕様
10分
Mirelo のスタジオ・APIで1回あたり。それ以上は要相談
最大4つ
1回の実行で得られるバリエーションから選べます
残せる
初期設定はオン。効果音だけにしたいときはオフ
81%
Mirelo のブラインドテストで、別の動画から音を作るモデルより選ばれた割合
活用事例
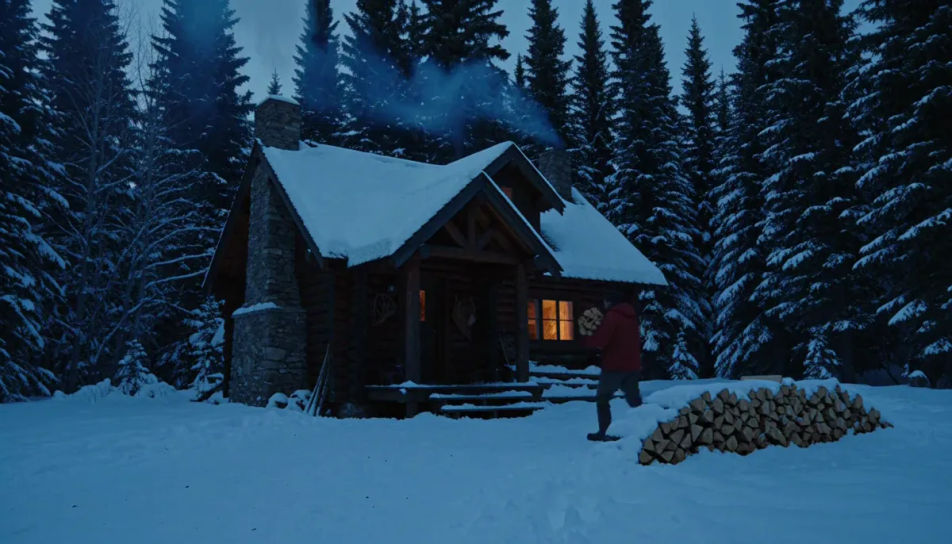
AIショートフィルム
ショットを生成し、カットを確定させたら、クリップごとに直すのではなく、作品全体の音を1回で付けます。
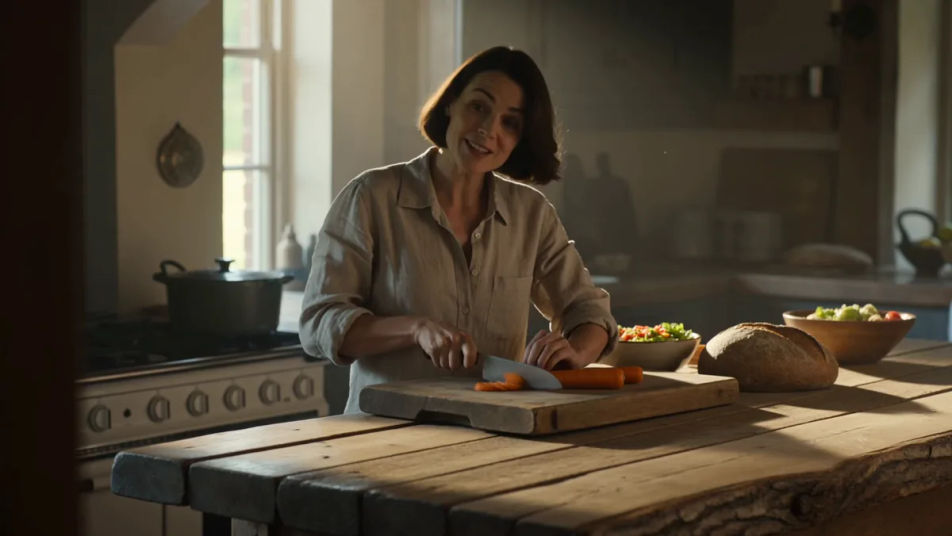
広告と商品動画
ナレーションのテイクは残し、動画モデルが選んだ音楽は外して、ライセンス済みの曲を上に重ねられます。
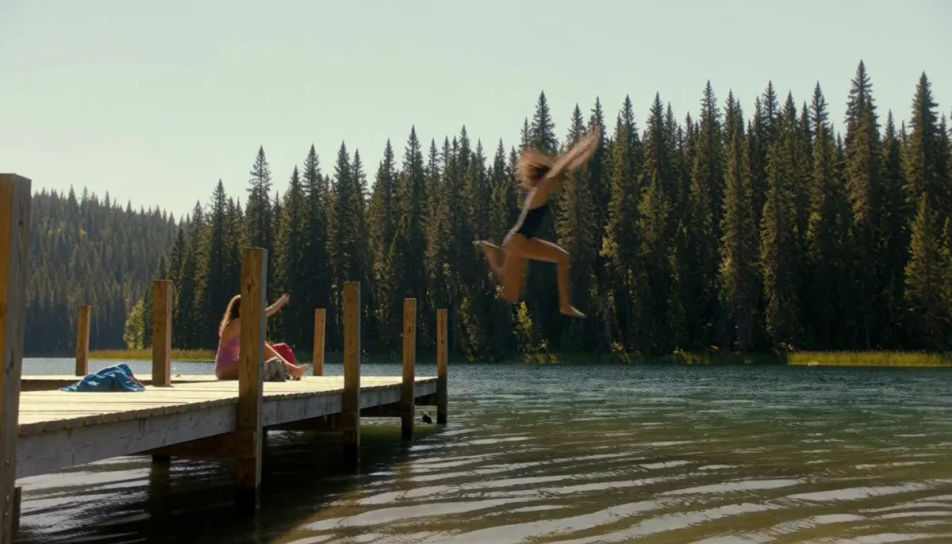
SNS向けのショート動画
短い縦型クリップに、必要なスウッシュ音、水しぶき、歓声をカットのタイミングに合わせて入れられます。
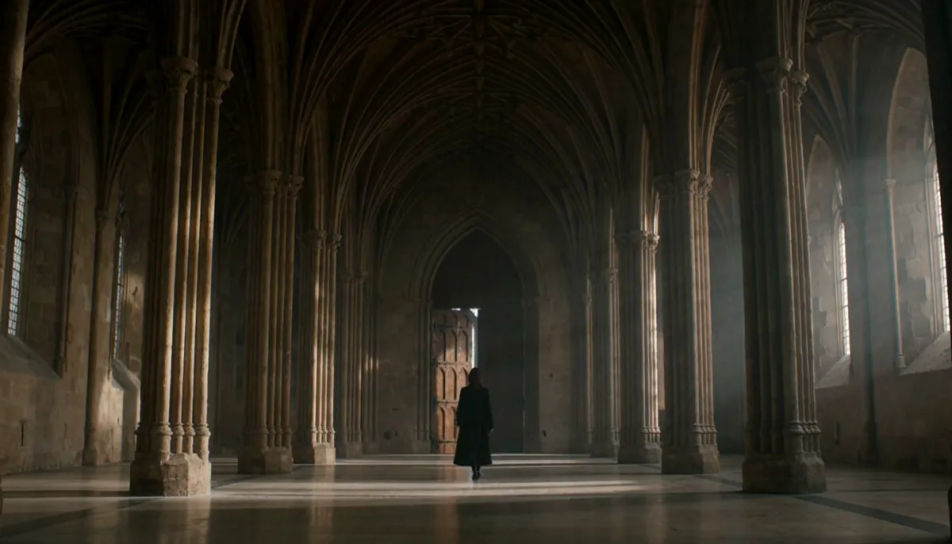
長尺の編集
10分の編集も1回で処理できます。1分目の部屋の空気感と、9分目の空気感がそろいます。
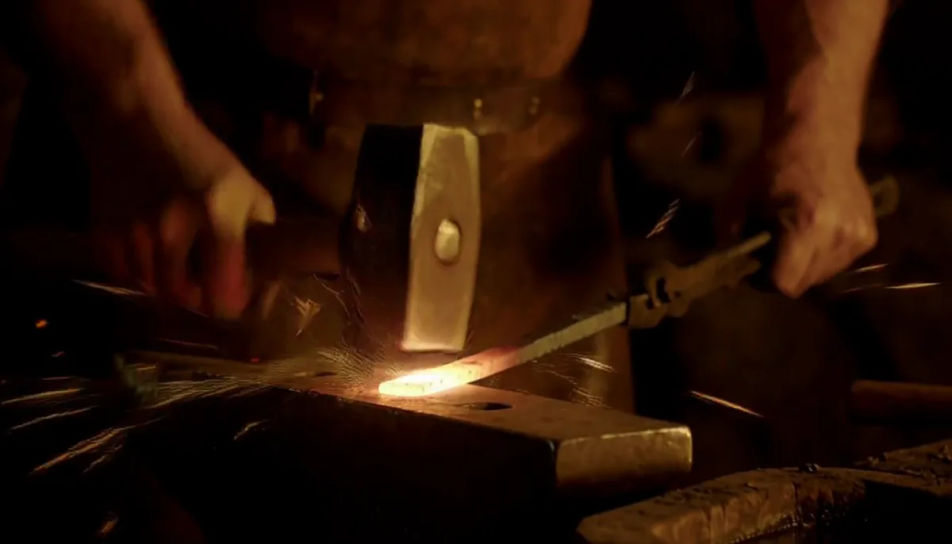
ゲームのトレーラーとシネマティック
衝撃音、火花、蒸気が動きにフレーム単位で付き、効果音ライブラリもクリップだらけのタイムラインも要りません。
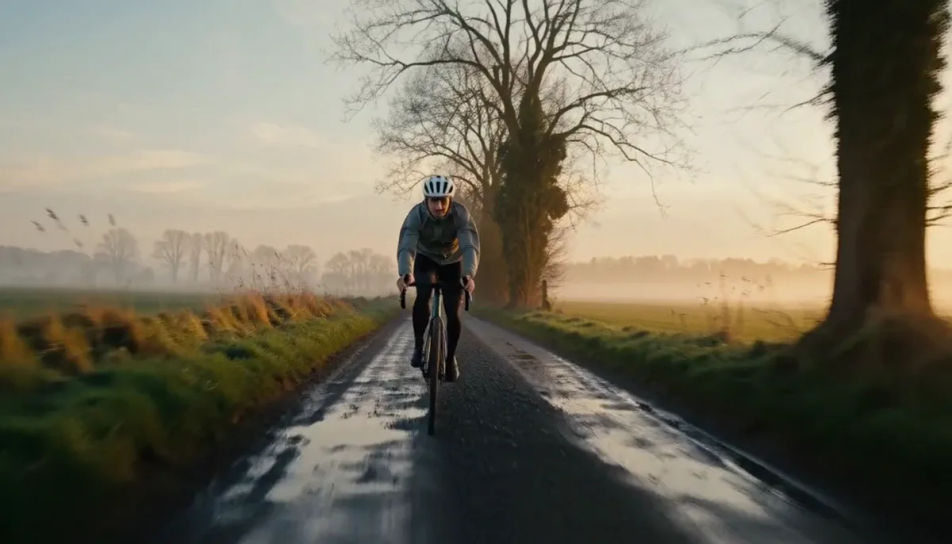
動画エージェントとプラットフォーム
人が確認しないままクリップをつなぐエージェントも、すべての動画を、ちゃんと合ったクリーンな音で仕上げられます。
概要
Mirelo SFX 2.0は、Mirelo AIが2026年10月14日に公開した、動画から音を作るモデルです。完成した動画に、画面の動きに合わせた効果音、フォーリー、環境音を付けます。セリフは演じたまま残し、動画モデルが付けた音楽は取り除きます。最長10分の編集を、1回の処理で通せます。
Mirelo SFX 2.0の違い
Mirelo SFX 2.0は、映像から出発します。効果音ライブラリやテキストから音を作るモデルは動画を見ないので、効果音を探し、切り出し、位置を合わせる作業が手作業で残ります。Mirelo SFX 2.0は動き、タイミング、場所を読み取り、すでにあるセリフの周りに合う音を作ります。Mireloのブラインドのリスニングテストでは、別の動画から音を作るモデルとの比較のうち81%で、Mirelo SFX 2.0の音が選ばれました(出典)。
MorphicでのMirelo SFX 2.0
Mirelo SFX 2.0のMorphicへの対応は近日予定です。それまでは、Sonilo SFXが同じ役割を担います。Copilotを開き、動画を添付して、セリフを残したまま新しい音を付けるよう依頼してください。このページのクリップはすべてこの方法で作りました。よい結果を得るコツは、Mirelo SFX 2.0のガイドをご覧ください。
シンプルな料金体系
今すぐ無料で始めて、いつでもアップグレードまたはキャンセルできます。
Basic
2400 月 クレジット
1 ユーザーのみ
すべてのモデル
ワークフロー
Standard
3625 月 クレジット
1 ユーザーのみ
すべてのモデル
ワークフロー
Pro
6350 共有 月 クレジット
1 ユーザー
すべてのモデル
ワークフロー
Max
24650 共有 月 クレジット
1 ユーザー
すべてのモデル
ワークフロー
Enterprise
より高い制限のために
カスタム
料金と請求条件

Free
気軽に試したい方に
$0
ずっと無料
よくある質問
Mirelo SFX 2.0をもっと知る
Mirelo SFX 2.0のガイド、プロンプト、比較。
その他のモデル
Morphicのモデルカタログをさらに見る。
OmniHuman 2.0
ByteDance
ByteDanceの音声駆動ヒューマン動画モデル。 写真1枚と音声1本で、5分をワンカットに。
Fish Audio Drama 3
Fish Audio
Fish Audioでいちばん表現力のある音声モデル。 演技を、語の単位まで指示できます。
Vidu Q4
Shengshu Technology
Shengshuの最新動画モデル。参照画像12枚と声3本を1クリップで保ち、ネイティブ音声つきで540pから4Kまで。
Nano Banana 2.1
Google DeepMind
Google DeepMindの新しいFlash画像モデル。 デザイン、編集、キャラクターの安定が向上。