OmniHuman 2.0
ByteDance 提供
ByteDanceの音声駆動ヒューマン動画モデル。
写真1枚と音声1本で、5分をワンカットに。
主な機能
仕様はBytePlusが2026年10月15日の発表で示した内容です。OmniHuman 2.0はまだMorphicで使えないため、このページのクリップは、写真1枚と音声1本から最長5分のトーキングビデオを作れるVeed Fabricで、Morphic上で制作しました。
技術仕様
5分
連続1ショット(BytePlus発表)
60秒
2.0以前のワンカットの上限
写真 + 音声
出演者の画像1枚とトラック1本
任意のトラック
話し声、音楽、会話
活用事例
講座とレッスン
オンライン講座1回分をワンカットで。4分目でも1分目と同じ講師の見た目を保てるので、編集でつなぎ合わせる作業が要りません。
解説動画とハウツー動画
先にナレーションを録音または生成しておき、写真1枚に語らせます。間の取り方や強調がつくので、視聴者が最後まで見やすくなります。
音楽パフォーマンス動画
歌唱トラックを渡すと、歌詞だけでなく、伸ばす音、息づかい、曲の感情まで顔が表現します。
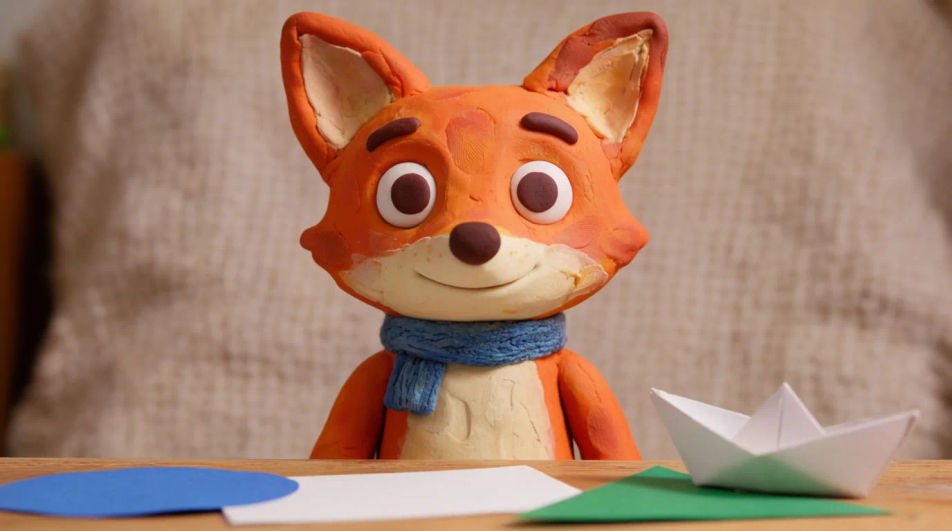
マスコットとキャラクター
企業のマスコット、クレイのキャラクター、イラストの主人公に声を与えて、広告、子ども向けコンテンツ、チャンネルのオープニングに使えます。
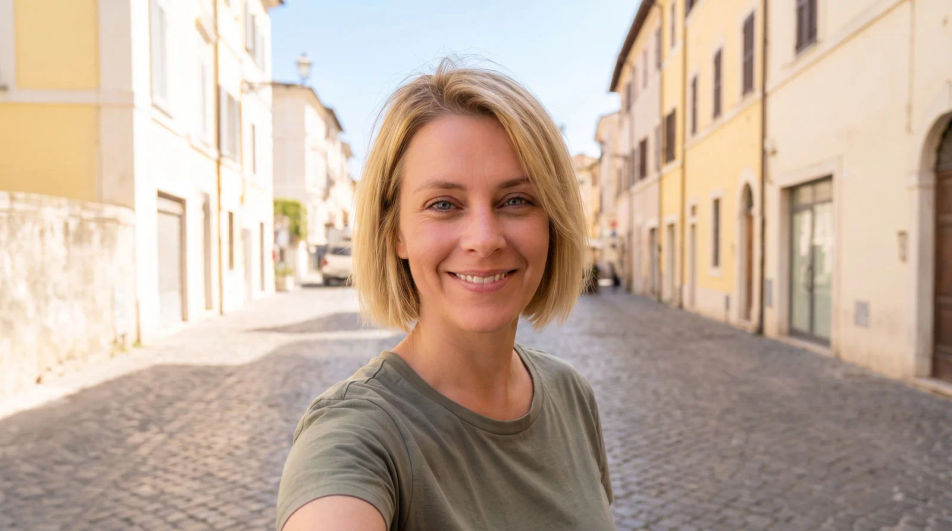
SNS向けの縦型動画
自撮り風の写真1枚とボイストラックから、リールやショート向けの縦型トーキングクリップを用意できます。投稿に使える形で仕上がります。
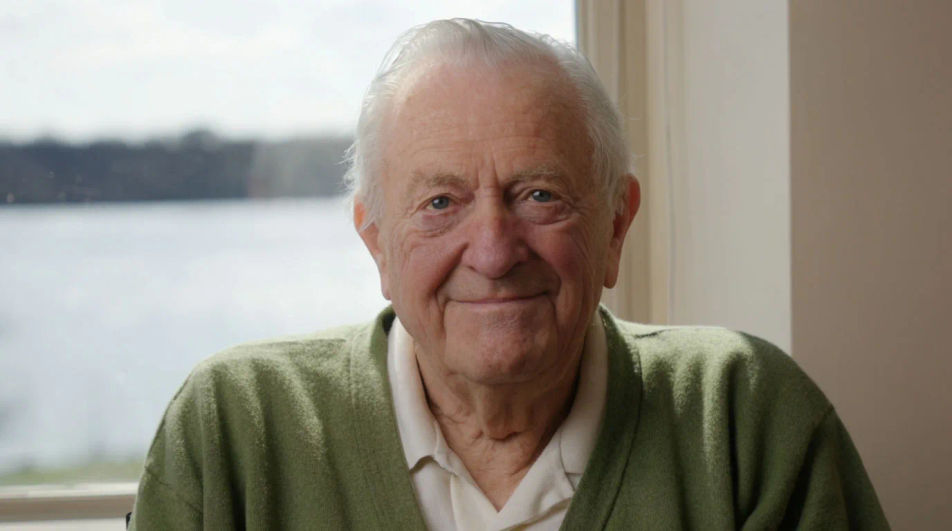
朗読とポッドキャスト
長い語りでも、静かな盛り上がりから落ちまでのリズムが保たれます。出演者が1分ごとにリセットされることもありません。
概要
OmniHuman 2.0は、ByteDanceが2026年10月15日にBytePlusで公開した音声駆動のヒューマン動画モデルです。写真1枚と音声1本から、その人物がトラックを演じる動画を作ります。口の形を合わせるだけでなく、音声のトーン、感情、言葉まで読み取るのが特長です。1ショットは従来の60秒から最長5分に延び、つなぎ合わせも要りません(出典)。
OmniHuman 2.0の違い
多くのトーキングフォトのモデルは、音に合わせて口を動かします。OmniHuman 2.0は、台詞の言い方に耳を傾けます。寝かしつけのささやき、コーチの掛け声、歌の伸ばす一音は、同じ種類の入力でも別々の演技として出力されます。ワンカットが長くなった点も同じくらい重要です。講座も、語りも、1曲まるごとも1ショットで通るので、顔や光、背景が切り替わるつなぎ目が生まれません。
MorphicでのOmniHuman 2.0
OmniHuman 2.0のMorphicへの対応は近日予定です。それまでは、Veed Fabricが同じ役割を担います。Copilotを開き、写真と音声を添付して、トーキングビデオを依頼してください。このページのクリップはすべてこの方法で作りました。よい結果を得るコツは、OmniHuman 2.0のガイドをご覧ください。
シンプルな料金体系
今すぐ無料で始めて、いつでもアップグレードまたはキャンセルできます。
Basic
2400 月 クレジット
1 ユーザーのみ
すべてのモデル
ワークフロー
Standard
3625 月 クレジット
1 ユーザーのみ
すべてのモデル
ワークフロー
Pro
6350 共有 月 クレジット
1 ユーザー
すべてのモデル
ワークフロー
Max
24650 共有 月 クレジット
1 ユーザー
すべてのモデル
ワークフロー
Enterprise
より高い制限のために
カスタム
料金と請求条件

Free
気軽に試したい方に
$0
ずっと無料
よくある質問
OmniHuman 2.0をもっと知る
OmniHuman 2.0のガイド、プロンプト、比較。
その他のモデル
Morphicのモデルカタログをさらに見る。
Mirelo SFX 2.0
Mirelo AI
Mirelo AIの動画から音を作るモデル。 映像に新しい音を、セリフはそのままに。
Fish Audio Drama 3
Fish Audio
Fish Audioでいちばん表現力のある音声モデル。 演技を、語の単位まで指示できます。
Vidu Q4
Shengshu Technology
Shengshuの最新動画モデル。参照画像12枚と声3本を1クリップで保ち、ネイティブ音声つきで540pから4Kまで。
Nano Banana 2.1
Google DeepMind
Google DeepMindの新しいFlash画像モデル。 デザイン、編集、キャラクターの安定が向上。