OmniHuman 2.0
由 ByteDance 提供
ByteDance 推出的音频驱动人像视频模型。
一张照片,一段音频,一镜到底5分钟。
核心功能
规格均来自 BytePlus 2026年10月15日的发布帖。OmniHuman 2.0 尚未上线 Morphic,所以本页的视频都是在 Morphic 上用 Veed Fabric 做的。Fabric 现在就能把一张照片和一段音频变成最长5分钟的说话视频。视频里的配音为英文。
技术规格
5 分钟
一镜到底,数据来自 BytePlus
60 秒
2.0 之前的单镜头上限
照片 + 音频
一张演员图像,一段音频
任意音频
语音、音乐或对话
应用场景
课程与讲课视频
一节完整的课一镜到底,讲师在第四分钟和第一分钟看上去一样,不用再剪辑拼接。
讲解与教程视频
先录好或生成口播旁白,再让一张照片把它讲出来。停顿和重音都留着,观众才愿意看下去。
音乐演出视频
给它一段演唱音频,脸上会带出长音、换气和歌里的情绪,而不只是对上歌词。
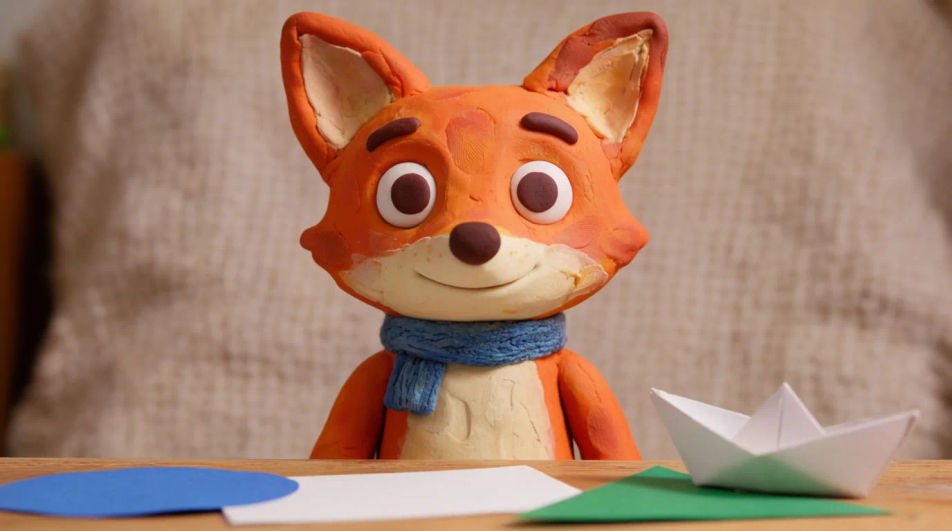
吉祥物与角色
让品牌吉祥物、黏土角色或插画主角开口说话,用在广告、儿童内容和频道片头。
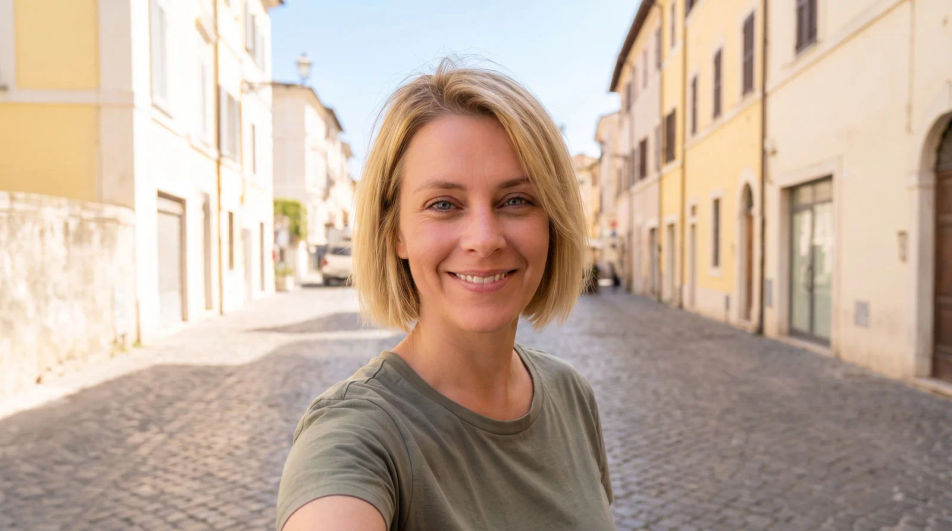
创作者与社交视频
只用一张自拍式照片和一段人声,就能做出竖版口播短片,做好即可发布。
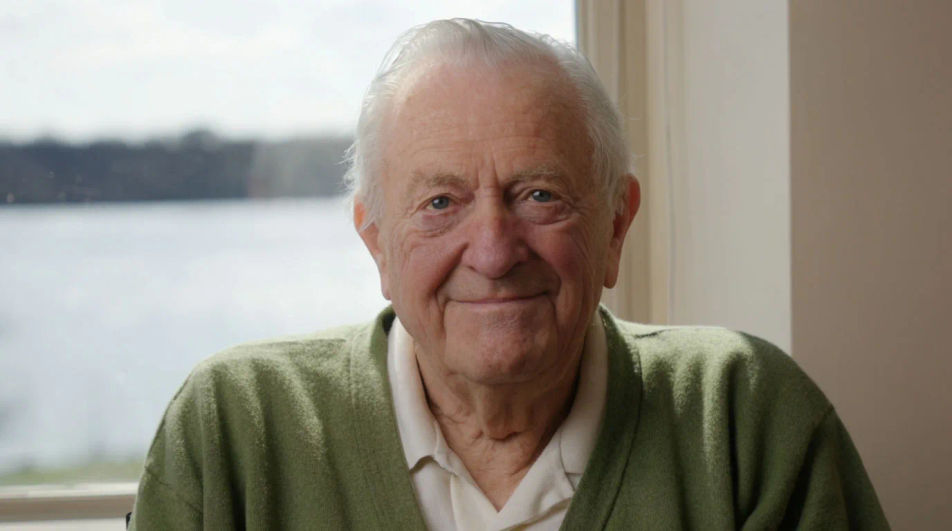
故事与播客
长篇讲述也能保住节奏,从安静的铺垫到最后的笑点,演员不必每过一分钟就重新来过。
概述
OmniHuman 2.0 是 ByteDance 推出的音频驱动人像视频模型,2026年10月15日通过 BytePlus 发布。它把一张照片和一段音频变成这个人演出该音频的视频。模型读的是音频里的语气、情绪和字词,而不只是对上口型。单个镜头现在最长5分钟,此前是60秒,也不再需要拼接(来源)。
OmniHuman 2.0 有什么不同
多数说话照片模型只让嘴跟着声音动。OmniHuman 2.0 还会听一句话是怎么说的。同样是一张照片,睡前轻声的故事、教练的一声大喊、歌里的一个长音,会演出三种完全不同的表演。
更长的单镜头同样重要。对做课程、口播和短视频的创作者来说,最实际的变化是长度:一节课、一首歌、一段完整的故事,不必再切成60秒一段。整段作为一个镜头跑完,脸、光线和背景就没有地方可以突然变样。
OmniHuman 2.0 在 Morphic 上
OmniHuman 2.0 即将上线 Morphic。在此之前,可以先用 Veed Fabric:打开 Copilot,附上一张照片和一段音频,让它生成说话视频。本页所有视频都是这样做的。想用好它,请看 OmniHuman 2.0 指南。
简单定价
今天就免费开始,随时可以升级或取消。
Basic
2400 每月 信用
1 个用户
所有模型
工作流
Standard
3625 每月 信用
1 个用户
所有模型
工作流
Pro
6350 共享 每月 信用
1 用户
所有模型
工作流
Max
24650 共享 每月 信用
1 用户
所有模型
工作流
Enterprise
更高的限制
自定义
定价和账单条款

Free
供随意体验
$0
永久免费
常见问题
进一步了解 OmniHuman 2.0
OmniHuman 2.0 的指南、提示词与对比。
其他模型
浏览 Morphic 模型目录中的更多模型。