多模态

Gemini Omni Flash 1.2

由 Google DeepMind 提供

Google 的视频模型,单次长达 15 秒。
整段镜头都能改,每秒还便宜 30%。
Gemini Omni Flash 1.2

核心功能

技术规格

Gemini Omni

Omni Flash 的第三个版本,模型 ID 为 gemini-omni-1.2-flash

3 至 15 秒

以整秒计,默认 10 秒,延长后可达 30 秒

最高 4K

360p 和 720p 为原生输出,1080p 与 4K 由放大得到

每秒约 $0.07

按 720p 计,比 Omni Flash 1.1 低约 30%

6 张图片

最多 2 个角色,每人 3 张,另可加 3 秒片段

原生

对白、音效和音乐在同一次生成中完成

16:9、9:16

成片之后,可以通过追问切换

SynthID

每条生成的视频都带有不可见的溯源标记

应用场景
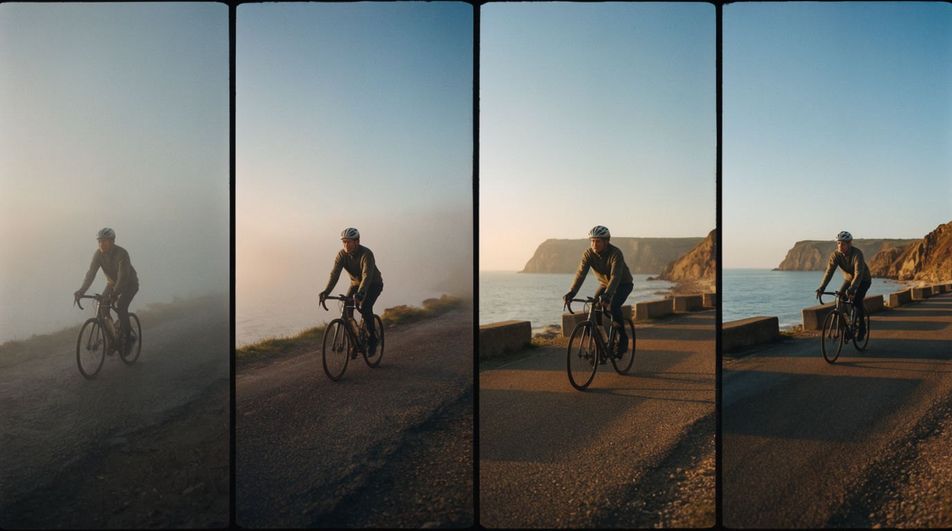
四格分镜条:一名骑行者沿海岸公路,从晨雾中骑入明亮的阳光

15 秒完整镜头

一次生成就是完整的一拍:靠近、转身、抵达。不必再把 10 秒的片段一段段延长。
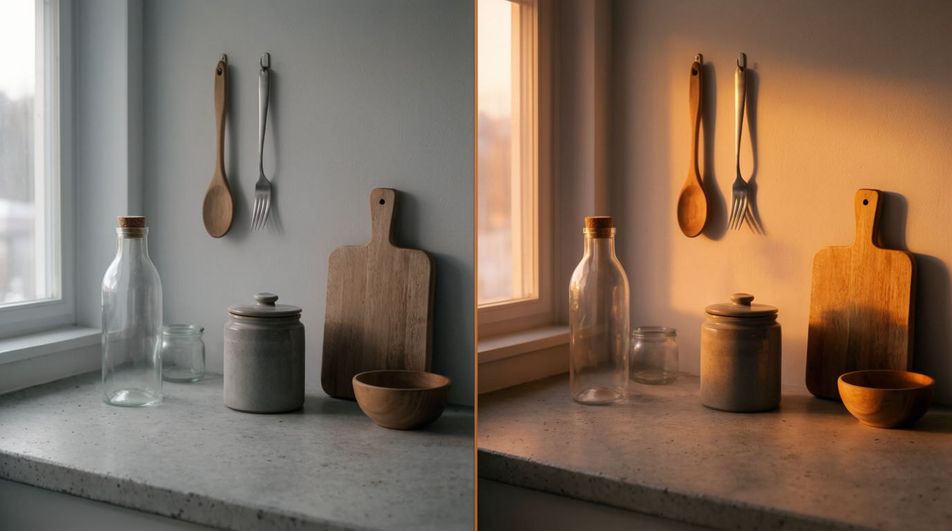
同一个厨房窗台的分屏画面:左边是灰蒙蒙的清晨光线,右边是温暖的黄昏

打字就能改

把镜头交给它,再说出改动:重新打光、换掉罐子、改写标签。画面的其余部分保持不动。
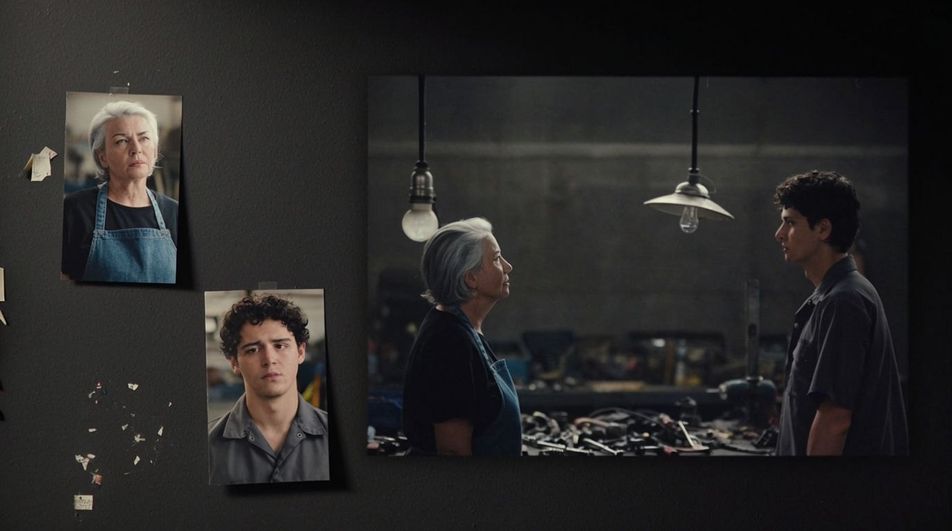
两位虚构主持人的参考卡片,旁边是他们隔着工作台交谈的成片双人镜头

两个角色都稳住

两个人各给三张照片,脸和服装就能锁定。从第一条镜头到最后一次修改,两位主角始终认得出来。
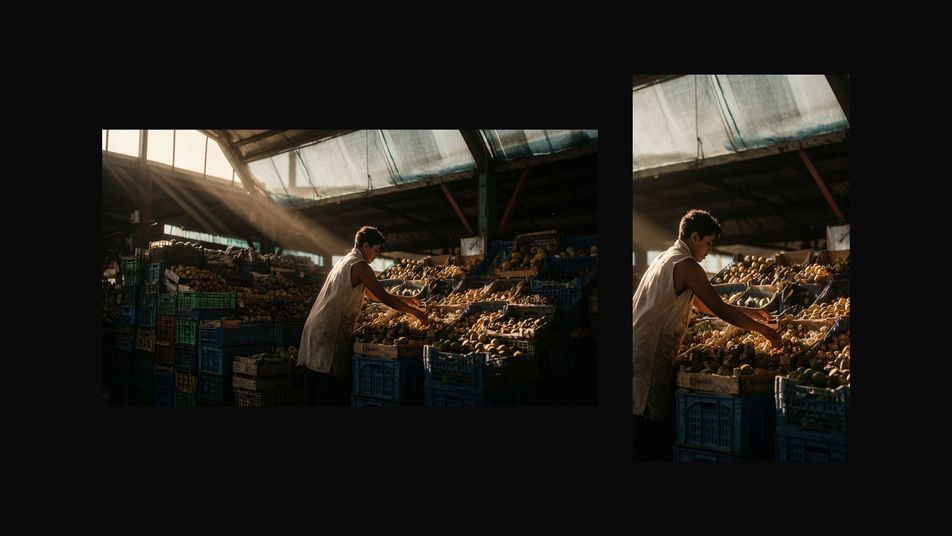
同一个集市摊位的镜头,左边是横向宽画幅,右边是竖向裁切版本

一条镜头,两种画幅

横屏版定稿后,再要竖屏版就行。画幅变成一句追问,不用重新生成。横屏适合长视频平台,竖屏适合抖音和小红书。
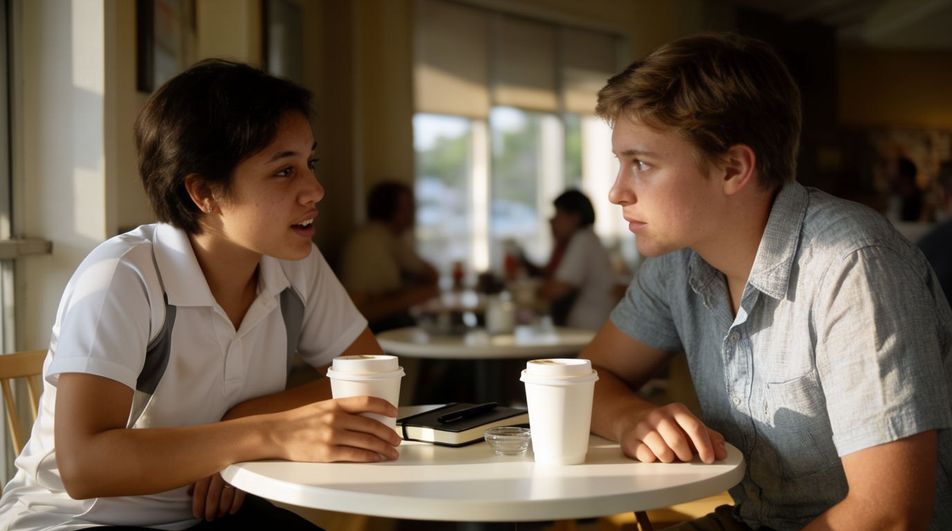
两位虚构的同事在午后的光线里,隔着咖啡馆的桌子交谈

两个声音的场景

把两个人的台词都写出来,每句话就会落到正确的人嘴里,口型对得上。之后再改画面,声线也不会跑偏。
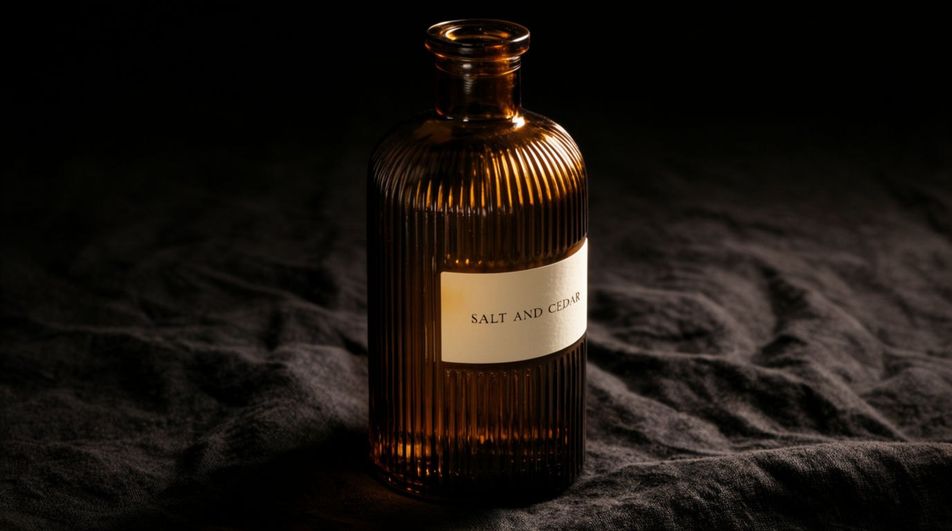
一只带棱纹的琥珀色瓶子,标签上是虚构的字标,柔和的影棚主光照亮

包装字样不走样

把自家的包装盒当参考图放进去,镜头转动时字样依然清晰,不会糊成相似的假字。做电商详情页和商品短视频时尤其好用。

提示词示例

15 秒一镜到底

15 秒一个镜头:黄昏的江南水乡,一位点灯人沿着河道慢慢走过

Edit prompt

双人对话

两位同事在温暖的厨房里,为火锅底料的配方争执起来,台词互相打断

Edit prompt

运镜

一气呵成的摇臂镜头,从雨后湿漉漉的老街上升,直到一扇亮灯的窗口

Edit prompt

画面文字

手绘招牌上逐个字母写出 COLD BREW

Edit prompt

产品旋转

一只国风茶叶罐在深色亚麻布上缓缓转动,标签清晰可读

Edit prompt

声音主导的镜头

特写:茶炉上的水壶渐渐烧开,每一声滴答和嗡响都听得清

Edit prompt

概览

Gemini Omni Flash 1.2(Google 官方写作 Gemini Omni 1.2 Flash)是 Google DeepMind 多模态视频模型的第三个版本,发布于 2026 年 11 月 5 日。基本用法没有变:输入提示词、图片或短片段,输出带同步音频的视频,之后还可以用追问接着修改同一条镜头。变化集中在两处:一次生成能装下多长的场景,以及要花多少钱。

Gemini Omni Flash 1.2 的新变化

单次生成现在最长 15 秒,从 3 秒起按整秒设定,而 1.1 最长只有 10 秒。对话式编辑覆盖整段视频,所以换产品、改天气,或者要一份竖屏版本,都只是对已定稿镜头的追问。参考素材围绕人物组织:每次请求 6 张图,其中最多 2 个角色,每个角色 3 张。价格方面,Google 列出的 720p 为每秒约 0.07 美元,比 1.1 低约 30%,360p 草稿更便宜。

更安静的进步在于“稳”。据 Google 介绍,人脸、服装、包装字样和色彩在镜头中更稳定,连续运镜里无意的切换减少,对白更自然,口型更清晰,也能同时处理多个说话人。Google 同时指出三处尚未完善:高速运动的体育画面、剧情急转的脚本,以及复杂的物理效果。

15 秒改变了提示词的写法

10 秒只是一个片段,所以 1.1 的提示词往往只写一个动作,其余靠延长补上。15 秒则是有头有尾的一拍,提示词可以带一点结构:靠近、转身、抵达。场景更长时仍可延长,每轮 3 至 10 秒,总长最多 30 秒,并以片尾最后 10 秒为上下文。实际的区别在于,您需要延长的次数少多了。

Gemini Omni Flash 1.2 与 Morphic

Morphic 目录里暂时还没有 Gemini Omni Flash 1.2。不过 Gemini Omni Flash 1.1 已在视频模型选择器里,与 Veo 3.1、Seedance 2.5、Kling 等模型排在一起。这个系列的提示词写法和原生音频现在就能用,同一份需求还能跑多个模型,结果并排放在 Canvas 上比较。本页所有示例都是在 Morphic 上用最接近的在线模型做的,而不是 1.2。Google 已表示,从 2026 年 12 月 3 日起,其自家 API 上对 1.1 的请求会转到 1.2。想学提示词写法,请读 Gemini Omni Flash 1.2 使用指南;想直接拿现成起点,请看 Gemini Omni Flash 1.2 提示词库;想了解升级了什么,请看 1.2 与 1.1 对比;也可以直接打开 Gemini Omni Flash 1.2 AI视频生成器。

简单定价

今天就免费开始,随时可以升级或取消。

Basic

$19/ 月
账单金额为 $228 每年

2400 每月 信用

1 个用户

所有模型

工作流

Standard

$24/ 月
账单金额为 $288 每年

3625 每月 信用

1 个用户

所有模型

工作流

Pro

$45/ 月
账单金额为 $540 每年

6350 共享 每月 信用

1 用户

+ 最多 4 人额外付费可增加

所有模型

工作流

Max

$170/ 月
账单金额为 $2040 每年

24650 共享 每月 信用

1 用户

+ 最多 9 人额外付费可增加

所有模型

工作流

Enterprise

更高的限制

自定义

定价和账单条款

大容量信用
自定义席位限制
所有模型
工作流
Pricing Gradient

Free

供随意体验

$0

永久免费

最多 20 积分
仅1个用户
部分模型
工作流

常见问题

Gemini Omni Flash 1.2 是什么?
Gemini Omni Flash 1.2(Google 官方写作 Gemini Omni 1.2 Flash)是 Google 多模态视频模型的第三个版本,2026 年 11 月 5 日发布。它能根据文字、图片和参考片段生成带同步原生音频的视频,还能用自然语言追问来编辑和延长素材。1.2 版把单次生成拉到 15 秒,编辑可以作用于整段视频,每秒价格约低 30%。
Gemini Omni 1.2 Flash 多少钱?
Google 公布的价格是 720p 每秒约 0.07 美元,所以 15 秒的片子约 1.04 美元,10 秒的约 0.70 美元。360p 草稿每秒约 0.023 美元,1080p 约 0.104 美元,4K 约 0.209 美元,后两档都由放大得到。这些是模型提供方的 API 价格,Morphic 按自己套餐中的积分计费。
Gemini Omni Flash 1.2 的视频最长多少秒?
单次生成可设 3 至 15 整秒,默认 10 秒。首尾帧插值和每一轮延长各为 3 至 10 秒,延长之后总长最多 30 秒。延长只能接在片尾,并以最后 10 秒为上下文,所以不能往前加镜头,也不能拉长中间的部分。
Gemini Omni Flash 1.2 支持中文吗,有哪些短板?
Google 说明,英文是画面文字和对白中完整支持的语言,其他语言的表现并不稳定。因此中文台词和招牌字样请先用 360p 草稿试一遍,确认无误再定稿。Google 还列出三个仍在改进的方面:高速运动的体育画面、剧情急转的脚本,以及复杂的物理效果。另外,在欧洲经济区、瑞士和英国,不能编辑或延长您自己上传的素材。
Gemini Omni Flash 1.2 和 1.1 相比有什么新变化?
主要有四点。单次生成从 10 秒提高到 15 秒,以整秒设定,默认仍是 10 秒。对话式编辑可以覆盖整段视频,包括切换画幅。参考素材改为围绕角色组织,最多 2 个人,每人 3 张图。价格也降了:Google 列出的 720p 为每秒约 0.07 美元,1.1 约为 0.10 美元。
Gemini Omni Flash 1.2 输出什么分辨率?
共四档,画幅为 16:9 或 9:16:360p、默认的 720p,以及由放大得到的 1080p 和 4K。按价格倒推,比较划算的做法是先用 360p 反复试,用 720p 定下镜头,最后只放大一次到交付分辨率,而不是每次试错都付 4K 的钱。
Gemini Omni Flash 1.2 的对话式编辑怎么用?
每次追问都是在上一版结果上修改,而不是从头来过,模型会在两轮之间保留场景,现在这个范围已是完整的 15 秒。指令越短越好用:说清要改的那一处,再注明其余保持不变。换产品、改天气或灯光、切换画幅,都是追问,不需要重新生成。
Gemini Omni Flash 1.2 接受哪些参考素材?
每次请求最多 6 张参考图,涉及人物时,最多 2 人、每人 3 张。参考视频的数量取决于成片长度:11 至 15 秒的片子可带 1 段不超过 3 秒的参考视频,3 至 10 秒的可带最多 3 段。参考视频只用于新生成,不能用于编辑和延长,其中的音频也会被忽略。
Gemini Omni Flash 1.2 会生成音频和对白吗?
会。声音和画面在同一次生成中一起输出,包括带口型的对白、音效、环境声和音乐。Google 称 1.2 的对白更自然,口型更清晰,还能同时处理多个说话人,所以双人对话是合理的需求。请把声音写进提示词,因为提示词里没提声音,模型就会自己选一条音轨。
可以上传自己的音频,或在 Gemini Omni Flash 1.2 里编辑声音吗?
就现在的 API 而言还不行。Google 的发布文章把音频提示(包括一小段声音参考)列为模型输入,但开发者文档写明当前 API 版本不支持音频输入,也不支持编辑声音。目前请把声音当作用文字来指挥的部分,并留意文档何时开放这项输入。
可以在 Morphic 上用 Gemini Omni Flash 1.2 吗?
暂时还不行。Morphic 视频模型目录里目前有 Gemini Omni Flash 1.1,同一系列的提示词写法和原生音频都可以先用起来,它与 Veo 3.1、Seedance 2.5、Kling 一起排在同一个 Canvas 上。Google 已表示,从 2026 年 12 月 3 日起,其自家 API 上对 1.1 的请求会转到 1.2,所以新模型很快就会接上围绕旧版搭好的一切。
