Seed Audio 1.5 AI音频生成器

ByteDance 的整场景音频模型。 对白、配乐、音效分轨输出。

所有音频模型

一个工作空间

不只是人声,而是整个场景

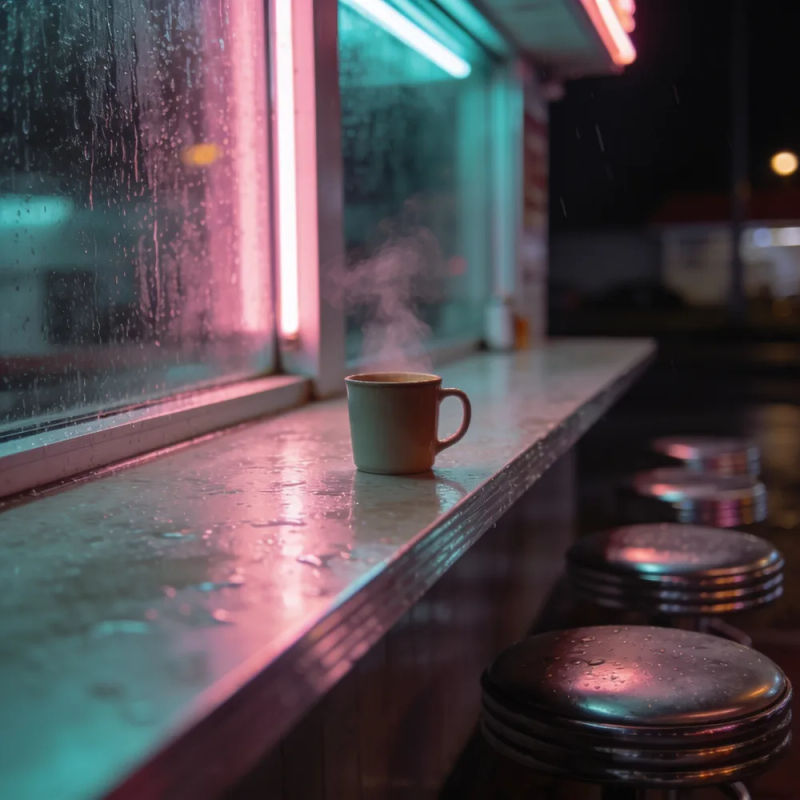
深夜餐馆的柜台上放着一杯冒着热气的马克杯,窗上有雨
深夜餐馆
[Diner at 2 a.m., a fridge hums, rain outside.] Waitress (50s, kind): "Coffee's on the house tonight, hon." Driver (tired, grateful): "You're an angel. Long road tonight."
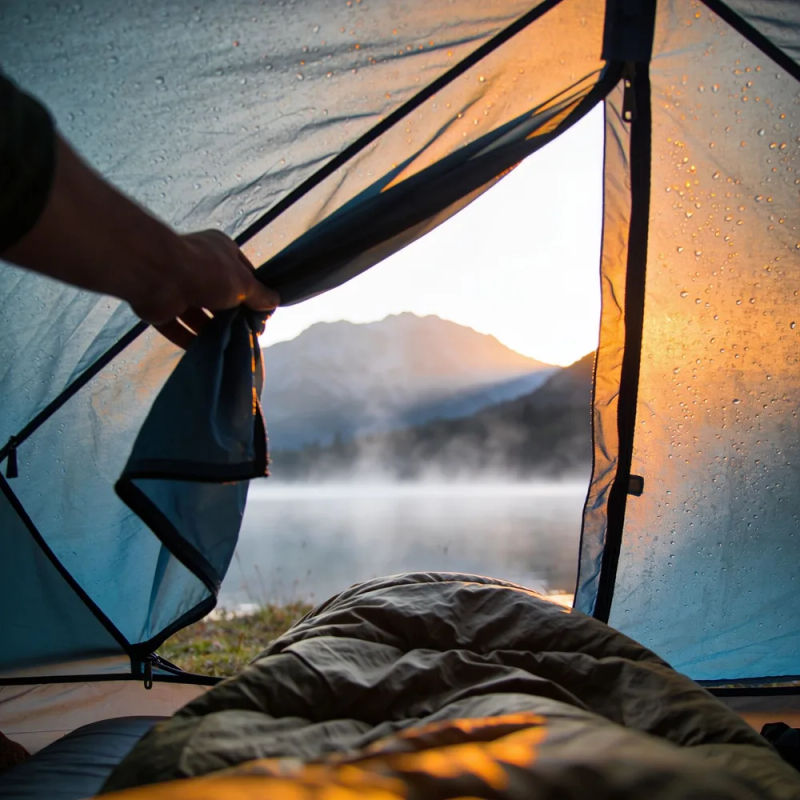
清晨第一缕光里,一只手拉开帐篷门,门外是雾气笼罩的山间湖泊
露营广告
[Warm acoustic guitar builds.] Narrator (warm, smiling): "Weekend plans? Pack light. We've got the tent." [0:08] The music swells and a tent zipper closes.
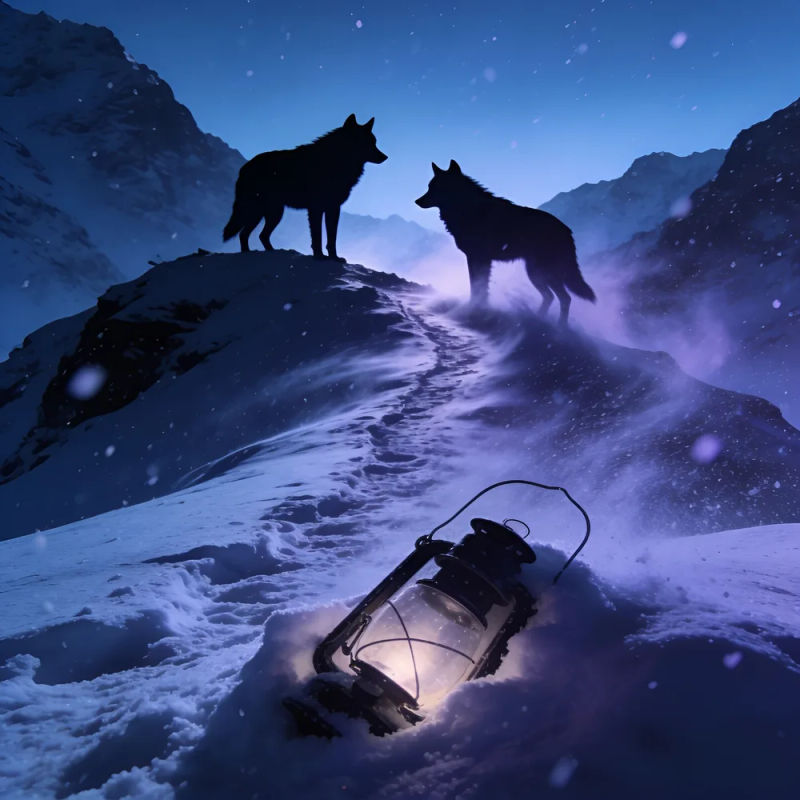
蓝调时刻的雪岭上有两只狼,雪地里放着一盏提灯
游戏场景
[Snowy mountain pass, howling wind, tense low strings.] Scout (urgent whisper): "Wolves. Two of them. Don't move." [0:06] A low growl, close by.
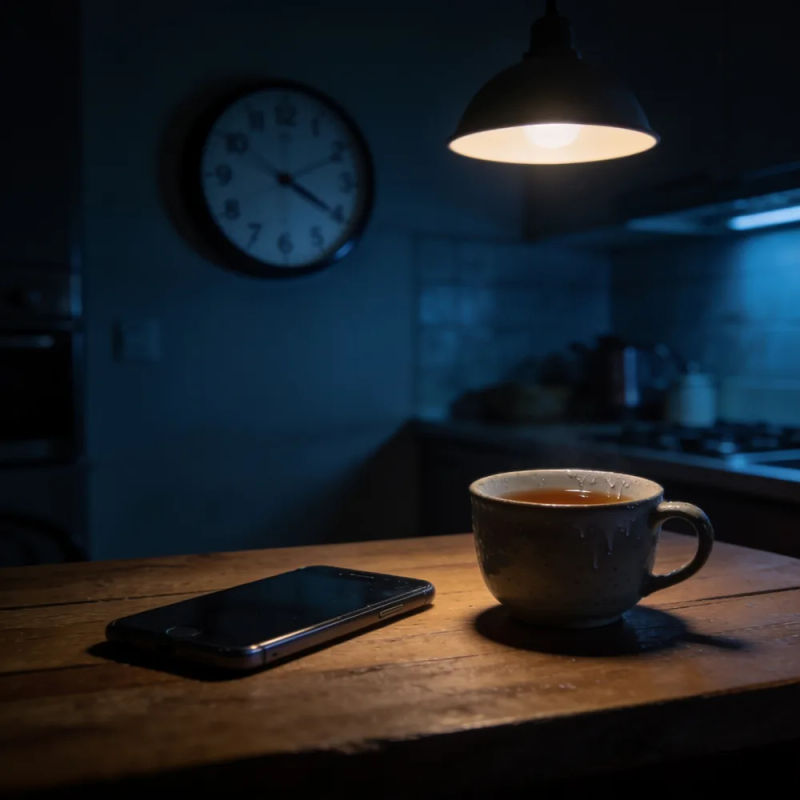
夜里昏暗的厨房,墙上挂着钟,手机屏幕朝下,旁边是一杯凉掉的茶
短剧
[Kitchen, late evening, a clock ticks, soft piano.] Mother (quiet, hurt): "You didn't call." Son (defensive, then soft): "I was busy, Mom, I... I know. I'm sorry."
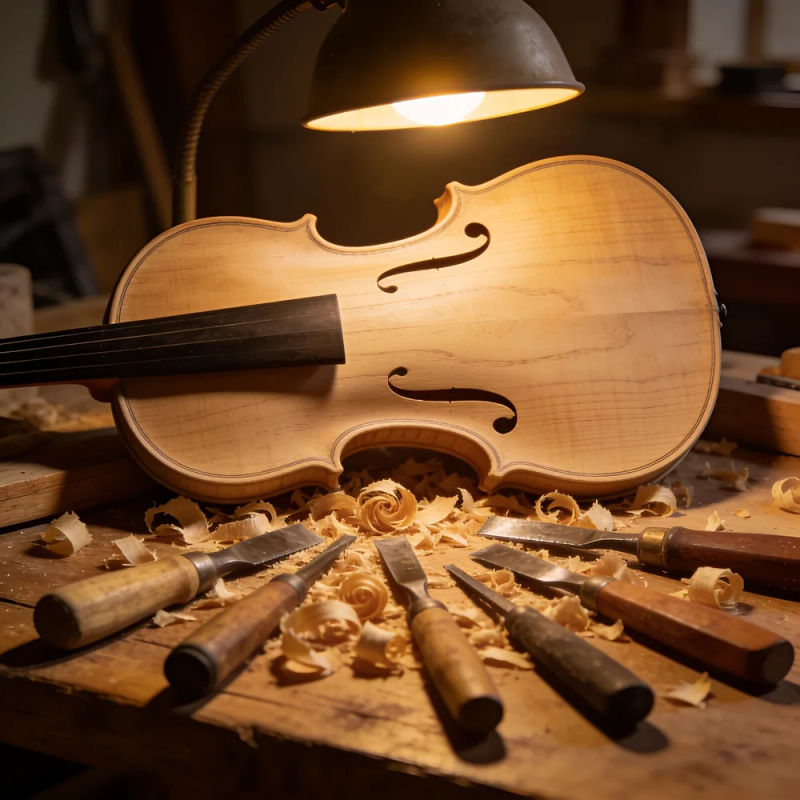
工作台上一把未完成的小提琴琴身,旁边是雕刻工具和木屑
手作纪录片
[Workshop at night, a lamp hums, a chisel shaves wood, a solo violin far off.] Narrator (warm, hushed): "Every violin starts as a block of spruce... and a lot of patience."
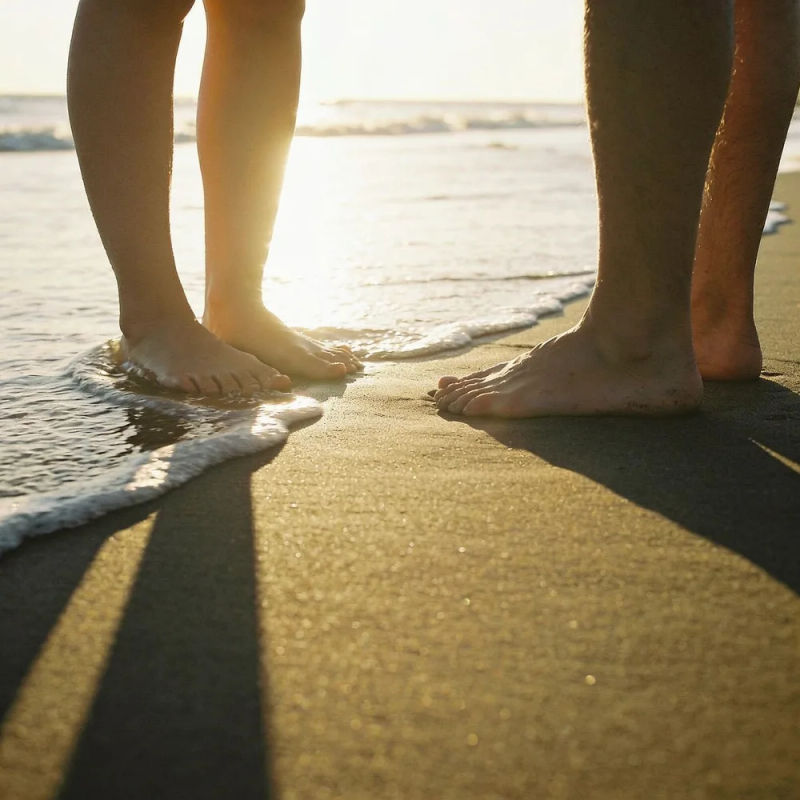
日落时分,两双赤脚踩在湿沙上,海浪正在退去
巴西葡萄牙语
[Beach at sunset, gentle waves, soft bossa nova guitar.] Narrator (relaxed, warm, Brazilian Portuguese): "O sol já está indo embora... fica mais um pouco."

核心功能

三步生成场景音频

  1. 01

    打开 Morphic

    注册后,就能在可自由延展的无限 Canvas 上开始创作。

  2. 02

    写下场景

    写明地点,选好声音,再写台词。手头有声音参考或视频的话,可以一并加上。

  3. 03

    生成,再按轨道修改

    对白、环境音、音效和配乐分开返回。只改其中一层,其余的原样保留。

Seed Audio 1.5 能生成什么

一句提示词,一整个场景

人声、环境音、音效和配乐一起返回,比例已经配好。咖啡馆、暴风雨、体育场,听起来是一个真实的地方,而不是静音画面上的一条人声。
琥珀色、银色和青绿色三条半透明声波汇成一个形体

跟着画面走的配音

放入一段成片,Seed Audio 1.5 会按画面动作写出配音、配乐和音效。也可以把对白翻成另一种语言,原来的配乐和音效保持不变。
一个发光的矩形光框,下沿向外荡出波纹

分轨输出,方便剪辑

对白、环境音、音效和配乐各占一轨返回。想压低配乐、静音某个音效,或只换一句台词,其余部分都不用动。
琥珀色、青绿色、银色和玫瑰色四条发光玻璃片在薄雾中分开悬浮

六分钟的完整场景

一场戏、一段播客或一章旁白解说,一次生成就能装下,最多可以用参考音频指定六个声音。
一道柔和的光线延伸向纵深,像一条缓慢的声波地平线

全部在 Morphic

您的完整音频工具集

简单定价

今天就免费开始,随时可以升级或取消。

Basic

$19/ 月
账单金额为 $0 每年

2400 每月 信用

1 个用户

所有模型

工作流

Standard

$24/ 月
账单金额为 $0 每年

3625 每月 信用

1 个用户

所有模型

工作流

Pro

$45/ 月
账单金额为 $0 每年

6350 共享 每月 信用

1 用户

+ 最多 4 人额外付费可增加

所有模型

工作流

Max

$170/ 月
账单金额为 $0 每年

24650 共享 每月 信用

1 用户

+ 最多 9 人额外付费可增加

所有模型

工作流

Enterprise

更高的限制

自定义

定价和账单条款

大容量信用
自定义席位限制
所有模型
工作流
Pricing Gradient

Free

供随意体验

$0

永久免费

最多 20 积分
仅1个用户
部分模型
工作流

常见问题

Seed Audio 1.5 AI音频生成器免费吗?
Morphic 有免费套餐,注册后不用付费就能开始做音频。Seed Audio 1.5 上线后,和其他音频模型一样消耗积分。付费套餐的积分更多,适合更长的场景。
Seed Audio 1.5 什么时候上线 Morphic?
Seed Audio 1.5 即将上线。在此之前,Morphic 上已有 Seed Audio 1.0,可以做完整场景,旁边还有 ElevenLabs 和 Lyria。本页的示例都是在 Morphic 上做的:人声和音效来自 ElevenLabs,音乐来自 Lyria,再混成完整场景。
Seed Audio 1.5 AI音频生成器是什么?
这是 ByteDance 推出的 Seed Audio 1.5 整场景音频模型。一段提示词就能返回对白、配乐、环境音和音效,各自成轨,最长六分钟。再放入一段视频,声音会跟着成片走,用于配音和音效设计。
Seed Audio 1.5 能做中文配音吗?
按模型页的说明,Seed Audio 1.5 覆盖 30 种语言,中文在内。上线后,短视频口播、短剧对白这类内容,写好台词、选好声音就能生成。完整的语言名单请看模型页。
Seed Audio 1.5 的分轨怎么用?
Seed Audio 1.5 把对白、环境音、音效和配乐分成各自的轨道返回,而不是一个混好的文件,对白还可以按人声拆开。想压低某一层、静音,或只换一句台词,都不用重新生成整个场景。
Seed Audio 1.5 能给视频配音吗?
可以。放入一段视频,模型会写出跟着画面走的配音、配乐、音效和环境音。也可以把对白翻成另一种语言,同时保留原来的音效和配乐。发布前,请让熟悉该语言的人审听一遍。
Seed Audio 1.5 一次最长能生成多久?
一次最长六分钟,是 Seed Audio 1.0 两分钟上限的三倍。一场完整的戏、一段播客或一章旁白解说,一次就能生成。
Seed Audio 1.5 可以克隆声音吗?
您最多可以添加六段参考音频来指定场景里的声音,前提是您拥有这些声音的使用权。ByteDance 的限制会阻止未经本人许可模仿真人的声音。

你可能也喜欢